

💡 站外导读:在海量电商场景中,传统的“向量检索+多路倒排+多级重排”漏斗式架构正遭遇算力开销暴涨与语义割裂的瓶颈。全球电商巨头 Shopify 正式披露其生产级“生成式商品发现模型(Generative Discovery Model)”架构设计。该系统彻底打通搜索(Search)与个性化推荐(Recommendation)的底层边界,创新性地采用残差量化 K 均值聚类(RQ-KMeans)将数十亿商品映射为仅有 3 个 Token 的紧凑语义 ID,并搭载 Liquid AI 的 LFM2-2.6B 高性能模型。结合 GPU 前缀树(Prefix Trie)约束解码,Shopify 成功将候选召回时延从 50ms 极限压缩至约 1ms,在 Shop App 首页信息流与全球数百万独立站检索中斩获了显著的转化与召回提升。
当两位消费者在手机端输入同一个检索词“backpack(背包)”时,一个可能刚刚经历过公交车打翻咖啡弄湿电脑的意外,迫切需要一款防水防震的商务通勤电脑包;而另一个可能正在筹划穿越科罗拉多落基山脉的探险,寻找大容量轻量化户外登山包。在传统的检索系统中,字面匹配或无差别的稠密向量往往无法精准解构这种潜藏在用户历史消费行为与即时意图之下的深层差异。
面对全球数百万商家、跨越数十亿 SKU 的复杂商品目录,Shopify 工程团队构建了一套统一的生成式商品发现底座。该架构摒弃了传统将商品作为离散无关联 ID 的“黑盒映射”,而是将“理解商品语义”与“预测下一个合适商品”转化为大语言模型的生成任务。目前,该模型已在生产环境全量承载线上流量,带来了显著的离线召回率与在线商业转化增益。
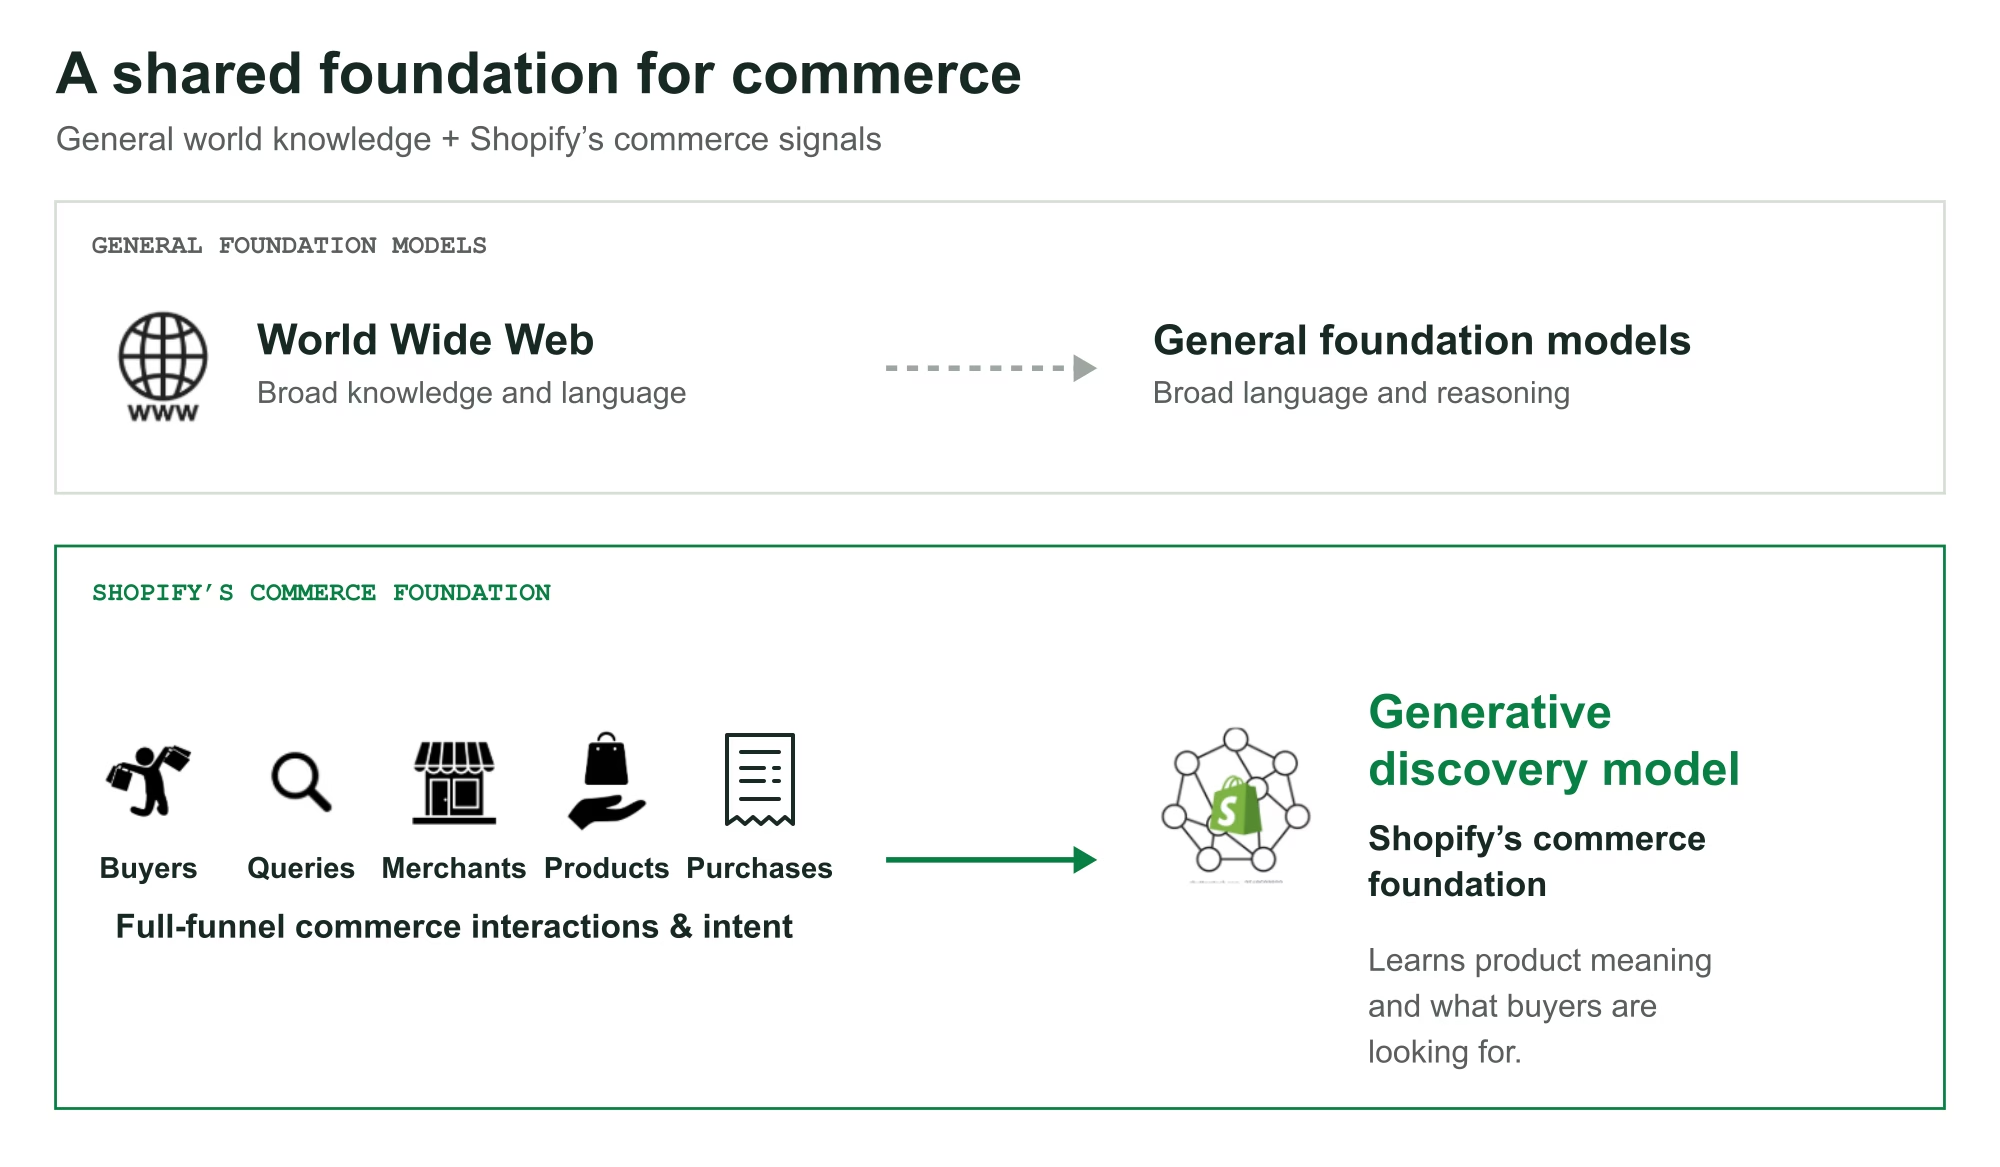
一、破局核心:用 3-Token 语义 ID 破解数十亿商品“词表爆炸”
在传统的电商机器学习系统中,每个商品通常拥有一个唯一的数据库记录标识(Raw Product ID)。然而,数字 ID 本身不包含任何物理属性与语义信息。如果将目录中数十亿的商品逐一作为模型的输出词表,不仅会导致 Softmax 输出层参数规模膨胀至不可承受,而且对于长尾或冷启动新品而言,交互样本稀疏导致模型根本无法为独立 ID 学到有效的表征。
为此,Shopify 创新性地构建了语义 ID(Semantic ID)分词体系:
- 内容向量化:首先将商品的标题、类目层级、属性描述及视觉特征输入统一编码器,生成高质量稠密向量表征。
- RQ-KMeans 残差量化:在评估了残差量化自编码器(RQ-VAE)与残差 K 均值聚类(RQ-KMeans)后,团队发现在相同码本容量下 RQ-KMeans 的下游召回指标显著更优。系统配置了 3 级码本,每级码本包含 8,192 个聚类中心(Centroids)。
- 3-Token 层次编码:每一个商品被压缩为一个由 3 个离散编码组成的序列(如
[6001, 5561, 0])。第一级 Token[6001]代表通用大类(如所有马甲与背心款式);第二级[6001, 5561]细化为带填充保暖马甲;第三级[6001, 5561, 0]则精准指向灰色保暖马甲。
这种分层编码使得共享前缀的相近商品能够天然共享模型注意力与训练梯度,长尾冷门商品通过继承同类高频商品的知识,彻底化解了电商冷启动表征难题。
二、推理加速突破:GPU 前缀树约束解码将延迟从 50ms 压至 1ms
在生成式检索(Generative Retrieval)落地工业界的过程中,最大的拦路虎往往是自回归解码的延迟与非合法 Token 序列幻觉。3 级码本共有 8192^3 种理论组合,但只有极小一部分对应真实在售商品。若模型输出了不存在的序列,或者花费数十毫秒进行 Beam Search,将直接超出电商实时网关的 SLA 预算。
Shopify 工程团队通过三大工程底座解决了这一挑战:
1. Liquid AI LFM2-2.6B 底座选型
在候选生成阶段,必须为下游复杂的精排模型预留足够的计算时间。团队对多种开源权重进行了深度横向基准测试,最终选定 Liquid AI 的 LFM2-2.6B 模型。该模型在保持高泛化语义理解能力的同时,推理吞吐与显存占用表现极其优异,并深度集成了 RIPL 推理栈与定制化 TensorRT-LLM 算子引擎。
2. GPU 前缀树(Prefix Trie)约束解码
为了保证生成的 Semantic ID 必定对应在售商品,系统基于 STATIC 架构将数十亿商品的有效路径编译为常驻 GPU 显存的稀疏前缀树。在解码每一步,由定制的 CUDA/C++ 插件拦截 Logits,通过向量化位运算直接掩码(Mask)非法分支。该优化将单次请求的路径约束开销从超过 50ms 骤降至约 1ms。
3. 多 Token 联合预测(Multi-Token Prediction, MTP)
传统自回归需要 3 步串行推理才能生成一个商品,Shopify 实装了 MTP 技术,在前向传播中单 Pass 直接输出全部 3 个位置的联合概率分布,并配合轻量级重排器(Lightweight Ranker)筛选,在同等甚至更低的 p95 时延下使有效候选吞吐量实现了数倍跃升。
三、核心架构与实测基准全景对比
为了直观展现 Shopify 生成式商品发现模型与传统双塔稠密召回及纯文本自回归方案的差异,我们将关键技术指标与工业实测表现整理如下:
| 对比维度 | 传统双塔稠密检索 (Two-Tower DSSM) | 大模型自回归文本直出 (Vanilla LLM) | Shopify 生成式发现架构 (LFM2-2.6B + RQ-KMeans) |
|---|---|---|---|
| 商品表征形式 | 连续高维向量 (768d / 1024d) | 商品完整文本标题 / 离散字符串 | 3-Token 分层语义 ID (8192^3 Codebook) |
| 冷门商品泛化 | 依赖特征泛化,向量易坍缩至原点 | 幻觉高,难以准确锁定库存真实 SKU | 共享前缀层级表征,冷启动自动继承集群先验 |
| 单次约束解码延迟 | 无约束解码(ANN 检索耗时约 8-15ms) | CPU 前缀校验或事后过滤,耗时 > 50ms | GPU Trie 稀疏索引掩码,耗时压缩至 ~1ms |
| 搜索质量指标 (OneDCG@10) | 基准对照 (Baseline) | 长文本生成抖动,Top10 一致性难以保障 | 整体净增 +2.1,登录个性化场景大幅提升 +2.7 |
| 搜推一体协同 | 搜推双模型完全割裂,特征难以跨域对齐 | 通用 Prompt 统一,但难以承载高并发 | 多教师知识蒸馏(Search/Rec Experts -> Shared Student) |
四、多教师蒸馏与首单发现强化:让搜推任务在同一底座相互增益
在模型训练方面,Shopify 揭示了四条至关重要的工程经验:
- 搜推跨域互哺:实验证实,从训练集中剥离搜索或推荐任何一方的数据,都会导致另一方的评测指标显著下滑。搜索查询注入了明确的用户意图锚点,而浏览和加购行为则提供了丰富的上下文联想,两者联合微调使得模型表征更加鲁棒。
- 定向激活“探索发现(Discovery)”:纯粹拟合历史日志会导致模型过度推荐用户曾经购买过的店铺或熟知商品。Shopify 针对“用户首购事件(First-Purchase)”进行了过采样(Upsampling),同时清洗掉冗余的历史无意义点击,使模型在“非熟人探索”维度的有效召回率飙升了 10%~15%。
- 大模型打分奖励强化学习:利用高质量 LLM 充当离线 Relevance Judge 奖励模型,将传统的“Next Token 交叉熵拟合”升级为强化学习策略优化,使最终输出的 Top-K 结果直接对齐用户综合满意度,为 OneDCG@10 带来了额外 +1.5 的提升。
- 多教师蒸馏(Multi-Teacher Distillation):先由专有分支分别精调出“搜索专家”与“推荐专家”,再将其知识综合蒸馏进单一的共享端侧底座,既保障了专精能力的拔尖,又实现了线上统一服务维护。
📝 站长洞察 (Editor’s Insight)
Shopify 此次开源公开的生成式商品发现技术路线,为整个电商与搜索推荐工业界指明了“后向量时代”的演进方向。长期以来,双塔模型与向量近邻检索(ANN)统治了召回层,但它在本质上面临“多峰分布映射坍缩”与“多模态长尾泛化失真”的硬伤。Shopify 证明了:不需要把几百亿参数的通用大模型直接摆上在线高并发推理的第一线,而是选用专精轻量模型(Liquid 2.6B)结合高密度的 3-Token 语义 ID,辅以常驻 GPU 的 Trie 约束剪枝,就能在毫秒级严苛 SLA 下跑通“生成式召回”。这种利用语义离散码解决词表爆炸、利用软硬件协同解决约束推理延迟的设计哲学,不仅适用于电商商品召回,对未来的 Agentic 代码库索引、私有知识图谱寻址同样具有极高的架构借鉴意义。
Shopify的生成式商品发现模型核心是什么?
核心是把商品检索与推荐统一为生成任务:先用RQ-KMeans把商品压缩成3-Token语义ID,再用大模型生成合法商品路径,并通过GPU前缀树约束解码保证输出一定对应在售商品。
RQ-KMeans为什么比RQ-VAE更适合商品编码?
文中提到,在相同码本容量下,RQ-KMeans的下游召回指标更优。它用分层聚类把相近商品共享前缀,既利于长尾商品继承高频商品知识,也更适合大规模商品目录的检索与召回。
为什么Shopify能把召回延迟压到1毫秒?
关键在于三点:选用推理效率高的Liquid AI LFM2-2.6B底座、把有效路径编译成常驻GPU显存的前缀树、再用MTP一次输出3个Token,减少串行解码与非法分支搜索开销。
RQ-KMeans离散编码怎么落地到商品库?
先用商品标题、类目、属性、行为等多模态特征训练离散码本,再把每个商品映射成固定长度语义ID。落地时要重点控制码本更新频率、长尾商品覆盖率和在线增量编码,否则离线效果好,线上会迅速漂移。
1毫秒级检索如何兼顾召回质量?
核心是把“重计算”前移到离线,在线只做前缀约束解码和极小范围重排。实践中要配合GPU前缀树、缓存热门路径、分层召回与兜底规则,避免极致低延迟牺牲多样性和新商品曝光。


