

💡 站外导读:随着大语言模型从单次问答向能够自主规划、操控电脑与编排复杂工作流的自主智能体(Agentic AI)全面演进,调用成本与推理吞吐速度成为决定商业落地的生死线。传统大模型在应对数十轮甚至上百轮的长程智能体循环时,往往因为高昂的 Token 费用与秒级延迟导致交互体验崩溃。国内知名大模型独角兽 MiniMax 于 10 月 19 日正式发布新一代轻量旗舰模型 M3.1Flash(此前代号 Space Bunny,匿名累计吞吐超 200T Token)。该模型凭借激进的稀疏注意力架构设计,实现了推理吞吐提速近 3 倍、综合成本锐减 70% 的技术飞跃,更在权威评测 OSWorld V2 与 Agents’ Last Exam 中双双斩获国产模型第一名,树立了极致性价比的全新范式。
1. 破除 Agent 成本枷锁:M3.1Flash 的战略定位与匿名实战验证
在当前企业级 Agent 与代码助手的落地场景中,开发者面临着残酷的“不可能三角”:追求顶级推理智能往往意味着动辄数十倍的调用资费与缓慢的流式输出;而普通的轻量模型又在长程多步骤工具调用、复杂格式对齐与反思纠错中频繁发生逻辑漂移。
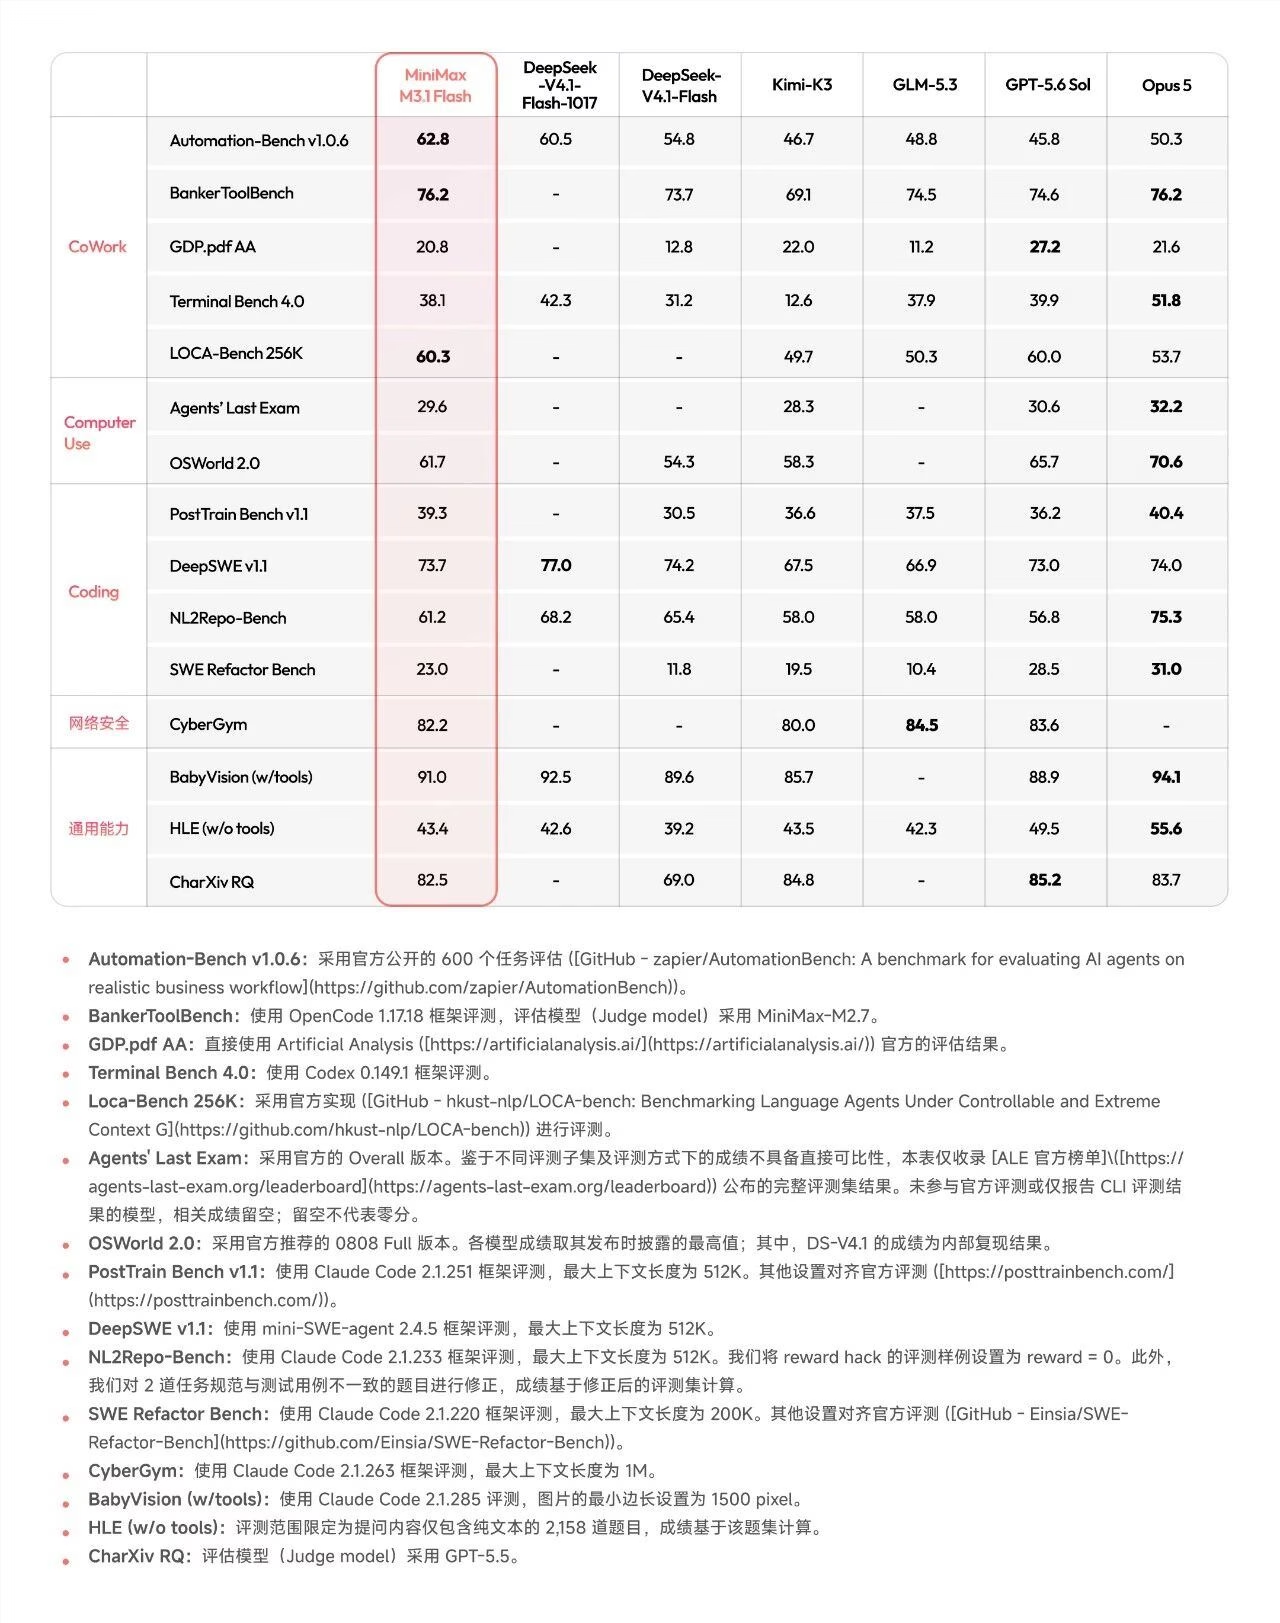
MiniMax 此次推出的 M3.1Flash 正是瞄准这一结构性矛盾而生的重磅产品。在正式公布前,该模型曾以匿名代号“Space Bunny”在开发者社区与高并发生产环境中静默公测,累计处理了超过 200T Token 的真实海量复杂业务请求。经过全球开发者的匿名极限压测,该模型在 Agentic 任务执行、真实软件工程、电脑桌面操控(Computer Use)以及自动化网络安全攻防等四大硬核领域展现出了令人惊艳的代际跨越。
2. 激进稀疏注意力加持:200+ TPS 极速推理架构拆解
能够实现“速度提升近 3 倍、成本降低 70%”,核心在于 MiniMax 研发团队在模型底层注意力机制上的大胆革新:
- 动态稀疏注意力机制(Sparse Attention):不同于传统全量自注意力对整个序列每个 Token 的无差别计算,M3.1Flash 引入了细粒度稀疏寻址算法,在高并发多轮对话中自动剪除无效注意力关联,将 KV Cache 显存占用与显存带宽消耗压缩至极致;
- 超高流式吞吐:在日常通用问答与代码补全场景中,线上流式生成速度可达 200+ TPS(每秒 Token 数),即使在极度严苛的高并发生产负载下,中位数 P50 响应速度依然稳定在 170+ TPS 以上;
- 极致的 Prompt Cache 优化:针对长系统提示词与连续多轮 Agent 对话,官方大幅增强了服务端上下文缓存命中率,使冷启动首包延迟压进毫秒级。
3. Computer Use 与桌面接管领跑:OSWorld V2 与 ALE 双登国产顶峰
对于新一代智能体而言,在真实的操作系统中看懂屏幕、移动鼠标、填写表单并完成跨软件协同是终极考验。M3.1Flash 在两项极具含金量的世界级基准测试中创下国产最佳战绩:
- OSWorld V2 斩获 61.7 分(国产第一):该评测要求模型在真实的 Ubuntu 桌面环境中,跨越 LibreOffice、GIMP、VSCode 等真实办公桌面软件完成复杂自然语言指令。M3.1Flash 凭借精准的视觉定位与稳健的键鼠操作编排,斩获国产模型第一名;
- Agents’ Last Exam (ALE) 斩获 29.6 分(国产第一):作为考验智能体极端极限推理与长程纠错的殿堂级评测,该得分确立了其在长程规划层面的统治力;
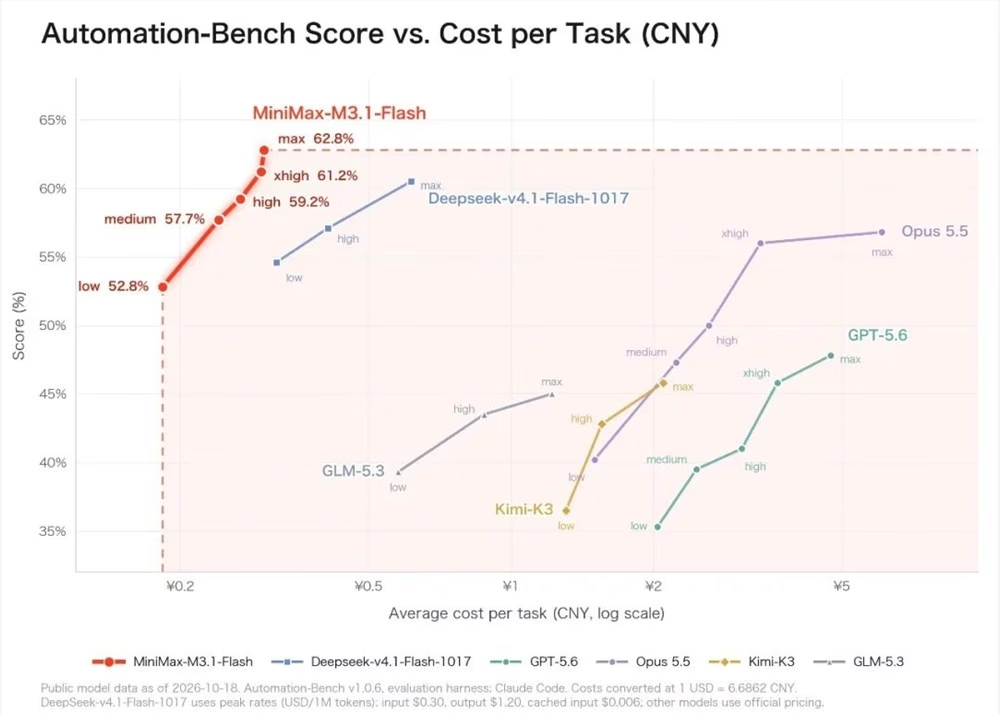
- AutomationBench-AA 领跑全行业:能够端到端跨越 CRM、ERP 等 SaaS 系统,自主闭环跑通销售线索分配、财务账单核对、营销文案分发与 HR 简历筛选等复杂的真实企业工作流。
4. 全面超越同侪:DeepSWE 编程与网络安全基准深度透析
在严肃的代码工程与安全渗透场景,M3.1Flash 同样交出了亮眼的成绩单:
在权威软件工程评测 DeepSWE v1.1 中,该模型取得了 73.7% 的高分,逼近国际顶尖旗舰模型。该基准要求模型在没有任何人工干预的情况下,独立克隆大型 GitHub 仓库、精准定位 Bug 原因、编写功能实现并跑通全量单元测试与回归校验。在网络安全方向,M3.1Flash 在 CyberGym 基准中斩获 82%,在源代码安全审计、动态渗透测试排查与逆向工程分析中表现极其干练,具备自动化辅助 SOC 安全运维人员挖掘 0day 隐患的硬核实力。
5. 价格屠夫登场:输入仅 1 元、缓存读取 0.1 元的降维打击
在定价维度,MiniMax 延续了 Flash 档位“以极致效率打通规模化普惠”的产品哲学,将使用门槛拉低至行业冰点:
| 计费与性能维度 | MiniMax M3.1Flash 实测指标 | 行业同类 Flash 模型均值 |
|---|---|---|
| 输入 Token 资费 | ¥1.00 / 百万 Token (1元/M) | ¥2.00 ~ ¥4.00 / 百万 Token |
| 输出 Token 资费 | ¥4.00 / 百万 Token (4元/M) | ¥8.00 ~ ¥16.00 / 百万 Token |
| 上下文缓存读取 (Cache Read) | ¥0.10 / 百万 Token (1毛钱/M) | ¥0.50 ~ ¥1.00 / 百万 Token |
| 日常输出吞吐速度 | 200+ TPS (P50 稳定 170+ TPS) | 60 ~ 100 TPS |
| OSWorld V2 电脑接管得分 | 61.7 (国产大模型全量第一名) | 45.0 ~ 54.0 |
📝 站长洞察 (Editor’s Insight)
MiniMax M3.1Flash 的问世,深刻揭示了当下大模型产业的残酷分水岭:单纯在通用 Benchmark 上刷榜的虚假繁荣已经结束,工业界需要的是能够在真实企业业务中“算得起账、跑得出速度”的实干型基座。在复杂的自主智能体(Agent)循环中,一个任务往往需要长上下文反复提示数万 Token,传统旗舰模型高昂的账单使得绝大多数商业落地成为泡影。M3.1Flash 将输入价格压至 1 元/M、缓存命中压至 1 毛/M,同时飙出 200+ TPS 的惊人速度,并一举夺得 OSWorld V2 国产第一,这意味着高频度的桌面接管与实时业务流编排终于具备了规模化盈利的商业可行性。这种把工程效率压榨到极限的 Flash 模型,正在成为整个 AI 生产力时代最不可或缺的基石。


