

💡 站外导读:数日前,一个代号为“Space Bunny(太空兔)”的匿名大模型在各大开源竞技场与 OpenRouter 调用榜上悄然登顶,以超高速的响应、惊艳的代码长程交付与端到端系统级任务执行引发全球极客圈疯狂猜测。如今谜底正式揭晓:该模型正是国产大模型独角兽 MiniMax 全新推出的 M3.1 Flash,且官方已宣布全量开源模型权重并上线 API、MPlan 与 MiniMax Code。在 200+ TPS 极速推理与激进稀疏注意力架构的加持下,该模型不仅拿下 DeepSWE 73.7%,更在 OSWorld V2 以 61.7 分夺得国产 Computer Use 双榜第一。本文全景拆解其技术架构、基准实测与企业落地路径。
一、“太空兔”真身公布:累计处理超 200T Token 的高能底座
在过去的半个月里,OpenRouter 与 LMSYS 竞技场上频繁出现一个名为 Space Bunny(太空兔) 的神秘匿名模型。在没有官方宣发、没有背景背书的情况下,该模型凭借极高吞吐的流式吐字速度、极低的首字延迟以及丝滑的编码补全体验迅速蹿升至调用榜前列,成为开源社区热议的技术悬案。
如今 MiniMax 正式官宣掀开面纱:该模型即为其新一代主力推理模型 MiniMax M3.1 Flash。在大规模预训练与强化学习阶段,该架构已在生产环境中经受了超过 200T Token 真实生产数据的洗礼。为了推动全球开发者生态繁荣,MiniMax 做出了极具魄力的决策:全量开源 M3.1 Flash 的模型权重(首发同步上线 HuggingFace),并在开放平台上线高并发 API、高性价比 MPlan 订阅制以及桌面级编程智能体工具 MiniMax Code。
二、激进稀疏注意力架构:突破速度与性能矛盾的底层解题逻辑
传统 Dense 大模型在扩展上下文长度时,Self-Attention 机制的计算复杂度与显存占用呈二次方级暴涨,极大地限制了单卡吞吐量与推理速度。MiniMax M3.1 Flash 的核心技术杀手锏,在于其引入了更为激进的稀疏注意力机制(Radical Sparse Attention Architecture):
- 动态注意力剪枝与冗余剔除:在保证模型对数万 Token 超长上下文逻辑连贯性的前提下,底层计算单元动态识别并跳过大量无关 Key-Value 向量交互,将注意力算力精准收敛至核心逻辑分支。
- 工业级 200+ TPS 极速输出:得益于稀疏注意力的算力释放,M3.1 Flash 的日常生产环境输出速度达到了 200+ Tokens/秒,即便在高并发重载下,P50 中位数延迟依然稳固在 170+ TPS,较上一代主力模型实现了近 3 倍的跨越式提速。
- 推理边际成本击穿底线:计算开销的大幅缩减使得模型单位 Token 的推理成本断崖式下跌,让需要成百上千次内部调用循环的自主 Agentic 工作流在经济层面上真正变得可行。
三、核心评测基准硬核实测:从代码工程到真实系统操控
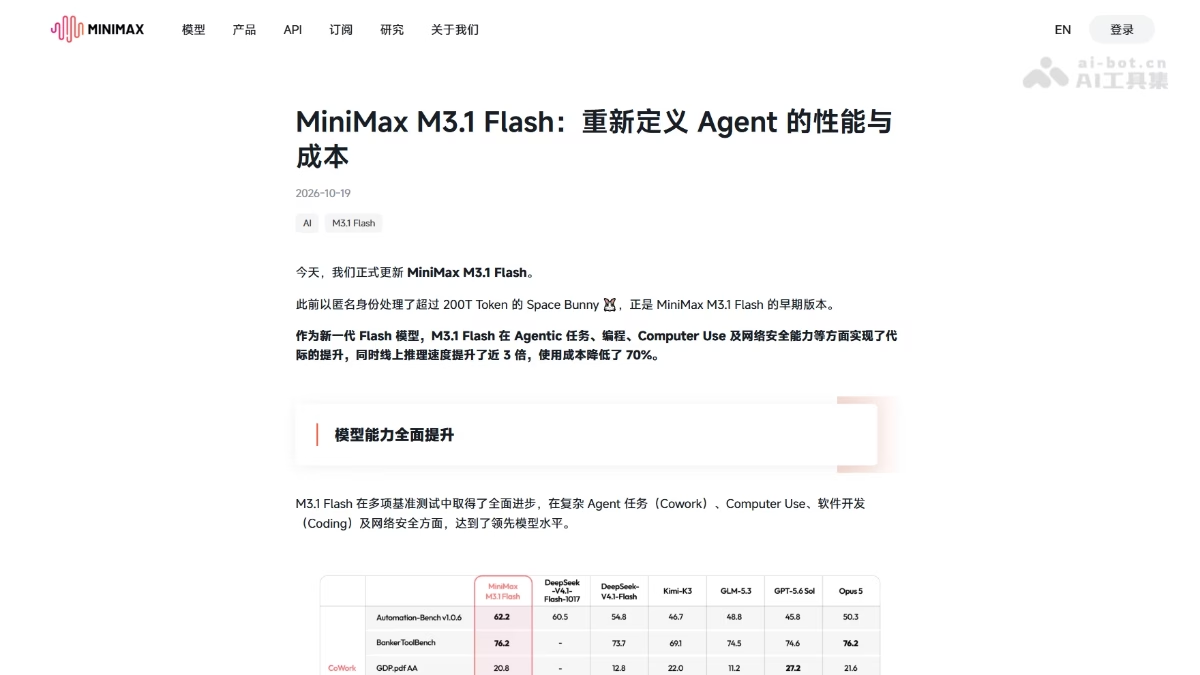
在反映大模型实际解决生产问题能力的多个权威评测基准上,MiniMax M3.1 Flash 交出了一份超越多数闭源旗舰的惊艳答卷:
| 权威评测基准 | M3.1 Flash 得分 | 行业定位与技术含金量 |
|---|---|---|
| DeepSWE v1.1 (软件工程) | 73.7% | 具备独立完成复杂代码库理解、Bug 修复与自动化测试全流程闭环能力 |
| OSWorld V2 (系统操控) | 61.7 分 | 国产模型第一名,跨桌面软件、浏览器与终端自主执行完整交付任务 |
| ALE (复杂动作执行) | 29.6 分 | 国产模型第一名,精准感知屏幕像素与操作状态,容错率显著提升 |
| CyberGym (网络安全) | 82% | 涵盖自动化漏洞挖掘、代码安全审计与防御性补丁生成 |
| BankerToolBench (金融多工具) | 76.2 分 | 擅长数十步工具链协同与跨文档数据一致性高保真校验 |
四、从单点问答走向 Computer Use 数字员工时代
MiniMax M3.1 Flash 最值得关注的演进方向,是其实现了对真实操作系统物理环境的深层次感知与代行操作(Computer Use)。模型不仅仅停留在生成一段代码或返回一个文本回答,而是通过结合视觉多模态与系统级控制接口,直接操作键盘鼠标、跨越多个 SaaS 软件自动完成日常流程:
例如在企业销售与财务审批链路中,模型能够自主打开 CRM 获取商机线索、登录 ERP 录入合同信息、调取邮件核验对账单,并在遇到异常阻断时自主触发回退与重试机制。这一能力的成熟,标志着基于 M3.1 Flash 的全自主“数字员工”正加速从科幻走向商业化普及。
📝 站长洞察 (Editor’s Insight)
“快”在过去往往被视为模型能力的妥协产物,甚至在业界的传统观念中,高 TPS 往往意味着推理逻辑的粗糙与代码生成深度的退化。然而 MiniMax M3.1 Flash 的实测表现彻底粉碎了这一刻板印象——在保持 200+ TPS 工业级极限吐字速度的同时,在 DeepSWE 软件工程自动化基准上依然砍下 73.7% 的极高战绩。这背后的核心启示在于:随着 Agentic 工作流在多步骤规划与自我反思(Reflection)循环中的调用次数成倍攀升,单次推理延迟(Latency)已成为制约智能体整体任务交付时间的物理瓶颈。M3.1 Flash 凭借极低成本与高吞吐的稀疏注意力底座,让复杂智能体能够无所顾忌地进行多轮草稿试错与多工具链试探,真正推动 AI 从“高冷慢速的参谋”降维转变为“敏捷高频的数字工蜂”。


