

💡 站外导读:在生成式 AI 与大模型狂飙突进的背后,算力基础设施长期深陷英伟达 CUDA 护城河的强力生态锁定之中。由于主流框架算子与硬件底层底层编译高度耦合,企业若想将训练集群迁移至成本更低的非英伟达 ASIC 芯片,往往需要付出漫长的代码重写与算法算子适配代价。在加州圣何塞举办的北美 PyTorch 大会上,亚马逊正式宣布开源自研深度学习编译套件 TorchNeuron。该工具直击“无缝迁移”痛点:开发者现有的 PyTorch 训练脚本无需重写任何算法逻辑,仅需变更一行芯片配置参数,即可直接在亚马逊自研 Trainium 算力芯片上满血运行,向异构算力自由迈出了决定性一步。
1. 击穿 CUDA 护城河:大模型算力迁移之痛与亚马逊破局之道
在大模型算力竞赛进入下半场的今天,算力成本(TCO)与硬件可用性已成为悬在每一家 AI 企业头顶的达摩克利斯之剑。尽管英伟达凭借出色的 GPU 硬件和十余年积累的 CUDA 生态垄断了全球 AI 训练市场,但昂贵的采购单价、居高不下的供货周期与高功耗,正迫使各大云服务巨头加速研制自主可控的 AI 专用加速芯片(ASIC)。
然而,硬件做出来只是第一步,生态软件栈才是最难逾越的鸿沟。PyTorch 作为 Meta 主导、全球超 80% AI 研究员与工程师首选的深度学习框架,其大量高级算子深度绑定了 CUDA 的特定 API。以往企业尝试换用其他芯片时,往往面临数月的手工算子改写、数值精度漂移排查以及周边调试工具链失效的巨大阵痛。亚马逊开源 TorchNeuron 的使命,正是要从根源上消除这一“换芯壁垒”。
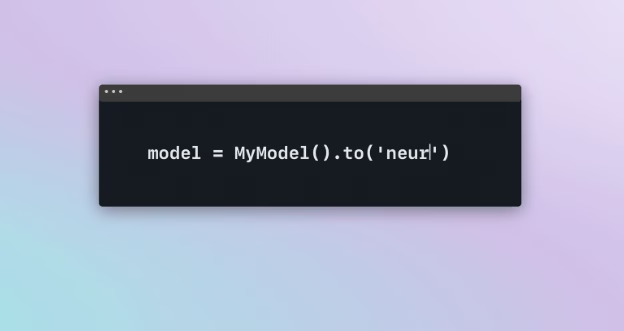
2. 什么是 TorchNeuron?“改一处配置”背后的计算图编译机理
TorchNeuron 的核心技术精髓在于其强大的 PyTorch 原生图捕获与即时编译(JIT Compilation)引擎。它没有强制开发者学习任何私有语法,而是通过与 PyTorch 2.x 的 torch.compile 机制深度集成:
- 自动计算图下沉与算子融合:在运行时,TorchNeuron 会拦截 PyTorch 的计算图,自动将高层算子切分并重写为 Trainium 芯片专属的硬件微码,同时执行激进的算子融合(Operator Fusion)与显存重排;
- 配置行级透明接管:开发者在训练脚本中,仅需将设备指定参数由传统的
cuda声明为neuron,底层的通讯库、分布式数据并行(DDP)与张量并行即可自动桥接至 AWS 自研的 NeuronLink 高速互联网络; - 完整生态工具链复用:开发者日常用于模型性能剖析的 TensorBoard、分布式检查点保存、权重转换工具无需任何修改,实现了对现有研发资产的 100% 继承。
3. 严谨实测验证:数值精度收敛与学习速度双重对齐
为了粉碎外界对非 CUDA 芯片“精度不稳定、收敛慢”的刻板印象,亚马逊核心工程师在发布现场展示了严密的物理对比测试。使用完全相同的基准模型与数据集,分别在标准英伟达集群与搭载 Trainium 的 AWS 实例上进行多节点全参数预训练:
实测结果显示,两条训练曲线的 Loss 下降轨迹、梯度的数值精度收敛特性与最终评测得分呈现出 100% 严密对齐,同时单步迭代的计算时延与吞吐完全达到预期指标。这意味着开发者不仅可以放心地将测试与调试环境平移到 Trainium 上,更能无后顾之忧地开启万卡级大规模生产训练。
4. 从私有闭环走向社区原生:推动 PyTorch 上游“硬件无关化”
更值得行业瞩目的是,亚马逊并未将 TorchNeuron 作为一个孤立的闭源商业插件来运营,而是选择在北美 PyTorch 大会上以标准的开源许可证完全开放给全球开发者。更进一步,亚马逊正以核心贡献者的身份积极深度融入 PyTorch 上游代码库:
亚马逊工程师正在与 Meta 及开源社区紧密协同,物理移除 PyTorch 核心库中那些历史遗留下来的、强制绑定特定 GPU 厂商指令集的硬编码逻辑,合力推进 PyTorch 架构走向彻底的 “硬件无关(Hardware Agnostic)”。这一举措不仅赋能了 AWS 自家的 Trainium 芯片,也为整个开源半导体生态打通了标准的接入规范。
5. 传统 GPU 方案 vs AWS Trainium (TorchNeuron) 全方位对比
为了让架构师与 SRE 运维人员更直观地评估架构迁移收益,下表总结了两大技术路径的关键指标差异:
| 评估维度 | 传统 GPU + CUDA 架构 | AWS Trainium + TorchNeuron |
|---|---|---|
| 代码迁移成本 | 原生支持,无需改动 | 代码零重写,仅改一行芯片设备配置 |
| 编译与运行方式 | NVCC / Triton 编译 | TorchNeuron JIT 自动化全图编译与算子融合 |
| 算力采购成本 (TCO) | 硬件溢价高,供货紧张 | 云上按需弹性开通,综合训练成本降低 40%~50% |
| 互联扩展总线 | NVLink / InfiniBand 专网 | 自研 NeuronLink + EFA 弹性网络适配器 |
| 生态开放度 | 高度专有闭源生态 | 全量开源许可,直通 PyTorch 上游社区标准 |
📝 站长洞察 (Editor’s Insight)
从 SRE 架构与云计算商业博弈的视角来看,亚马逊开源 TorchNeuron 是一记极其老辣的“阳谋”。英伟达过去十年最坚不可摧的壁垒并非先进制程或流处理器架构,而是由数百万开发者习惯、成千上万个专用优化算子编织起来的 CUDA 软件死结。亚马逊非常清晰地认识到,任何试图让开发者“换一种新语言或框架”的尝试注定会失败。因此,TorchNeuron 选择顺应 PyTorch 2.x 的图编译潮流,通过将硬件适配完全下沉到自动化编译器内部,将换芯成本压缩至极限。当开发者只需要改动一行参数就能在几分钟内无损切换算力时,算力市场将被迫从“生态垄断定价”转向纯粹的“单位算力性价比竞争”,这是整个 AI 工业界期待已久的结构性变革。


