

💡 站外导读:在现代职业社交网络中,如何在用户的即时信息流(Feed)中精准分发其“未关注成员(Non-connections)”发布的专业洞察,是平衡网络发现价值与降低信息噪声的经典工程死锁。全球职业巨头 LinkedIn 工程团队正式公布了其全新的“Profile Relevance(档案相关度)”推荐模型。该机制彻底颠覆了传统的稀疏协同过滤与统计热度粗排,创新性地引入大语言模型(LLM)充当用户职业画像的“超级摘要器”,将庞杂的履历、历史发帖提炼为高密 Prompt 并在多任务空间中对齐计算,线上生产实测取得动态隐藏率暴跌 18.8%、冷启动活跃提升 17.7% 的亮眼战果。
在传统的社交网络推荐系统中,信息流的分发逻辑通常围绕两种路径展开:一种是基于强关系的“关注流(Following Feed)”,由一维的时间序或好友互动权重主导;另一种则是基于平台全局大盘热度的“探索流(Discovery Feed)”。然而,对于拥有超过 10 亿会员的职业社交巨头 LinkedIn 而言,这两种范式均面临着严重的结构性缺陷。如果仅依赖一度关注网络,用户很容易陷入同温层信息茧房,失去跨行业、跨职级的优质职业成长机遇;而如果机械套用以娱乐、猎奇为导向的公域推荐算法,又极易在信息流中引入大量与专业诉求无关的低质灌水与营销垃圾,直接诱发用户点击“隐藏此帖(Hide post)”乃至卸载流失。
针对这一行业级痛点,LinkedIn 资深推荐算法工程师 Shiyong Lin 代表工程团队在技术博客中正式披露了新一代 Profile Relevance(档案相关度推荐模型) 的底层技术架构与线上生产实测数据。该模型首创性地将先进的大语言模型(LLM)推理能力与向量化表征融合,为缺乏交互行为历史的长尾用户与优质创作者之间架起了一座高精度的职业语境桥梁。
破除二度人脉信息孤岛:非关注内容分发的“噪声与发现”困局
在 LinkedIn 的产品形态中,用户最核心的诉求是在保持专业工作氛围的前提下,发现能够为其职业生涯提供价值的硬核知识、行业趋势与合作契机。然而,当系统尝试向用户推送其尚未关注(Non-connections)的二度乃至三度人脉内容时,往往遭遇极其严峻的冷启动与语义歧义挑战:
- 交互历史极度稀疏(Sparse Interaction): 平台上有相当比例的非活跃或低频用户,其日常行为以静默浏览为主,缺乏点赞、评论、转发等显式反馈标签,传统的协同过滤(Collaborative Filtering)和矩阵分解在此类用户群体上几乎完全失效。
- 关键词字面失真(Keyword Mismatch): 传统的倒排索引或浅层文本匹配,无法区分同词不同义的专业场景。例如一位写下“Python”的资深量化交易员,与一位正在学习“Python 基础爬虫”的大学生,其真正关注的内容深度有着天壤之别。
- 信息流信噪比失衡(Noise vs Relevance): 盲目扩大内容曝光范围,会直接拉高用户的“负向反馈率”。在职业社交场景下,一条不相关的营销动态所引发的厌恶感,远高于娱乐短视频平台。
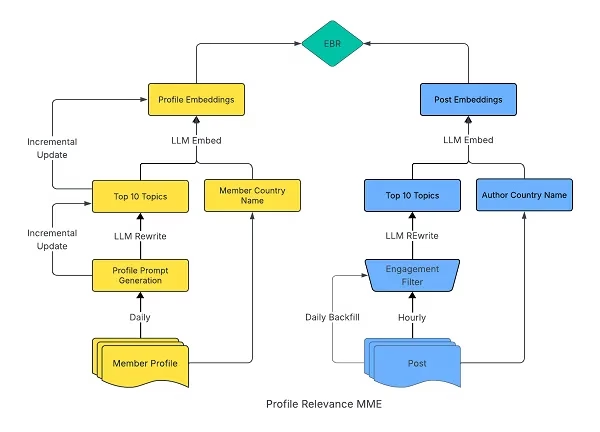
Profile Relevance 核心架构解密:大语言模型如何把履历压缩为高阶语义 Prompt
为了从根本上攻克上述难题,LinkedIn 工程团队并未盲目采用昂贵的端到端自回归大模型对全量候选池逐一评分,而是精妙地设计了一套“LLM Prompt 画像摘要 + 稠密向量 Embedding 对齐”的分层计算流水线:
1. 动态虚拟画像摘要(Prompt-based Persona Synthesis)
系统后台调度程序会深度遍历用户的完整 Profile,涵盖其过往的工作经历(Job Experience)、教育背景(Education)、技能证书(Licenses & Certifications)、所在行业与地域,以及其曾经发布或深度互动的历史文本。大语言模型接收经过脱敏的结构化元数据,并根据预设的系统级 Prompt 模板,将其高度浓缩生成一段“聊天机器人风格的职业语义摘要(Chatbot-style Summary)”。这一摘要不仅记录了客观标签,更精准捕捉到了用户当前的职业发展阶段与潜在知识诉求。
2. 统一语义空间的 Embedding 映射
完成用户画像摘要的动态生成后,该文本被送入专门针对职业文本微调的 Transformer Embedding 编码器,映射为一组高维稠密向量。与此同时,全网待分发的优质公开帖子(Posts)同样经过多维度实体抽取与上下文编码,两者在相同的潜在特征空间中展开高并发的近邻检索与多任务余弦相似度计算。
7 大职业语境维度解耦:从单一关键词到多任务 Embedding 向量对齐
据 LinkedIn 工程师 Shiyong Lin 介绍,Profile Relevance 模型在评估任意一条未关注候选动态与当前用户的契合度时,彻底摒弃了单一维度的粗暴打分,而是严格解耦为 7 大专业语境因子(Professional Context Factors) 进行多任务联合评估:
- 专业核心话题(Topic Alignment): 深度解析帖子的核心论点是否与用户当下的研究方向或专业领域强相关,剔除泛化宽泛的空洞鸡汤。
- 地理区域与本地化(Geographic Location): 评估行业动态与区域市场的关联性,确保本地化政策、峰会及行业机会的高优先级触达。
- 当前工作职位(Current Job Title): 识别帖子的专业技术栈与用户实际岗位职能(如 DevOps、前端架构、产品经理)的精准重合度。
- 雇主与企业背景(Company & Organization): 考量同行业竞争对手、上下游供应链或生态合作伙伴的动态共振。
- 细分行业赛道(Industry Vertical): 在宏观层面锚定内容所处的产业版图,防止跨领域跨度过大导致的信息噪声。
- 资历与管理职级(Seniority Level): 极其关键的差异化维度!自动区分初级工程师、技术总监、C-Level 高管对同一事件(如开源大模型架构发布)的不同关注视角(技术细节实现 vs 组织研发成本与商业 ROI)。
- 学术背景与专业教育(Education & Major): 结合高校科研体系与专业训练脉络,为产学研交叉领域的内容提供长尾连接。
线上全量 A/B 测试实测战报:关键指标对比与冷启动破局分析
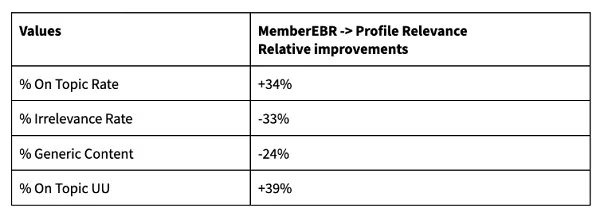
在严谨的人工双盲评审(Manual Human Assessment)验证了模型有效性后,LinkedIn 工程团队将 Profile Relevance 模型推向了生产环境全量流量的在线 A/B 测试。实验结果表现出令人瞩目的全面正向突破,尤其是在长期困扰工业界的“冷启动”与“负反馈抑制”指标上取得了质的飞跃:
| 生产 A/B 核心观测指标 | 传统协同过滤与统计基线 | Profile Relevance LLM 架构 | SRE 性能跃迁幅度 |
|---|---|---|---|
| 动态有效浏览量 (Feed Updates Viewed) | 基准线 (100.0%) | 大幅超越基线 | +0.54% 全量正向提升 |
| 用户负向操作隐藏率 (Hide Rate) | 高噪阶段 (基线) | 信息噪声极度净化 | -18.8% 断崖式下降 |
| 全网病毒式互动率 (Viral Rate) | 集中于头部大 V | 跨圈层自发传播活跃 | +0.94% 显著抬升 |
| 冷启动用户互动率 (Cold-Start Viral Eng.) | 长期低迷衰减 | 画像精准补全激发分享 | +17.7% 现象级暴增 |
| 冷启动群体日活留存 (Cold-Start DAU Lift) | 易流失盲区 | 持续提供高匹配内容 | +1.8% 稳定净增长 |
创作者生态与长尾流量重构:从“大 V 垄断”到“专业匹配”的范式跃迁
值得重点指出的是,这一架构的落地不仅显著改善了信息消费者的浏览体验,更对 LinkedIn 平台的内容供给侧(创作者生态)产生了深远的结构性赋能。在传统的关注关系链机制下,拥有数万乃至数十万粉丝的行业知名 KOL 占据了绝大部分流量倾斜,而具备深厚专业造诣但缺乏营销运作的新锐创作者往往陷入无人问津的窘境。
通过 Profile Relevance 模型,一条具有高度技术前瞻性但作者粉丝极少的技术深度长文,能够被系统敏锐地捕捉其底层 7 维语义标签,并精准投递给全网数千位正在攻坚相同架构难题的资深技术主管。这种“以专业语境和解决问题能力为核心”的分发机制,彻底终结了内容分发的流量马太效应,让真正具有干货价值的内容能够跨越人脉壁垒,实现全球范围内的价值最大化。
📝 站长洞察 (Editor’s Insight)
LinkedIn 此次工程实践的核心价值在于:大语言模型(LLM)在推荐系统中的落地,不应局限于低效的生成式 Token 排序或昂贵的端到端全序列自回归,而是将其作为“高阶特征抽象与语义归一化(Higher-order Representation Engine)”的基础设施。在职业社交网络中,非关注内容的召回本质上是一次极高维度的语义映射——传统协同过滤面临严重的数据稀疏性与马太效应,而纯向量匹配又容易被泛化表述带偏。LinkedIn 巧妙利用 Prompt 构建动态的虚拟专家画像,结合 7 维职业语境硬核指标对齐,实现了推荐精准度与算力开销的黄金平衡。这一工业级范式,为所有拥有复杂多模态用户画像的社区与 SaaS 产品提供了可落地的工程灯塔。
中文语义对照:根据用户的工作经历、教育背景、技能证书、行业与地域,以及历史发帖/互动,生成一段简洁的职业画像摘要;再将该摘要与候选帖子映射到统一语义空间,并从话题、地域、职级、行业、意图等维度评估相关度。
💡 调优建议:优先保留职业阶段、专业方向和知识诉求等高信号字段,并将输出长度控制在短摘要范围内,便于后续Embedding对齐。
LinkedIn Profile Relevance推荐模型是什么?
这是LinkedIn用于分发非关注成员内容的推荐架构。它先用大语言模型把用户履历、教育、技能和历史互动压缩成职业画像摘要,再映射到统一语义空间做相似度匹配,以提升信息流相关度并降低噪声。
Profile Relevance为什么比传统协同过滤更适合LinkedIn?
因为LinkedIn大量用户交互稀疏,协同过滤在冷启动和低频用户上容易失效。Profile Relevance改用LLM画像摘要加Embedding对齐,能从职业语境而非单纯行为历史中判断内容是否相关。
LinkedIn这套推荐架构的实测效果如何?
文章披露的线上实测结果显示,动态隐藏率下降18.8%,冷启动互动提升17.7%。这说明该模型不仅提高了推荐相关度,也减少了用户对不相关职业内容的负反馈。
Prompt画像摘要如何避免信息丢失?
先把履历、互动、偏好拆成结构化槽位,再让LLM做受控压缩,而不是自由生成长文摘要。关键是保留职业阶段、技能栈、内容偏好和负反馈信号,并用离线回放验证召回损失。
7维语义Embedding怎么落到召回分发?
可把画像摘要映射到低维语义空间,再与内容向量做近邻检索,优先服务非关注网络分发。上线前要监控隐藏率、点击率和冷启动互动,并对不同职业簇做分层评估,避免整体提升掩盖局部退化。


