


💡 站外导读:引入 AI 代码审查后,团队究竟在真修 Bug 还是只多了一堆刷屏噪音?11 月 17 日,GitHub 在组织仓库 Insights 首页正式上线 Repository insights 面板,并打通 Copilot usage metrics API 的 repos-1-day 报告,首次将 PR 吞吐量与 AI 评论在合并后的真实采纳率同框量化,帮研发主管彻底摸清代码评审覆盖盲区与落地实效。
不再只看“发了多少条评论”:Repository insights 四大核心信号与 AI 合并判定机制
PR 合并瞬间触发二次模型评估,精准区分“真采纳”与“只看没改”
在过去,企业评估 AI 代码审查往往只能统计“触发次数”或“Apply Suggestion 按钮点击量”,根本无法追踪开发者切回本地 IDE 手动改代码、或是让其他 Coding Agent 顺手修掉问题的真实采纳场景。此次 GitHub 在组织所属仓库(organization-owned repositories)的 Insights 选项卡下新增首屏页面 Repository insights,直接将 Pull Request 活动吞吐量/中位合并耗时(Median time to merge)与 Copilot 代码审查的四大核心结果信号并列呈现,包括:总体评论采纳率(Overall address rate)、高危评论采纳率(High-severity address rate)、无后续人工修改要求的 PR 占比(No human follow-up request)以及未经 Copilot 审查即合并的 PR 占比(Merged without Copilot review)。
支撑前两项采纳率指标的底层判定机制尤为硬核:每当一个 Pull Request 完成合并(merge)时,GitHub 后台会调用专门的 AI 评估模型,逐条回溯已公开发表的 Copilot 代码审查评论,判断该问题在最终代码里是否得到解决。只要开发者完成了以下四种动作之一,即记入已采纳分子(addressed):在 PR 网页端直接应用建议、指令 Copilot 自动修复、通过人工或任意编码智能体推送修复提交(commit),或明确回复认可该反馈并声明延后至后续 PR 处理。未获处理但可评估的评论则留在分母(evaluated)中,从而得出远比单一“Apply 按钮次数”更贴近真实工程闭环的采纳率。
三档审查力度 6 个月趋势与 8 类问题分布:Adaptive 路由如何归因统计?
Bug 与无障碍稳居采纳前列,定制上下文重叠计数隐藏哪些误读陷阱?
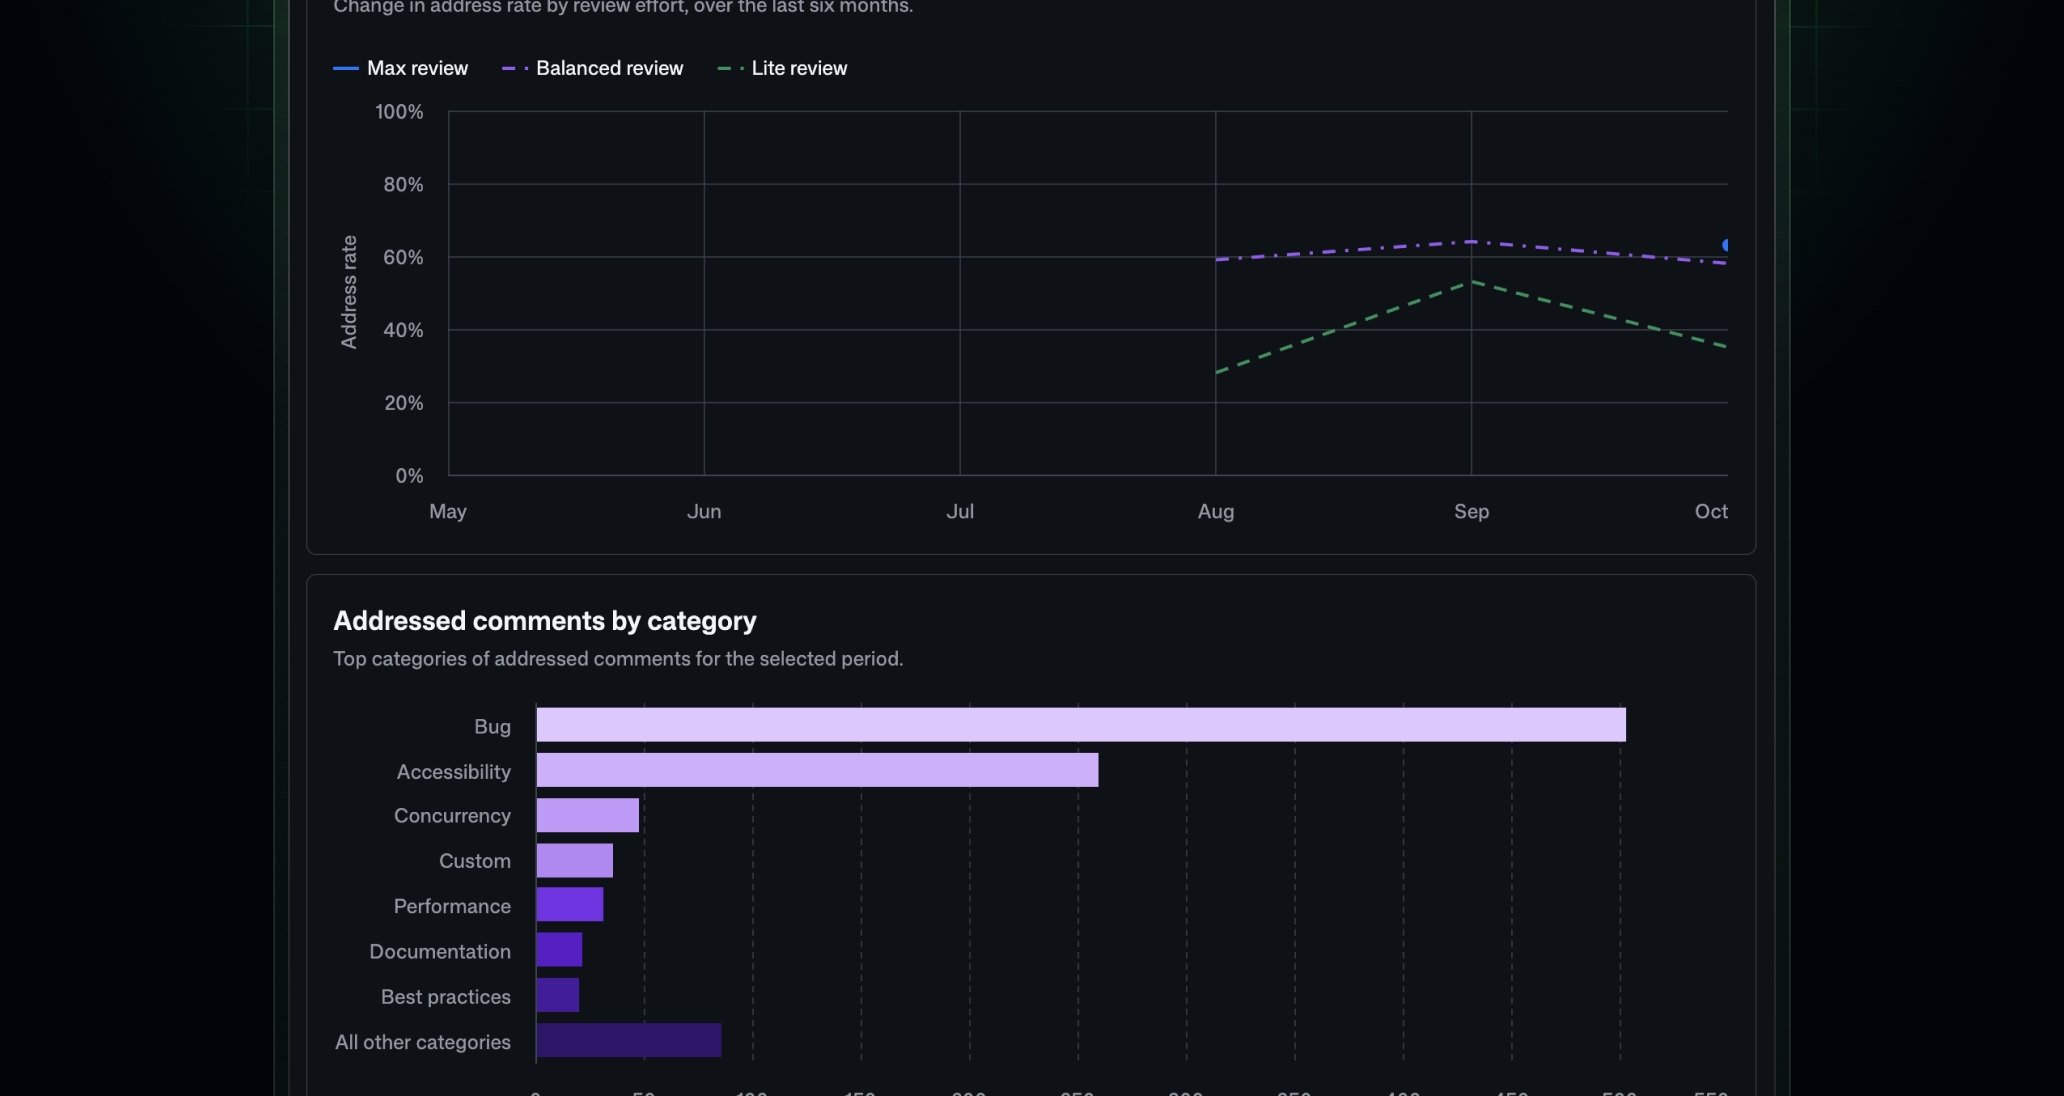
为了帮助工程团队调优配置,Repository insights 在基础汇总卡之下进一步提供了“反馈严重度(High / Medium / Low)”“审查力度(Max / Balanced / Lite)”以及“定制上下文(Custom instructions、Agent skills、MCP servers 与无定制)”三组横向拆解条形图,并配合最长跨度达 6 个完整自然月的按力度折线趋势图。值得架构师注意的是,对于启用了 Adaptive(自适应审查深度)的仓库,每一条评价不会单独设立第四档,而是自动归入 Adaptive 当次实际动态路由执行的 Max、Balanced 或 Lite 档位中,方便直观比对不同算力深度下的长期采纳率曲线(GitHub.com 历史数据始于 2026 年 8 月,其中 8 月 26 日起精确记录实际执行力度;启用数据驻留的企业则自 2026 年 10 月起计入且需满两月才展示趋势)。
在问题类别排行榜(Addressed comments by category)中,面板按绝对采纳量降序展示 Bug、Accessibility(无障碍)、Concurrency(并发)、Custom(仓库自定义规范)、Performance(性能)、Documentation(文档)、Best practices(最佳实践)及 All other categories。但 GitHub 官方文档在口径说明中特意划出了三道警示红线:第一,分类柱状图统计的是“已采纳的绝对条数”,而非“该类别内的采纳百分比”,柱子最长并不代表 Bug 类采纳率最高或代码缺陷越多;第二,“无后续人工修改要求”仅统计发生在 Copilot 首次审查之后的人类 request changes(即便后来被撤回或批准仍视为存在后续介入),且它绝不代表代码零缺陷或可取消人工把关;第三,定制上下文分组之间允许重叠——若某条评论同时调用了 Custom instructions 与 MCP server,它会同时被计入两个分组,切忌把四组数字简单相加求和。
| 指标/字段名称 | 底层计算口径与归因规则 | 适用工程决策场景 | 官方警示的统计/解读陷阱 |
|---|---|---|---|
| Overall / High-severity address rate | PR 合并时由 AI 模型判定:4 类已处理评论数 / 可评估评论总数(按合并日归因) | 评估 AI 评审建议真实落地度,重点抽检未处理的高危告警样本 | API 多日聚合须先累加分子分母再相除;不可用每日百分比直接求均值 |
| No human follow-up request | Copilot 首审后未再收到人类 request changes 的已合并 PR / Copilot 审查的已合并 PR | 衡量 AI 首轮把关后人类二次打回的频次变化与减负效果 | 即使后续人工打回被 dismiss 仍排除;绝不等于代码无缺陷或可替代人审 |
| Merged without Copilot review | (总合并 PR – Copilot 审查合并 PR) / 总合并 PR(对应 API pull_requests 字段) | 定位核心代码库的 AI 审查覆盖盲区,推进自动触发策略落地 | “自动审查已关闭”仅代表配置状态,手动触发的 Copilot 审查仍计入覆盖率 |
| Customization & Category 分解 | Custom instructions / Agent skills / MCP servers 归因;Bug/并发等采纳量降序榜 | 对比不同上下文增强配置与问题类别的真实响应分布 | 定制组存在重叠切勿直接相加;分类榜为绝对数量而非类内采纳率 |
打通 repos-1-day 企业级 API 与权限矩阵:自建研发效能大盘如何正确聚合数据?
严禁对每日百分比取均值,按 PR 合并日归因才是正确姿势
对于需要将 AI 审查指标接入内部效能中台(IDP)或 BI 报表的团队,GitHub 同步将这套指标结构落地到了 Copilot usage metrics REST API 的企业与组织级单日报告(repos-1-day)中,提供包含签名下载链接(signed URLs)的每日明细数据,历史回溯自 2025 年 10 月 10 日起最长支持 1 年。在 JSON 载荷中,团队可直接解析 copilot_code_review 对象获取评论采纳与分类统计(且 API 中的分类明细不受网页端 Top 展示条数上限截断,其中 custom 明确指向仓库编码规范类反馈),并结合 pull_requests.total_merged 与 pull_requests.total_merged_reviewed_by_copilot 精确计算组织级的覆盖率基线。
在权限与策略管控上,网页端与 API 实行清晰的职责分离:仓库级 Insights 面板面向所有拥有仓库只读权限(read access)的研发成员开放,但前提是组织管理员必须同时开启 Copilot usage metrics 与 Copilot code review 两项策略(若仅开启普通 PR 统计则不会渲染 Copilot 区块);而调用 repos-1-day API 则收口于 Enterprise owner、Billing manager、Organization owner 或具备 View Enterprise/Organization Copilot Metrics 细粒度权限的自定义角色(Classic Token 须具备 manage_billing:copilot 或 read:enterprise 权限)。在编写内部聚合脚本时,官方特别强调一条统计学铁律:所有评论结果均按 PR 合并日期而非评论发表日期归因,跨多天统计总体采纳率时,必须先将各日的 addressed 与 evaluated 绝对计数分别累加后再做除法,绝不可直接对多日的每日百分比取算术平均值。
工程落地排障指南:覆盖盲区排查与定制规则 A/B 调优四步法
从“等待数据”误判到清理低价值规则噪音的实操路径
拿到 Repository insights 后,研发团队最容易踩中的运维误区是把“数据缺失”当成“零采纳”。官方手册明确区分了仪表盘的三种状态:周报默认统计截止到最新已完整发布的自然日前 7 天,若页面出现“Waiting on your data”或陈旧日期提示,仅代表数据管道仍在生成或仓库发生过跨组织迁移,并不说明没有发生代码审查;同样,当分母 evaluated 为 0 时,系统不存在有效的采纳率计算基数,不可曲解为 0% 采纳率。此外,面板若提示“Automatic review is off”,仅说明仓库未开启全自动审查开关,并不意味所有未覆盖的 PR 都因该开关导致,人工手动发起的 Copilot 审查依然会计入覆盖分母。
基于这套透明的遥测体系,技术团队完全可以建立一套“周度闭环调优法”:第一步,先盯紧 Merged without Copilot review 与 Custom 占比,找出高风险核心仓库的自动审查配置盲区;第二步,定期拉取未获采纳的 High-severity 评论样本,区分究竟是开发者漏改了高危缺陷,还是仓库内的 Custom instructions 存在误报噪音;第三步,横向观察近 6 个月趋势中 Balanced 与 Lite 在不同类型仓库上的采纳率剪刀差,避免对样式改动或文档类仓库无脑全开高耗时高成本的 Max 模式;第四步,结合 Pull Request 区块中的吞吐量与每日中位合并耗时(同样切忌把每日中位数直接求均值当作周中位数),确保 AI 审查在拦截 Bug 的同时没有反向拖慢团队的交付流速。
📝 站长洞察 (Editor’s Insight)
过去两年团队买 Coding AI 就像开盲盒,只知道买了多少席位、模型吐了多少字,却说不清在关键的代码评审环节 AI 到底拦住了几个 Bug、又制造了多少无效返工。GitHub 这次把 Repository insights 塞进每个仓库的 Insights 首屏并同步开放 repos-1-day API,本质上是把 AI 代码审查从“主观体感”拉进了“可审计工程度量”。最值得点赞的不是那四个汇总数字,而是它用合并时刻的 AI 语义复核替代了脆弱的“按钮点击率”,并坦诚标出了定制组重叠、不能对日均率求平均等统计红线——这才是真正给严肃工程团队用的度量工具。
GitHub Repository insights能看出AI代码审查有没有被采纳吗?
可以。它在仓库 Insights 中直接展示总体评论采纳率和高危评论采纳率,并在 PR 合并时由模型回溯已发布评论,判断问题是否被真正解决,而不只是看点击了多少次 Apply。
repos-1-day API和Repository insights有什么区别?
repos-1-day API是 Copilot usage metrics 的报表接口,用于拉取仓库级使用与审查相关数据;Repository insights 则是组织仓库 Insights 首页的可视化面板,便于直接查看吞吐量、采纳率和趋势。
Repository insights里的分类柱状图和趋势图怎么解读?
分类图统计的是各类别已采纳的绝对条数,不代表采纳率高低;趋势图按 Max、Balanced、Lite 展示 6 个月变化。定制上下文分组还可能重叠,不能把各组数字简单相加。
如何避免采纳率被误读?
先区分“被采纳”与“真正提升质量”。建议同时看PR吞吐、合并耗时、返工率和审查覆盖率,并按仓库规模、团队成熟度分层比较,避免把单一高采纳率误当成高价值落地。
repos-1-day API适合怎么接入?
把它接到日更监控或周报管道里,按仓库维度拉取四维指标做时间序列对比,再设置阈值告警。重点是固定统计窗口和口径,避免因活跃度波动导致趋势失真。


