Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
Search
  • Contact
  • Blog
  • Complaint
  • Advertise
© 2024 Prompt 语宙. HalfPX. All Rights Reserved.
阅读: BabyVision评测集发布:AI视觉能力远逊人类,顶尖模型准确率不足50%引行业深思
Share
登陆
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
Search
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • Contact
  • Blog
  • Complaint
  • Advertise
© 2023 Prompt 语宙. Paooo.com. All Rights Reserved.
Prompt 语宙 > AI 工具 > BabyVision评测集发布:AI视觉能力远逊人类,顶尖模型准确率不足50%引行业深思
AI 工具AIGC 资讯

BabyVision评测集发布:AI视觉能力远逊人类,顶尖模型准确率不足50%引行业深思

站外新闻
最近更新: 2026年6月7日 下午8:09
AI评测 BabyVision MLLM 多模态大模型 视觉推理
SHARE

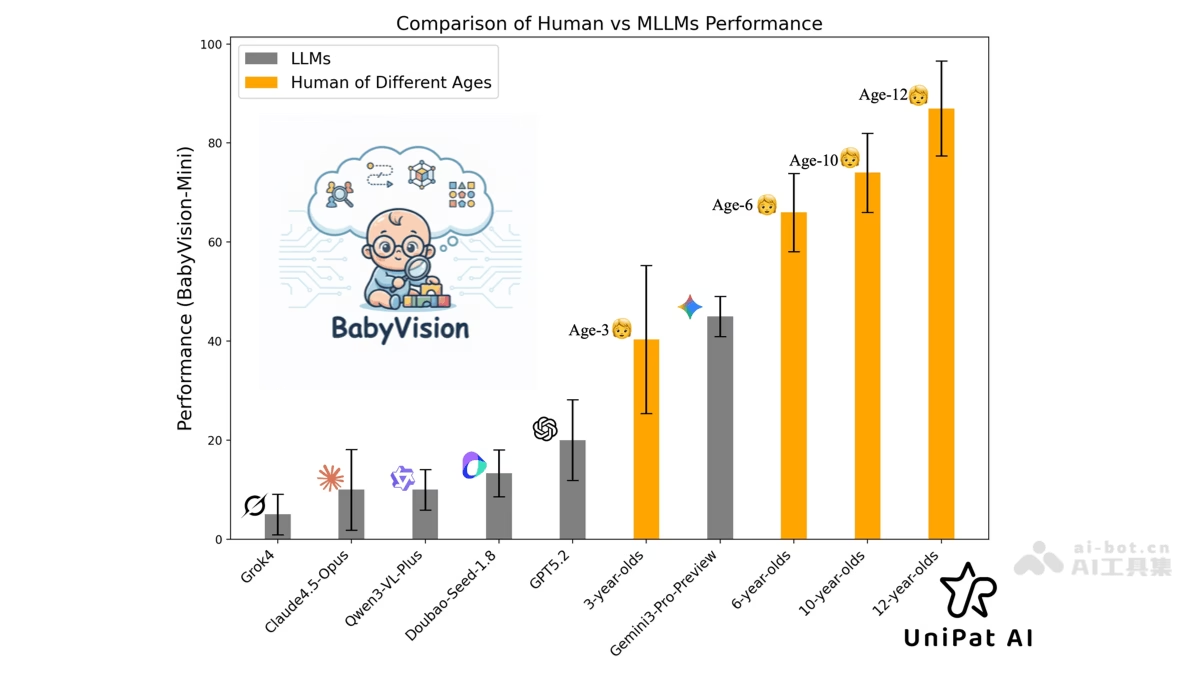
💡 站外导读:当前,多模态大模型在文本能力上狂飙突进,但在最基础的视觉理解上,它们真的及格了吗?UniPat AI团队最新发布的BabyVision评测集,用388道“纯视觉”题目,对主流模型进行了一次残酷的“体检”。结果令人震惊:人类平均正确率高达94.1%,而表现最好的商用模型准确率竟不足50%,开源模型更是集体“挂科”。这暴露了AI在连续追踪、空间想象等基础视觉能力上的系统性短板,这些能力正是自动驾驶、机器人、工业检测等产业落地的核心基石。BabyVision的发布,不仅是一份成绩单,更是吹响了攻克视觉智能底层能力的号角。

BabyVision是什么

BabyVision是 UniPat AI团队推出的多模态理解评测集,评估多模态语言模型(MLLMs)和图像生成模型在视觉推理任务上的表现。包含两个主要赛道:MLLM评估和生成评估。评测集设计了四大视觉能力类别,包括精细辨别、视觉追踪、空间感知和视觉模式识别,共22项子任务,总计388道题目。这些任务严格控制语言依赖,以真实反映模型的视觉理解能力。
阅读目录
  • BabyVision是什么
  • BabyVision的主要功能
  • BabyVision的评测结果
  • BabyVision的项目地址
  • BabyVision的应用场景
      • 📝 站长洞察 (Editor’s Insight)

BabyVision

BabyVision的主要功能

  • 评估多模态模型的视觉推理能力:通过设计严格的视觉任务,测试多模态语言模型(MLLMs)和图像生成模型在纯视觉场景下的表现,揭示模型在视觉理解方面的短板。
  • 提供两个评估赛道:一个是针对多模态语言模型的MLLM评估,另一个是针对图像生成模型的生成评估,全面覆盖不同类型的多模态模型。
  • 涵盖四大视觉能力类别:包括精细辨别、视觉追踪、空间感知和视觉模式识别,通过多样化的任务设计,全面评估模型在不同视觉场景下的推理能力。
  • 严格控制语言依赖:确保任务设计中无法通过语言提示解决,从而真实反映模型的视觉理解能力,避免模型依赖语言提示来完成任务。
  • 提供详细的评测结果和排行榜:通过准确率等指标展示不同模型的表现,并与人类基线进行对比,为研究人员提供直观的参考。
  • 支持快速启动和灵活配置:提供完整的数据集、评估脚本和详细的文档,方便研究人员快速上手,并通过环境变量等方式灵活配置评估参数。
  • 推动多模态技术的发展:通过揭示当前模型的不足,为未来的技术优化和创新提供方向,促进多模态模型在视觉任务上的进一步提升。

BabyVision的评测结果

  • 人类基线表现卓越:人类测试者的平均准确率高达94.1%,展现了人类在视觉推理任务上的强大能力。
  • 闭源模型表现参差不齐:Gemini3-Pro-Preview以49.7%的准确率领先,GPT-5.2为34.4%,Doubao-Seed-1.8为30.2%,但整体仍远低于人类水平。
  • 开源模型差距明显:Qwen3-VL-Plus的准确率仅为19.2%,多数开源模型表现不佳,显著落后于人类基线和部分闭源模型。
  • 模型在视觉任务上存在短板:无论闭源还是开源模型,在需要连续追踪、空间想象和几何归纳等视觉任务上普遍表现不佳,暴露出当前多模态模型在视觉基础能力上的不足。
  • 生成式评估结果不理想:在生成式任务中,虽然部分模型表现出“更像人类”的行为,但整体仍然缺乏稳定达到完全正确解的能力。
  • 评测结果推动技术改进:通过明确指出模型的不足,BabyVision为未来多模态模型的优化和技术创新提供了重要的参考方向。

BabyVision的项目地址

  • Github仓库:https://github.com/UniPat-AI/BabyVision

BabyVision的应用场景

  • 多模态模型评估:用于系统性评估多模态语言模型和图像生成模型在视觉推理任务中的表现,帮助研究人员了解模型的视觉理解能力。
  • 技术研究与开发:为AI研究者提供一个标准化的测试平台,用于开发和优化多模态模型,推动视觉推理技术的进步。
  • 模型性能比较:通过统一的评测标准,对比不同模型在视觉任务上的性能,为模型选择和改进提供参考。
  • 教育与学习工具:为教育工作者和学生提供一个了解多模态AI视觉能力的工具,用于教学和研究活动。
  • 行业应用参考:为需要多模态视觉推理能力的行业(如自动驾驶、医疗影像分析等)提供模型性能的参考,助力行业应用的开发和优化。
  • 学术研究与发表:为学术研究提供数据支持,帮助研究人员发表相关研究成果,推动多模态AI领域的学术发展。

📝 站长洞察 (Editor’s Insight)

BabyVision的发布,标志着AI评测从“语言炫技”迈入“视觉验真”的深水区。当业界沉迷于千亿参数和万亿token的军备竞赛时,这个评测集如同一面镜子,照出了当前多模态模型“重语言、轻视觉”的致命软肋。高达94.1%与不足50%的准确率鸿沟,不仅是技术差距,更是智能范式的代差。它揭示了一个被忽略的趋势:真正的通用智能(AGI),其根基必须建立在扎实的、类人的视觉世界模型之上,而非仅仅是语言符号的统计相关性。这份评测结果,为产业界指明了明确的优化方向——未来的多模态竞争,将围绕“视觉接地”(Visual Grounding)能力展开。对于投资者和开发者而言,关注那些在BabyVision这类“硬核”基准上取得突破的团队,可能比追逐参数规模更具长远价值。BabyVision或许就是那把筛选下一代AI模型的“标尺”。

AI巨头罕见“踩刹车”:Anthropic警告“AI造AI”时代逼近,呼吁全球放缓研发
2023 年人工智能与开源界的风云变幻 [译]
CVE 漏洞曲线垂直狂飙!AI 沦为黑客与白帽的“军备放大器”:万级虚假报警冲击开源社区与 SRE 零信任防御全景深度拆解
阿里开源QwenLong-L1.5:百万级Token长文本推理,性能叫板GPT-5,技术原理与应用场景全解析
DeepSeek联合北大推出Engram:突破GPU显存限制的LLM记忆革命,性能飙升!
TAGGED:AI评测BabyVisionMLLM多模态大模型视觉推理
分享
Email 复制链接 打印
Share
上一篇 爱诗科技发布PixVerse R1:全球首个通用实时世界模型,AI视频生成迈入「即时互动」新时代
下一篇 VidBee:开源音视频下载神器,支持YouTube/Bilibili等1000+网站一键下载
发表评价

发表评价 取消回复

您的邮箱地址不会被公开。 必填项已用 * 标注

Please select a rating!

Ad image
- 入群领取知识星球折扣卷, 仅剩99份 -
Ad imageAd image

最近更新

全息流体渐变通用占位特色图
彻底告别硬编码规则与机械卡顿!特斯拉量产版Optimus首次接入FSD同源端到端视觉大模型:神经网络直驱全身关节、真机抗推搡与得州超级工厂量产线全景拆解
AIGC 资讯
量子芯片科技感占位特色图
彻底终结AI失忆与重复盘问!阿里云Memory服务史诗级升级:PersonaMem全球夺冠、打通MCP/CLI协议与Personal Agent终身记忆架构全景技术拆解
AI 工具
量子芯片科技感占位特色图
仅需6步去噪直出电影级声画!Pika重磅开源首个MiniMax H3音视频联合大模型Pika H3Flex:适配器权重全公开、登顶开源视频榜首与运镜全景实测深度拆解
AI 工具
流光脑波AI大脑占位特色图
终结会话窗口割裂与人类注意力瓶颈!DeepSeek 开源 Super-agent 原型:双层Router-Worker分工、存算分离与Watchdog自愈系统架构深度剖析
最新趋势

相关推荐

AIGC 资讯

Surya – 开源的OCR工具包,支持90+语言、布局分析等识别

站外新闻
AI 工具AIGC 资讯

百度PP-OCRv5发布:0.07亿参数,40+语言识别,CPU每秒处理370+字符的轻量级OCR模型

站外新闻
OCR模型 PP-OCRv5 文字识别 百度 边缘计算
AI 工具AIGC 资讯

育碧AI队友项目Teammates:用生成式AI重新定义游戏沉浸感与玩家交互体验

站外新闻
AI队友 Teammates 游戏AI 生成式AI 育碧
量子芯片科技感占位特色图
AI 工具

3万亿参数基座逆袭 GPT-6!月之暗面正式发布 Kimi K3.1 Pro:100万长上下文、无MCP直驱3D与长程编码Agent深度评测

站外新闻
3D建模 Kimi K3.1 Pro 代码智能体 月之暗面 长上下文
/ Prompt 语宙 /

Experience the limitless creative possibilities of generative AI and unlock new levels of innovation.

Quick Link

  • Remaker AI
  • BGRemaker 抠图Hot
  • AIGC 工具
  • Prompt 咒语生成器
  • 去水印工具

Support

  • Contact
  • Blog
  • Complaint
  • Advertise

标签

AIGC Midjourney prompt AI Agent GPT Image 2 openai 具身智能 多模态大模型 字节跳动 AI绘画 EvoLink灵感 开源工具 Anthropic 开源模型 开源大模型 早报 大语言模型 强化学习 MoE架构 腾讯混元 AI智能体 阿里通义 AI视频生成 多模态AI chatgpt AI工具 开源框架 DeepSeek Claude Code 教程
Prompt 语宙Prompt 语宙
Follow US
© 2009-2026 Prompt 语宙. Paooo.com. All Rights Reserved.