

💡 站外导读:长期以来,语音大模型领域始终处于架构割裂的状态:文本转语音(TTS)、长音频语义理解与自动语音转写(ASR)通常由不同的孤立模型分别承载,跨模态交互时伴随着严重的级联信息损耗与高昂的维护成本。蚂蚁百灵于 10 月 20 日正式开源的 Ming-3.0 语音全栈大模型系列,彻底打破了这一壁垒。该系列围绕声音创作、长音频透视与业务级抗噪识别三大关键任务,一揽子推出了 5 款经过实战打磨的模型矩阵。从 6.25Hz 超低帧率音频表征、稀疏 MoE 混合注意力,到无需重训的上下文热词自适应技术,Ming-3.0 在国际权威评测 Artificial Analysis 中斩获多项全球第一,标志着工业级全栈语音开源迎来全新里程碑。
1. 一体化破局:Ming-3.0 语音全家桶的三大支柱与开源矩阵
在人工智能走向多模态原生的浪潮中,语音不仅是人机交互的入口,更是最具表现力与复杂性的声学载体。传统语音处理管线通常采用“ASR 识别成文本 -> LLM 理解处理 -> TTS 重新合成”的拼接链路,不仅首包延迟居高不下,更丢失了说话人的情绪起伏、语调停顿与环境背景等关键高阶声学特征。
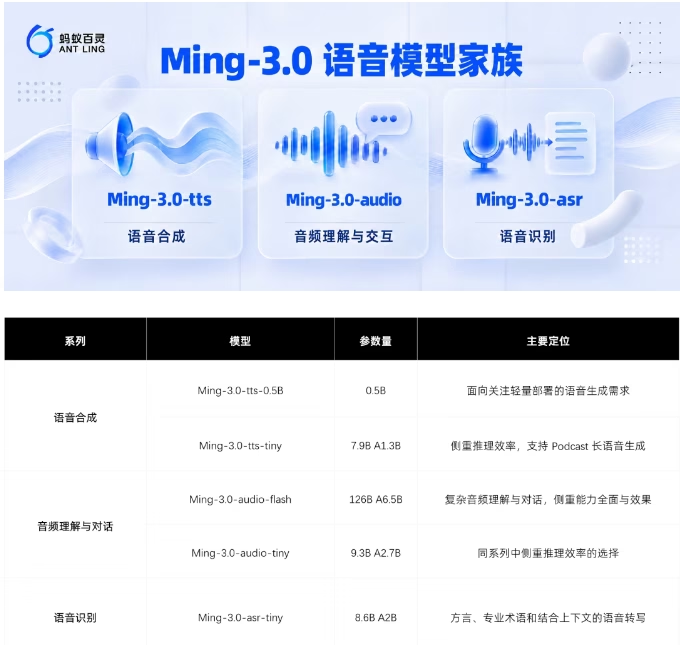
为此,蚂蚁百灵团队经过长期工业级验证,正式对外开源 Ming-3.0 语音全栈系列模型。该矩阵覆盖声音创作、长音频透析与高精度业务转写三大核心赛道,包含以下 5 款主力模型,权重已全量上线 Hugging Face 与 ModelScope 开源社区,同时在 Ling Studio 提供一站式 API 与在线体验:
- Ming-3.0-tts(0.5B / tiny):专为高表现力声音创作与个性化音色生成打造,支持导演级微调控制;
- Ming-3.0-audio(flash / tiny):端到端音频理解与智能对话大模型,支持数十小时长音频的秒级提炼与多维度观点剖析;
- Ming-3.0-asr-tiny(8.6B A2B 稀疏架构):面向严苛业务场景打造的高抗噪语音识别引擎,内置同音词与上下文热词自适应机制。
2. 极致可控与真实感染力:Ming-3.0-tts 的导演模式与副语言标签
在语音合成(TTS)方向,Ming-3.0-tts 彻底打破了传统合成模型“机械朗读”的单调体验,重点攻克了声音的细腻可控性与拟真度:
- 自然语言音色设计(Voice Design):开发者无需依赖专业音频切片,只需输入简短的自然语言 Prompt(例如“一位带着轻微沙哑声线的知性深夜电台主播”),或者提供一段参考音频,模型即可自动合成高度一致的目标音色;
- 首创“导演模式”(Director Mode):支持在文本中用描述性提示词对语气演进进行精细微调,能够精确定义特定段落的情绪转变(如由喜转怒)、重音强调位置以及换气停顿节奏;
- 行内副语言标签(Paralinguistic Tags):原生支持在句中直接插入
<laugh>(笑声)、<sigh>(叹息)、<cough>(咳嗽)等生理声学标签,完美还原人类真实对话中的动态细节。
目前,该系列技术已在蚂蚁集团旗下的医疗健康应用“蚂蚁阿福”真人医生音色克隆、AI 语音问诊通话以及“小虎智能办公”中实现大规模实战落地。
3. 6.25Hz 超低帧率表征:Ming-3.0-audio 长音频理解架构解密
长音频理解的一大技术瓶颈在于序列过长导致的显存爆炸与计算瓶颈。Ming-3.0-audio-flash 与 tiny 模型在底层架构上实现了重大革新:
在音频输入前端,团队设计了独创的 6.25Hz 超低帧率声学表征算法,相比业界主流的 25Hz 或 50Hz 编码方案,将音频 Token 的序列长度大幅压缩了 75% 以上,使得单次上下文能够承载数小时的超长会议或课程录音。在语言骨干网(Backbone)上,模型基于 Ling-3.0 底座构建,融合了 KDA(可微分知识注意力)与 Gated MLA(门控多头潜变量注意力) 混合机制,结合动态稀疏 MoE(混合专家)路由,不仅保留了说话人身份识别、情绪波动与环境声场,更可实现直接长音频转写、观点交叉提炼与结构化 JSON 报表输出。
4. 工业级高抗噪免重训:Ming-3.0-asr-tiny 上下文热词增强
针对企业级业务场景中令人头疼的专有名词、医疗术语与同音字识别漂移问题,Ming-3.0-asr-tiny(8.6B 总参数,运行时激活仅 2B 的 A2B 稀疏架构)给出了无需微调的优雅解法:
模型内置先进的 Context ASR(上下文感知识别)机制,推理时无需重新触发耗时繁琐的模型微调流水线,直接在请求中注入业务专有“热词列表(Hotwords)”与前序多轮对话上下文,模型即可自动运用声学与语义先验进行精确的同音纠错。目前,该方案已在阿福医生病历录入、支付宝亿级搜索语音助手以及金融安全声纹核身中稳定服役。
5. 国际权威基准评测数据全景横向对比
在国际权威大模型评测机构 Artificial Analysis 2026 年 10 月发布的最新横评报告中,Ming-3.0 展现了统治级的数据表现:
| 测试维度 / 评测基准 | Ming-3.0 实测成绩 | 行业主流对比基准 | 榜单与综合排名 |
|---|---|---|---|
| 发音鲁棒性 (Pronunciation Robustness) | 93.2% (Ming-3.0-tts-0.5B) | 业界顶级闭源模型 91.8%~93.1% | 并列全榜全球第一 |
| 受控声学表征 (Controlled Voice Elo) | 1069 Elo (Ming-3.0-tts-0.5B) | 主流开源 TTS 平均 980~1020 Elo | 全球开放权重模型第一 |
| 语音多模态理解综合 (MMAU / VoiceBench) | 82.00 / 86.74 (Ming-3.0-audio-flash) | 同级 Flash 级模型 76.5 / 81.2 | 位居开源第一梯队 |
| 语音转文本问答 (BigBenchAudio S2T) | 99.40 (Ming-3.0-audio-flash) | 顶级商用 API 96.2~98.1 | 斩获全榜单第一名 |
| 高噪声业务场景词错误率 (CER/WER) | 平均错误率仅 4.41% | Fun-ASR1.5 (5.8%) / Qwen3-ASR (5.2%) | 全面领跑同尺寸开源 ASR |
📝 站长洞察 (Editor’s Insight)
蚂蚁百灵 Ming-3.0 的开源发布,释放了多模态语音技术从“拼接实验”迈向“原生一体化工业部署”的强烈信号。长期以来,行业内缺乏兼具极低首包延迟、副语言真实情感表达以及免重训热词适应的开源基座。多数企业被迫花费巨资采购闭源 API,或者维护极其庞大且脆弱的三段式级联系统。Ming-3.0 的核心价值在于它用 6.25Hz 的激进低帧率算法解决了长序列计算膨胀问题,并通过 A2B 稀疏 MoE 架构把运行时激活显存控制在极小区间。随着该系列权重在 Hugging Face 与 ModelScope 完全开源,垂直领域的 AI 医疗助手、情感陪伴智能体与车载语音交互将迎来爆发式创新。


