

💡 站外导读:在硅谷语境中,“Neolab”通常指不计成本烧卡预训练、尚未规模化创收的前沿实验室。然而,单季营收破 7.82 亿美元(YoY +39%)、年化超 30 亿美元的互联网基建巨头 Cloudflare,却在近期峰会高调自封 Neolab。透过 Latent Space 对其 AI 负责人 Michelle Chen 的专访,得以一窥边缘云切入自研模型并用 Clairic 终结 LLM 提取幻觉的一手内幕。
一、 重新定义 Neolab:从边缘网络、Workers AI 到自研模型的自然演进
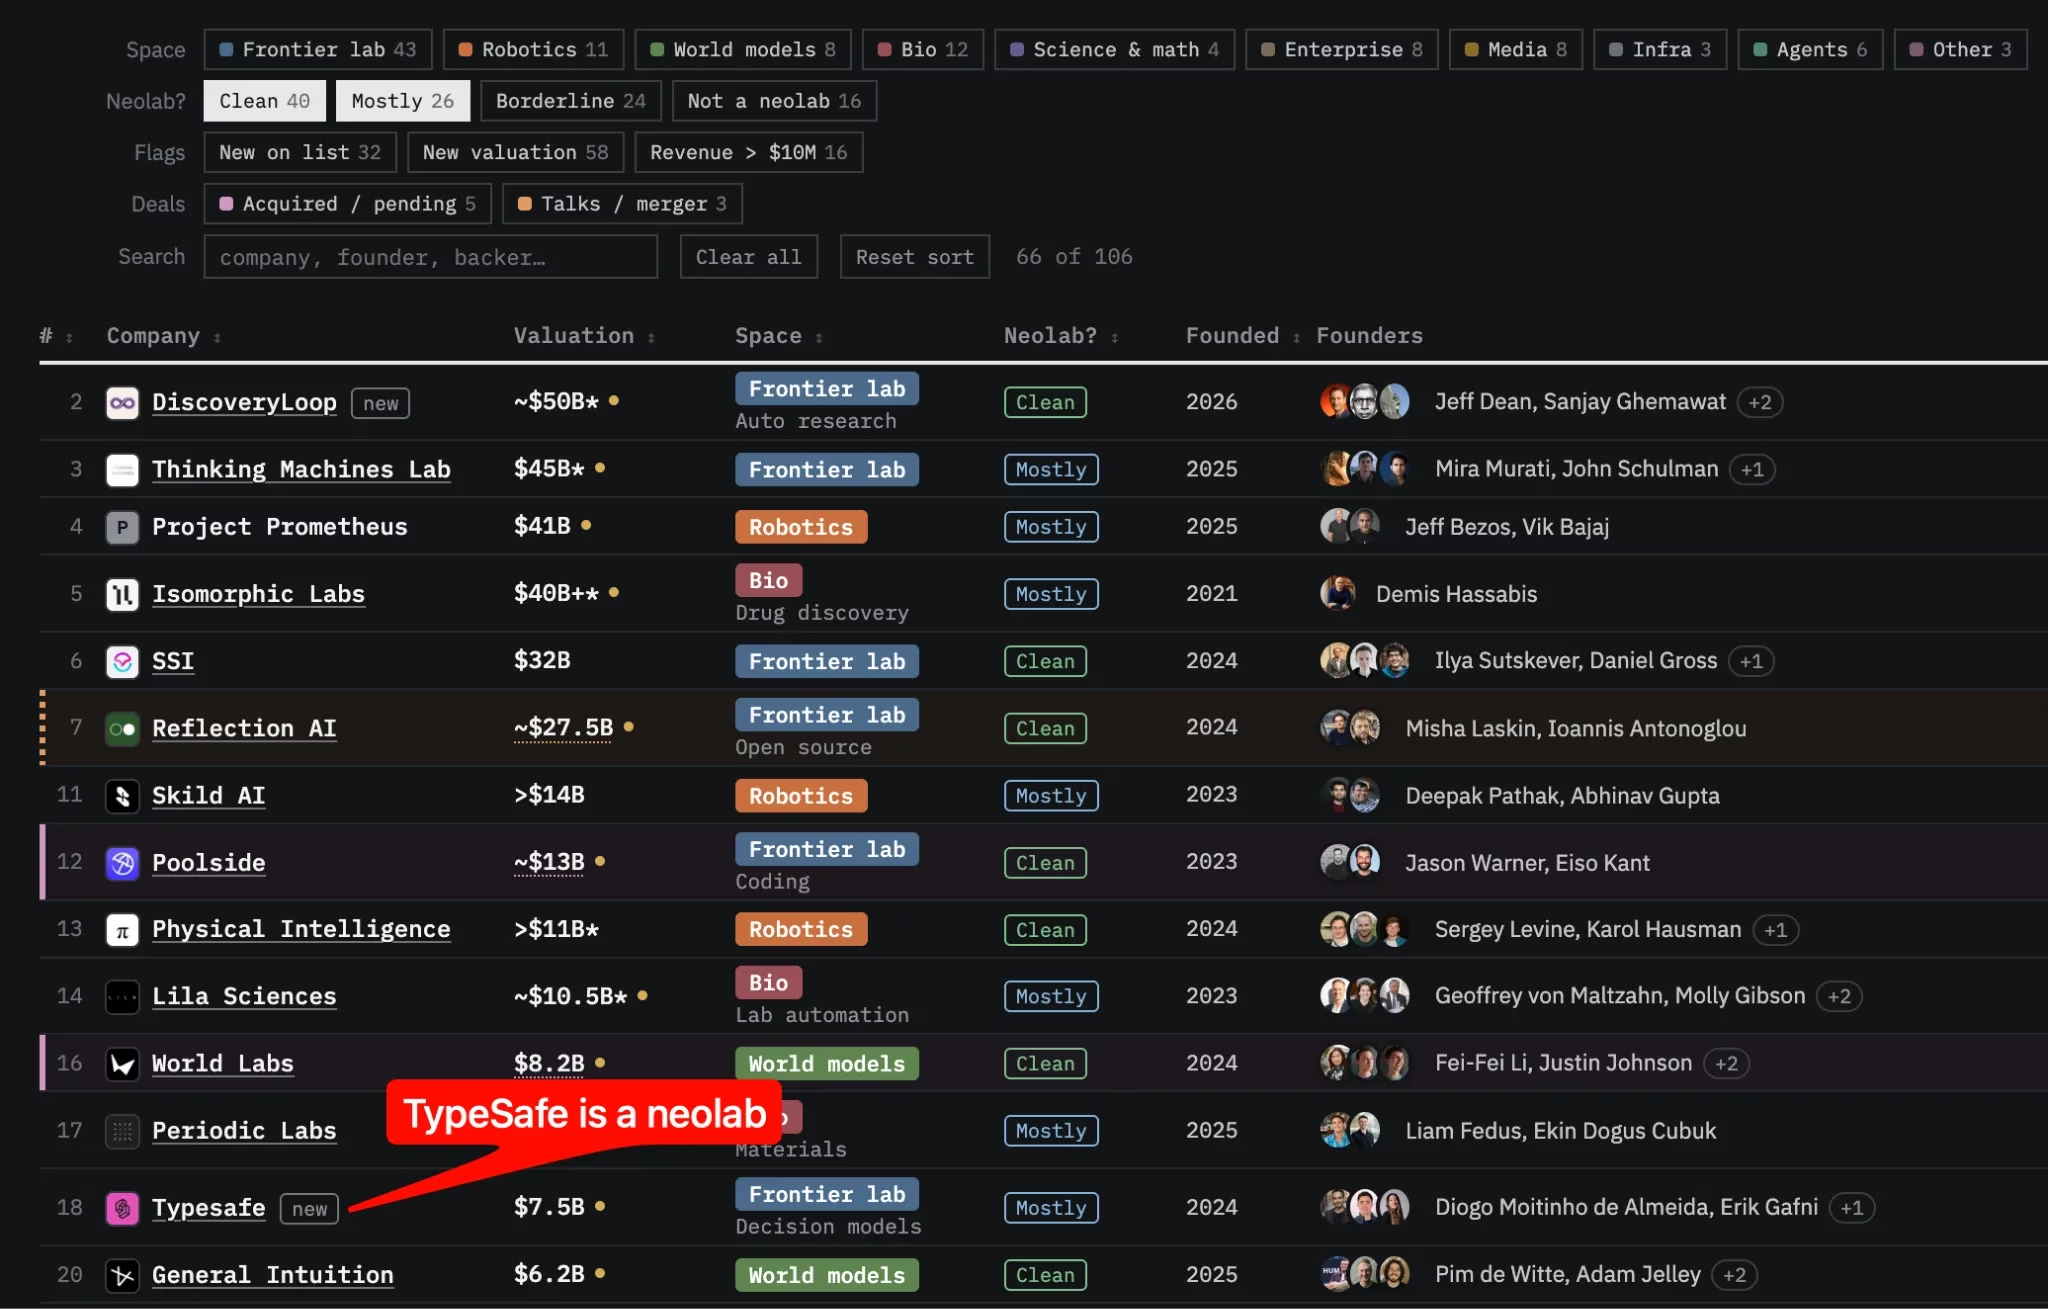
“Neolab(新型人工智能实验室)”一词最初由《The Information》用来形容 Thinking Machines Lab、Poolside、TypeSafe AI 等汇聚顶尖研究员、烧钱从头训模但缺乏营收的新锐机构。按照 Menlo Ventures 合伙人 Deedy Das 整理的榜单标准,拥有 30 亿美元年化营收的上市公司 Cloudflare 显然并不符合“无商业收入”的传统画像。
但在 Michelle Chen 看来,自研模型是 Cloudflare 基建版图演进的必然终点:过去十五年,Cloudflare 从边缘网络加速一路延伸至无服务器计算(Workers,现已服务海量 Agent 运行)、边缘存储以及在 Workers AI 上托管 DeepSeek、GLM、Kimi 等第三方开源权重;而当底层算力、路由与全球分发网络都已在手,补齐生态缺口、亲自下场制造低延迟专有模型便成了顺理成章的一步——用她的话说,“成为 Neolab 意味着我们可以亲手造出生态里真正缺失的那块拼图”。
二、 两周复刻 Jev 推出 Clef,再用 Clairic 终结自回归 JSON 幻觉
谈及转型契机,Michelle Chen 借用中国成语将今年 9 月 TypeSafe AI 发布 Jev 决策模型形容为一场“东风”——System 1(系统一)快响应范式让始终以“毫秒级速度”为生命线的 Cloudflare 瞬间看到巨大契合点:企业完全不需要把所有流量都送进耗时数秒的通用大模型。Chen 甚至坦率透露,由于 TypeSafe AI 已历经两年摸索并跑通了 API Schema 范式,Cloudflare 团队仅仅用了两周时间便基于同类 System 1 架构推出了自己的决策模型 Clef。
但 Cloudflare 并没有止步于跟随,而是迅速瞄准了企业流水线中另一个被通用 LLM“高射炮打蚊子”的重灾区——非结构化信息提取。上个月,Cloudflare 推出全球首个 System 1“提取模型(Extract Model)”Clairic。传统自回归大模型处理发票、物流单据时,经常会犯低级错误——明明单据上印着清晰的数字,LLM 却可能一本正经地幻觉成“订单号也许是 3、也许是 4 或 5”,甚至返回残缺的 JSON 格式。而 Clairic 通过单次前向传播(One Forward Pass)直接计算、抽取、估算并输出强类型数值结果,在毫秒级延迟下实现了确定性结构化交付。
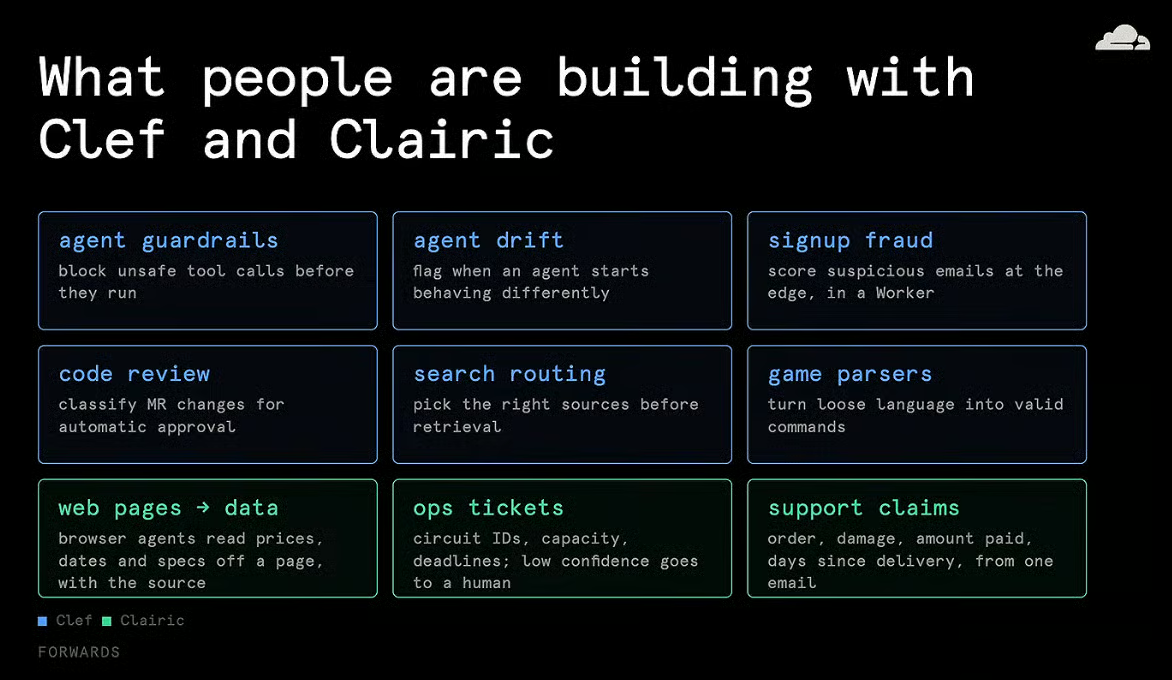
三、 传统自回归 LLM vs 决策模型 Clef vs 提取模型 Clairic 技术对比
通过将繁重的请求拆解给毫秒级专用小模型,Cloudflare 正在 Workers 边缘节点重塑企业 AI 的成本与确定性曲线。下表基于专访披露的技术特征,对比三类模型在工业链路中的分工差异:
| 技术维度 | 传统自回归通用大模型 (LLM) | System 1 决策模型 (Clef) | System 1 提取模型 (Clairic) |
|---|---|---|---|
| 核心任务定位 | 开放域文本生成、复杂多步逻辑与代码创作 | 在预设候选空间内完成路由、分类、风控拦截与动作选择 | 从发票、网页、日志等非结构化输入中抽取/计算强类型数值 |
| 推理执行机制 | 逐 Token 自回归采样生成,耗时随输出长度线性攀升 | 单次前向传播输出严格约束的选项分布 | 单次前向传播直接提取并输出强类型目标值 |
| 典型响应延迟 | 秒级至数十秒级 | 毫秒级(适配边缘实时网关路由) | 毫秒级(消除长文本重复读取开销) |
| 结构化与幻觉风险 | 易发生数字幻觉、偶发畸形 JSON 导致下游解析崩溃 | 输出空间严格收敛,彻底杜绝非法选项越界 | 告别“maybe 3/4/5”随机猜测,保障字段级抽取确定性 |
四、 不碰昂贵从头预训练:专注开源后训练与推理模型的去风险账本
在专访尾声,Michelle Chen 明确划定了 Cloudflare 作为“Neolab”的技术投资边界:团队未来不仅会继续推出 System 1 专用模型,还已在实验自研推理模型(Reasoning Models)与通用大语言模型;但与动辄投入数亿美元采购万卡集群从头预训练(Pre-training)的前沿实验室不同,Cloudflare 明确不会把精力耗费在从零预训练上,而是依托现有强悍的开源底座,集中兵力在后训练(Post-training)环节做极致效率优化与领域专精。
这背后隐藏着一笔极为清醒的供应链去风险账本:一方面,类似 Jev 这类闭源商用模型无法由 Cloudflare 直接托管运行,而诸多头部闭源实验室高昂的商业授权费也容易侵蚀云平台利润;另一方面,面对全球地缘监管收紧,过度依赖特定海外或中国开源模型同样潜藏未知的合规与断供风险。通过掌握基于开源基座的后训练自主能力,Cloudflare 得以在全球边缘节点实现自给自足的“模型主权”。
📝 站长洞察 (Editor’s Insight)
Cloudflare 的“Neolab 宣言”给所有云计算与边缘基建厂商指明了一条极高投资回报率的自研模型路线:千万别去和资金百亿美元级的前沿巨头硬拼万卡从头预训练,而是紧盯自家网关上高频流转却被通用 LLM 搞得又慢又贵的脏活累活。两周复刻 Clef 说明 System 1 架构的工程复制门槛并不高,真正的胜负手在于谁掌握边缘实时场景的数据流与 Schema 定义权;而 Clairic 切入“非结构化单据强类型数值抽取”更是打中了企业落地 Agent 的七寸——毕竟任何生产系统在财务对账和订单流转环节,都容不下一句“也许是 3 也可能是 4”的自回归随机幻觉。
Cloudflare为什么自称Neolab?
因为它已不只是云基础设施公司,而是开始自研专用AI模型,并把边缘网络、Workers AI、推理与后训练能力整合进同一套产品体系。文章强调,这种“造生态缺口”的能力,让它具备了Neolab式实验室特征。
Clairic和普通LLM有什么区别?
Clairic是System 1提取模型,面向发票、物流单据、网页和日志等非结构化输入,采用单次前向传播直接输出强类型结果,延迟更低,也更能避免数字幻觉和畸形JSON。
Cloudflare会做从头预训练大模型吗?
不会。文中明确写到,Cloudflare未来会继续做System 1模型、推理模型和通用大模型探索,但不会投入巨资从零预训练,而是聚焦开源底座上的后训练与领域专精。
📊 Neolab公司列表中的部分条目与分类信息(AI 视觉结构化提取)
核心发现:图中展示的是一张Neolab公司筛选列表与估值信息表,核心信息是多家高估值公司按Space和Neolab状态分类展示,并非基准跑分或实验曲线图。
| # | Company | Valuation | Space | Neolab? | Founded | Founders |
|---|---|---|---|---|---|---|
| 2 | DiscoveryLoop | ~$50B* | Frontier lab | Clean | 2026 | Jeff Dean, Sanjay Ghemawat +2 |
| 3 | Thinking Machines Lab | $45B* | Frontier lab | Mostly | 2025 | Mira Murati, John Schulman +1 |
| 4 | Project Prometheus | $41B | Robotics | Mostly | 2025 | Jeff Bezos, Vik Bajaj |
| 5 | Isomorphic Labs | $40B++ | Bio | Mostly | 2021 | Demis Hassabis |
| 6 | SSI | $32B | Frontier lab | Clean | 2024 | Ilya Sutskever, Daniel Gross +1 |
| 7 | Reflection AI | ~$27.5B | Frontier lab | Clean | 2024 | Misha Laskin, Ioannis Antonoglou |
| 11 | Skild AI | >$14B | Robotics | Mostly | 2023 | Deepak Pathak, Abhinav Gupta |
| 12 | Poolside | ~$13B | Frontier lab | Clean | 2023 | Jason Warner, Eiso Kant |
| 13 | Physical Intelligence | >$11B* | Robotics | Clean | 2024 | Sergey Levine, Karol Hausman +1 |
| 14 | Lila Sciences | ~$10.5B* | Bio | Mostly | 2023 | Geoffrey von Maltzahn, Molly Gibson +2 |
Clairic适合哪些抽取场景?
更适合高频、格式固定、对延迟敏感的结构化任务,如表单解析、工单字段抽取、日志归类和JSON生成。若任务需要长链推理、开放式生成或强上下文理解,仍应让大模型负责主决策,Clairic做前置提取或后处理校验。
两周复刻Clef的关键工程方法是什么?
核心不是“训练更大”,而是先锁定目标行为,再用高质量样本、蒸馏与评测闭环快速逼近。工程上要先定义失败样例、建立自动回归集,并把边缘部署、量化和延迟预算一起纳入训练目标,才能真正落地。


