

💡 站外导读:长期以来,本地端侧 AI 助手一直深陷“能读会写却有口难开”的交互瓶颈。开发者若想实现自然语音交互,往往不得不调用云端 TTS API,这不仅破坏了本地部署的核心数据隐私防线,还因网络时延导致对话频频卡顿。开源本地运行平台 Ollama 此次在 Mac 客户端上迈出的关键一步,通过原生集成 Gradium Phonon 系列轻量语音基座与 Apple MLX 异构调度,在保持极低词错误率的同时实现实时边想边说的流式发音,为端侧真正自主、离线可控的个人语音 Agent 奠定了全新标杆。
近日,在 GitHub 狂揽超过 18.5 万颗 Star 的顶尖本地大模型开源运行工具 Ollama,正式面向 macOS 平台推出了划时代的版本更新。该版本首次原生内置了离线文本转语音(Text-to-Speech, TTS)引擎,彻底宣告了本地开源智能体从传统的“纯字符打字交互”向“全模态端到端发音”的范式跃迁。
1. 交互升维:从“字符终端”迈向“全双工离线语音”新范式
在过去两年的端侧开源生态中,Ollama 凭借 ollama run llama3 等极简命令,成为全球开发者在本地调试大语言模型的首选基石。然而,当开发者试图将 Ollama 打造成如贾维斯(Jarvis)般的常驻个人助理时,始终受制于语音输出链条的割裂:
- 云端依赖与隐私击穿:若调用 OpenAI TTS 或 ElevenLabs API,企业内部代码片段和个人敏感提示词将被迫上传至公有云;
- 拼装架构的高时延:通过外部 Python 脚本或 Node 服务监听 Ollama 文本输出再调用本地 Coqui/Bark,多次进程间通信与显存二次重载导致端到端延迟通常高达 2~3 秒;
- 资源碎片化争抢:LLM 文本生成占用大量 GPU 显存,导致外部 TTS 模型加载时频繁触发 OOM(内存溢出)。
Ollama 此次将 TTS 引擎直接打通至原生运行时,实现了进程内统一调度与显存动态复用,真正让离线个人助手具备了工业级的开箱即用体验。
2. 软硬协同深度优化:Apple MLX 与 M5 Max 统一内存的性能实测
本次更新最大的工程亮点在于对 Apple Silicon 统一内存架构(UMA)与苹果官方开源深度学习框架 MLX 的深度挖掘。传统跨平台方案往往依赖 PyTorch 或 ONNX 运行时,在 Metal 后端转换中存在不可忽视的抽象开销,而 Ollama 团队直接调用 MLX 原生算子,使权重常驻于高速统一寻址空间中。
| 测评维度 | Ollama (Mac 原生 MLX 引擎) | Hugging Face Transformers (CPU/MPS) | 主流商业云端 TTS API |
|---|---|---|---|
| 生成吞吐速度 | 比原生基准快 35% (M5 Max 实测) | 标准参考基准线 | 受限于公网传输与队列排队 |
| 词错误率 (WER) | 保持与官方参考实现一致 (< 1.8%) | 极佳基准值 | 极佳基准值 |
| 流式首包时延 (TTFT) | < 180ms (逐词流式边想边播) | > 800ms (整句缓冲分词) | 400ms ~ 1200ms (依赖网络) |
| 数据隐私与离线合规 | 100% 物理离线,零外联请求 | 100% 物理离线 | 明文传输,存在外部审计风险 |
3. 模型架构与多语言生态:Gradium Phonon 的技术底座
作为首批进入 Ollama 官方支持矩阵的语音模型,由 Gradium 团队研发的 Phonon 系列模型表现极为抢眼。该模型具有两大核心技术特性:
① 紧凑参数与高表现力声学建模
Phonon 针对端侧部署进行了激进的参数轻量化设计,将声学特征预测与神经声码器(Vocoder)进行了端到端端联,避免了传统级联模型在梅尔频谱转换过程中的细节失真。生成的语音能够高度还原人类呼吸声、语气停顿和轻重音重读,告别了传统机器人念稿的呆板音调。
② 覆盖 5 大语系与多口音自由切换
首发版本不仅提供了涵盖英语、法语、德语、西班牙语和葡萄牙语的独立专用模型,还附带了一个支持全语种即时切换的多语言通用基座。用户不仅可以在配置文件中一键指定语言,还能自由选择美式标准英语(US General)、英伦口音(RP)等多种风格。
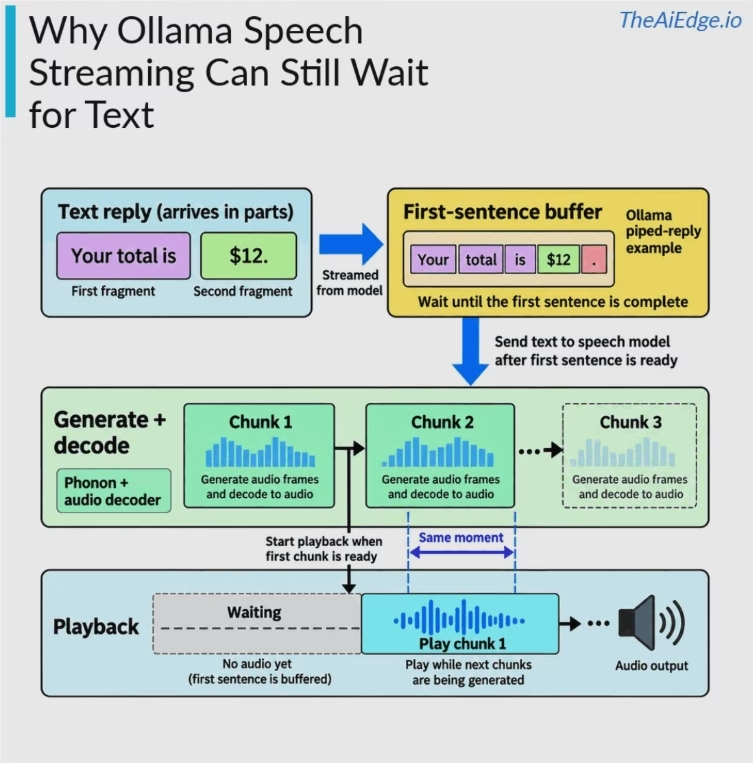
4. 实时流式音频合成管线 (Streaming Audio Pipeline)
传统本地 TTS 方案之所以让人感觉“卡顿”,根本原因在于很多工具要求必须等待 LLM 输出完整的段落句尾标点(如句号、换行),才将整个字符串送入合成管线。而 Ollama 此次重构了内部缓冲区状态机:
- Token 级增量解析:大模型每吐出几个 Token,流式语音生成器即在后台建立预测窗口;
- 无缝音频环形缓冲:音频帧通过原生 CoreAudio 驱动流式送入 Mac 声卡,在 LLM 还在生成下半句时,上半句的声音早已在扬声器中响起;
- 多平台路线图明确:官方确认,在 Mac 版平稳落地后,针对 Windows(利用 DirectML 与 WSL2)和 Linux(利用 ROCm 与 CUDA)的同等流式离线语音支持也将迅速推送。
📝 站长洞察 (Editor’s Insight)
端侧大模型的终局绝不是简单的离线文本补全,而是全模态环境下的零信任闭环。Ollama 接入本地语音合成能力,代表着开源开发者社区正在将 AI Agent 的最后一块外设短板补齐。以往端侧语音受限于显存占用与计算开销,常常沦为鸡肋玩具,但得益于 Apple Silicon 统一内存的巨大带宽优势和苹果 MLX 框架对底层 Metal 算子的极致榨取,千毫秒级端侧语音已经具备了超越云端工业级管线的响应体感。更重要的是,在企业内网、医疗诊疗与金融研报等极端敏感的保密场景下,这种“一滴数据都不离机”的全双工语音交互,将成为压垮高昂商业闭源 SaaS 的致命利刃。下一阶段,期待 Linux 和 Windows 平台尽快跟进 DirectML 与 ROCm 的原生优化,彻底推倒端侧多模态对话的算力高墙。


