Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
Search
  • Contact
  • Blog
  • Complaint
  • Advertise
© 2024 Prompt 语宙. HalfPX. All Rights Reserved.
阅读: 单集群日处理155万亿Token!DeepSeek重磅开源生产级推理框架DeepInfer:首创PD分离、3FS缓存命中率达96%与SWA常数重算架构全景实测深度拆解
Share
登陆
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
Search
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • Contact
  • Blog
  • Complaint
  • Advertise
© 2023 Prompt 语宙. Paooo.com. All Rights Reserved.
DeepSeek 开源生产级高性能推理框架 DeepInfer 官方架构与集群部署全景图
Prompt 语宙 > AI 工具 > 单集群日处理155万亿Token!DeepSeek重磅开源生产级推理框架DeepInfer:首创PD分离、3FS缓存命中率达96%与SWA常数重算架构全景实测深度拆解
AI 工具

单集群日处理155万亿Token!DeepSeek重磅开源生产级推理框架DeepInfer:首创PD分离、3FS缓存命中率达96%与SWA常数重算架构全景实测深度拆解

站外新闻
最近更新: 2026年11月1日 上午10:06
3FS分布式缓存 DeepInfer DeepSeek PD分离 推理框架
SHARE

💡 站外导读:在大模型 Agent 多轮复杂调用与长上下文编程场景下,显存墙(Memory Wall)与 KV Cache 重复计算已成为吞噬企业算力预算的核心元凶。DeepSeek 正式开源其官方大规模商用底座——生产级推理框架 DeepInfer。该框架不仅支持单集群日处理 155 万亿 Token 的超高吞吐,更通过 Prefill/Decode 物理硬件解耦、3FS 分布式前缀缓存、SWA Bounded Replay 常数重算及 DSpark 投机解码四大绝技,将首字延迟压缩至 400ms,为自建大模型服务提供了教科书级的工程落地范式。
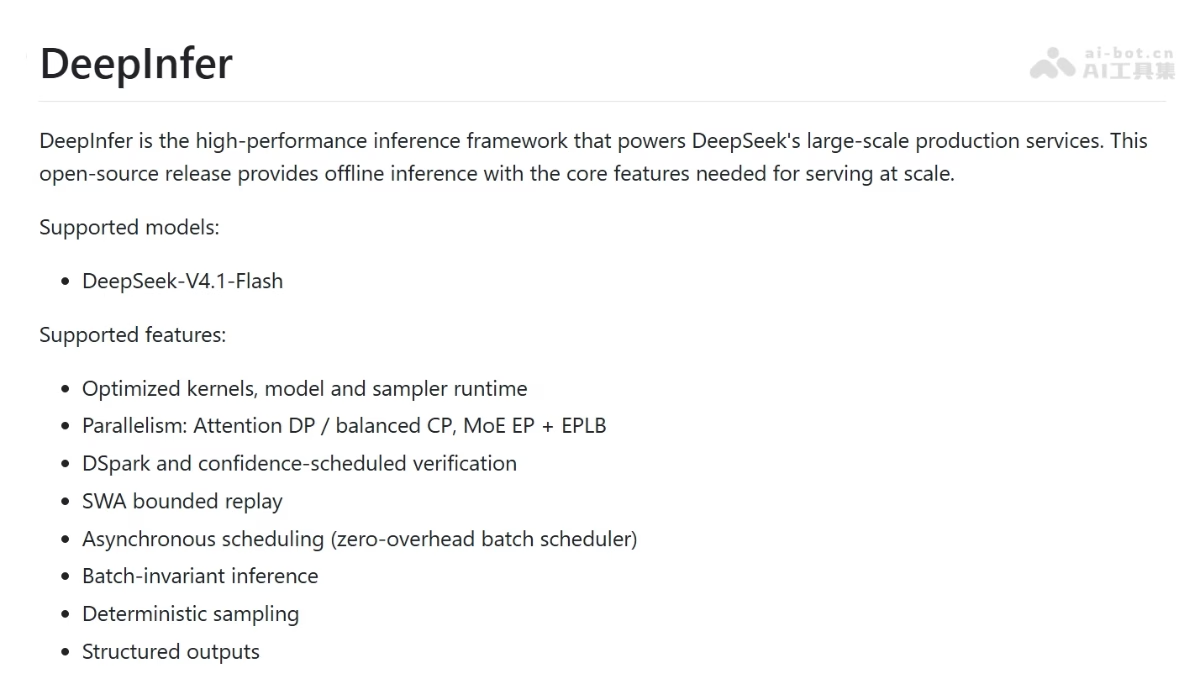
DeepSeek 开源生产级高性能推理框架 DeepInfer 官方架构与集群部署全景图
图 1:DeepSeek 生产级推理框架 DeepInfer 整体技术架构与集群拓扑

一、DeepInfer 破局:从学术 Demo 到日均 155 万亿 Token 的生产级架构

在当前大模型开源生态中,以 vLLM 和 TGI 为代表的推理引擎虽然兼容性极佳,但在超大规模集群以及极其严苛的低延迟、高并发商业场景下,通用的批处理与缓存调度往往难以榨干底层异构算力的极限。

阅读目录
  • 一、DeepInfer 破局:从学术 Demo 到日均 155 万亿 Token 的生产级架构
  • 二、核心硬核技术剖析:四大突破性架构创新
    • 1. 算力与带宽解耦:极致的 PD 分离部署架构
    • 2. 96% 命中率神话:基于 3FS 的分布式前缀缓存体系
    • 3. 常数级开销:SWA Bounded Replay 破解长上下文重算难题
    • 4. 自研 DSpark 投机解码与置信度动态调度
  • 三、DeepInfer vs vLLM 核心工程指标全维度对比
  • 四、极简上手指南:从环境准备到离线推理实操
  • 五、企业级生产落地核心场景
      • 📝 站长洞察 (Editor’s Insight)

DeepInfer 源自对 vLLM 核心机制的深度工业级重构,专为 DeepSeek V4.1 Flash 等最新一代 MoE 架构设计,已在 DeepSeek 官方生产环境中承担核心流量调度。其核心技术亮点包括:

  • 生产验证的高吞吐:线上单集群日处理量达 155 万亿 Token,生成速度稳定在 230~300 tokens/s,首字延迟(TTFT)仅约 400ms。
  • 全栈跨硬件异构兼容:不仅深度支持英伟达新一代 SM100 GPU,更无缝适配国产华为昇腾 950 NPU,是目前少有的打通国内外两大主流算力生态的生产级框架。
  • 官方生态严格对齐:配套开源生产级 Token 编解码组件 deepseek-recipe,统一 Chat Completions、Responses、Messages 三套接口标准,从分词、防注入到流式输出完全复刻官方线上 API 行为。

二、核心硬核技术剖析:四大突破性架构创新

1. 算力与带宽解耦:极致的 PD 分离部署架构

传统推理引擎通常将 Prefill(首字预填充)与 Decode(逐字解码)混合运行在同一计算卡上。然而:

  • Prefill 阶段:一次性处理成千上万个 Prompt Token,属于典型的计算密集型(Compute-Bound)任务,适合算力密度高、Tensor Core 密集的服务器。
  • Decode 阶段:受自回归特性限制,每生成一个 Token 都需要完整读取一次巨大的模型权重和 KV Cache,属于典型的显存带宽受限型(Memory-Bandwidth-Bound)任务。

DeepInfer 采用物理层面的 PD 分离部署:Prefill 阶段部署在常规的高性价比 8 卡服务器上,而 Decode 阶段则部署在 64~128 卡的高速互联超节点(Super-Node)上。线上按约 1:1 的配比协同工作,彻底消除了两类任务相互抢占硬件资源的痛点。

2. 96% 命中率神话:基于 3FS 的分布式前缀缓存体系

在 Agent 场景中,每一次工具调用与多轮交互都会附带数百甚至数千 Token 的完整上下文历史。如果每次都重头计算,算力开销将呈指数级浪费。

DeepInfer 构建了一套基于独立 3FS 分布式存储集群的前缀缓存体系:

  • 系统以 128 Token 为一个存储块,严格自前缀向后匹配,命中历史部分直接零拷贝复用 KV Cache。
  • Prefill 阶段输入缓存命中率高达 96%,使得 Prefill 单卡吞吐从无缓存状态下的 6 万 tokens/s 暴增至 150 万 tokens/s,效能跃升 25 倍!
  • 针对不同流量实施精细化生命周期管理:Agent 工具流量热缓存保留 3 天,常规对话流量保留 7 天。

3. 常数级开销:SWA Bounded Replay 破解长上下文重算难题

V4.1 Flash 在特定网络层采用了滑动窗口注意力机制(Sliding Window Attention, SWA),每个 Token 仅聚焦于最近的 128 个 Token。由于这部分高速局部 Cache 不适合持久化落盘,过去未命中缓存时需要按照“层数 × 窗口长度”进行高昂的精确重算。

DeepInfer 提出了 SWA Bounded Replay 机制:巧妙地将重算范围严格收敛至最后的 128 个 Token,使得重算成本与上下文的绝对长度和网络层数彻底解耦,Prefill 阶段总体计算量直接减半,真正做到了长程文本推理的“常数级开销”。

4. 自研 DSpark 投机解码与置信度动态调度

为了进一步突破自回归生成的吞吐天花板,DeepInfer 深度集成了自研的 DSpark 投机解码模块:

  • 投机猜测与批量验证:轻量级草稿模型预先推测连续 5 个候选 Token,再交由主力大模型单步批量验证,猜对直接并行采纳,仅在首个错误位由主力模型修正。
  • 置信度感知调度:内置置信度预测头,若预估后续 Token 采纳概率过低,则提前熔断验证,将 GPU 算力让渡给其他高价值请求,使真实线上生成吞吐再涨 6%。
  • CPU/GPU 异步流水线:将第 N+1 步的 CPU 调度逻辑与第 N 步的 GPU 物理张量计算完美重叠,彻底消除了传统架构中 GPU 频繁等待 CPU 下发指令的空转现象。

三、DeepInfer vs vLLM 核心工程指标全维度对比

对比维度 DeepInfer (DeepSeek) vLLM (社区标准)
核心定位 DeepSeek 模型的极致生产级专用框架 通用大语言模型多场景服务框架
硬件生态支持 英伟达 SM100 GPU + 华为昇腾 950 NPU 英伟达全系 + AMD ROCm / Intel / TPU 等
底层架构优化 PD物理分离、3FS缓存池、SWA Bounded Replay、DSpark PagedAttention、连续批处理、基础前缀缓存
峰值吞吐指标 单集群日处理 155 万亿 Token,Decode 每卡 14K tokens/s 主流基准表现,依赖通用策略
官方 API 行为对齐 通过 deepseek-recipe 实现 100% 协议级完美一致 提供标准 OpenAI 风格兼容接口
推荐应用场景 追求极限吞吐、官方性能的私有化/大规模推理服务 多模型混部、快速概念验证与轻量级业务服务

四、极简上手指南:从环境准备到离线推理实操

DeepInfer 目前以开源 C++/Python 源码形态提供,推荐在纯净的容器或虚拟环境中编译运行:

  1. 系统依赖确认:Linux 操作系统,GCC ≥ 13.0,Python 3.12。NVIDIA 平台需要安装 CUDA 13,华为昇腾平台则需配置 CANN 9.2。
  2. 拉取代码仓库:
    git clone https://github.com/deepseek-ai/DeepInfer.git
    cd DeepInfer
  3. 指定硬件加速器并执行编译:
    # 若使用 NVIDIA GPU
    export DEEPINFER_ACCELERATOR=nvidia
    # 若使用华为昇腾 NPU
    # export DEEPINFER_ACCELERATOR=ascend
    
    ./build.sh
  4. 权重加载与离线推理验证:
    # 指定本地权重路径或允许自动从 Hugging Face 下载
    export DEEPINFER_HF_MODEL_DIR="/data/models/DeepSeek-V4.1-Flash-1017"
    
    python examples/offline_inference.py

五、企业级生产落地核心场景

  • 金融与政企自主可控部署:原生支持华为昇腾 950 NPU,结合本地 3FS 存储集群,在彻底保障核心业务数据不出内网的同时,释放匹敌国际顶尖算力的推理吞吐。
  • 高并发长程 Agent 中台:96% 的前缀缓存命中率直接破解了复杂 Agent 循环工具调用中重复计算的成本死结,单 Token 综合调用成本显著下降。
  • 超长文档智能解析与代码审查:SWA Bounded Replay 使得数万行超长代码库的检索与长合同分析不再遭遇 Prefill 显存爆炸,维持首字秒开的极致体验。

📝 站长洞察 (Editor’s Insight)

在过去两年里,开源推理框架的竞争往往集中在算子优化与量化压缩层面。而 DeepInfer 的开源标志着大模型工程进入了“超大规模集群调度与存储解耦”的新纪元。DeepSeek 将生产线上处理 155 万亿 Token 的真实硬核架构无保留公开,尤其是 PD 分离与 3FS 分布式缓存的工程落地,直接击碎了传统推理服务对显存带宽的过度依赖。对于国内致力于大模型落地与私有化交付的架构师而言,DeepInfer 不仅是一个工具,更是搭建万卡时代高效高可用推理基础设施的标准蓝图。

Manifest AI
AntSK FileChunk开源工具:基于AI语义分析的智能文档切片,彻底告别传统分割的语义割裂
Ask Seneca
10Kh RealOmni-Open: Gen Robot.AI开源全球最大具身智能数据集(1万小时/95TB)
微软开源Fara-7B:70亿参数AI Agent自动操作电脑,效率飙升、隐私无忧
TAGGED:3FS分布式缓存DeepInferDeepSeekPD分离推理框架
分享
Email 复制链接 打印
Share
上一篇 网易有道开源低延迟真流式语音大模型 R2T2 架构与落子无悔机制全景实测 终结字幕闪烁与Voice Agent误执行!网易有道开源真流式语音大模型R2T2:首创落子无悔Append-Only机制、200ms极致延迟与多后端端侧部署全景实战
下一篇 火山引擎 Seedance 2.5 4K 视频生成模型官网展示与大荧幕级画质评测 大荧幕级质感与10-bit色彩!火山引擎重磅发布Seedance 2.5 4K视频生成模型:首创Draft样片试错工作流与影视级文戏微表情全景实测拆解
发表评价

发表评价 取消回复

您的邮箱地址不会被公开。 必填项已用 * 标注

Please select a rating!

Ad image
- 入群领取知识星球折扣卷, 仅剩99份 -
Ad imageAd image

最近更新

APUS AI Lab 开源 APUS-OpenJev-v1 端侧决策大模型架构与低延迟推理基准图
单卡P50延迟仅25ms且85%高精度反超商业API!APUS重磅开源端侧决策大模型OpenJev-v1:首创effort动态计算深度、候选感知投影与告别JSON幻觉全景实战深度拆解
AI 工具
Anthropic Claude Haiku 5.5 轻量级模型五档思考调节与电脑操作基准全景图
OSWorld狂飙至72.4%且综合成本狂降75%!Anthropic重磅发布新一代轻量旗舰Claude Haiku 5.5:五档自适应思考、百万长上下文与多子代理集群并行架构全景实测深度拆解
AI 工具
VoxMem 音频大模型长期记忆二维评测基准架构与声学证据多会话评测全景图
记住说了啥却忘了是谁说的!墨尔本大学重磅开源首个音频大模型记忆基准VoxMem:32K准确率不足40%、四维声学证据解耦与语音持久交互残酷真相全景深度拆解
最新趋势
StartLux Labs 开源决策模型家族 Startlux-Decision 官方架构与性能基准全景图
告别逐字生成算力浪费与黑盒幻觉!StartLux Labs重磅开源决策模型家族Startlux-Decision:单次前向毫秒级概率置信度、256K多模态长状态与Agent路由全景拆解
AIGC 资讯

相关推荐

AI 工具

华佗GPT

remaker
AI 工具

Tabnine

remaker
AI 工具AIGC 资讯

优必选开源具身智能大模型Thinker:4B参数9项基准全球第一,工业场景准确率99.99%

站外新闻
优必选 具身智能 开源大模型 机器人 视觉语言大模型
AI 工具AIGC 资讯

KittenTTS:仅25MB的开源TTS模型,CPU实时推理,离线语音时代来临

站外新闻
AI工具 开源模型 文本转语音 语音合成 边缘计算
/ Prompt 语宙 /

Experience the limitless creative possibilities of generative AI and unlock new levels of innovation.

Quick Link

  • Remaker AI
  • BGRemaker 抠图Hot
  • AIGC 工具
  • Prompt 咒语生成器
  • 去水印工具

Support

  • Contact
  • Blog
  • Complaint
  • Advertise

标签

AIGC Midjourney prompt AI Agent GPT Image 2 openai 多模态大模型 字节跳动 具身智能 AI绘画 EvoLink灵感 开源工具 开源模型 Anthropic 开源大模型 早报 大语言模型 强化学习 MoE架构 腾讯混元 AI智能体 阿里通义 多模态AI AI视频生成 chatgpt AI工具 开源框架 教程 扩散模型 世界模型
Prompt 语宙Prompt 语宙
Follow US
© 2009-2026 Prompt 语宙. Paooo.com. All Rights Reserved.