

💡 站外导读:在全球化内容出海与影视二次元文化传播中,传统机器翻译长期面临着两大不可逾越的鸿沟:一是机械直译导致社区弹幕、口语热梗与双关语意境全失;二是译文长短失控,配音时文字音节与原始视频画面口型严重错位,后期需要消耗大量人工进行反复删减调校。哔哩哔哩(B站)Index LLM 团队重磅开源了面向工业级落地的多语言翻译模型家族——Index-Translate。该项目基于 Qwen3.5 底座构建并全面采用 Apache-2.0 商业友好协议,不仅覆盖全球 150 种语言,更首创了目标音节可控的短视频配音翻译、跨语言音色保真克隆以及 64K 超长文档一致性维护,为内容创作者与泛娱乐出海提供了全栈式解法。
一、 工业级破局:为什么传统翻译大模型做不好“视频出海配音”?
在泛娱乐影视剧、动漫二次元以及个人 Vlog 的本地化出海工作流中,翻译从来不是单纯的文字置换:
- 声画时间轴失配:英文、日文与中文的语速和音节密度天差地别。一句仅需 2 秒念完的原版对白,常规机器翻译出的译文若需要念 4 秒,画面中的角色嘴型早已闭合,配音却还在喋喋不休;
- 说话人音色断层:传统级联链路需要先翻译文本,再交给通用 TTS 朗读,导致原片演员独特的声线魅力与情绪起伏荡然无存;
- 网络二次元热梗“机械化阵亡”:类似“结芬”、“狒瘾”等带有鲜明社区文化标签的梗,传统翻译工具要么死板直译为字面错字,要么直接判定为乱码过滤。
二、 Index-Homura 核心机理:音节预算显式注入与 81.92% 精准时长适配
为了从根本上攻克“对口型配音”的世纪难题,B 站团队在家族中推出了专门的子模型——Index-Homura:
- 音节预算显式条件注入:在提示词与模型前向传播中,显式传入目标镜头的精确音节数约束(Syllables Budget);
- 受限采样解码与动态句式重构:模型在生成译文的过程中,同步规划词汇挑选与句式倒装,自动将表达精简或扩充至预算范围内;
- 惊人的时长命中精度:在 SandGlass 评测集上,高达 81.92% 的输出音节偏差被严格控制在 10% 以内,剪辑师无需二次裁剪对白即可直接对齐原始视频帧。
三、 Index-Echo 与 NativeLong:原声音色克隆配音与万字长文前后一致
除了音节控制,Index-Translate 针对专业音视频管线进行了深度闭环设计:
- Index-Echo 语音配音:支持 S2ST(语音到语音)端到端翻译。系统在翻译语义的同时,直接提取源音频中说话人的高维声学嵌入向量,无缝注入 CosyVoice 语音合成模块,实现“带原声演员真实音色”的多国语言本土化配音;
- Index-NativeLong 原生长文档翻译:颠覆了传统“将长文本切块后分别翻译再拼接”的做法,直接借助 64K 超长上下文一次性通读全文。在整部小说或超长剧本翻译中,模型自主“记住”前文登场角色的中文译名与专有名词层级,彻底消除了前后人名翻译打架的低级错误。
四、 Index-Translate 与主流商用翻译方案全维对比
| 对比维度 | Index-Translate (B站) | Doubao-Seed-Translation (字节) | DeepL Pro (商业工具) |
|---|---|---|---|
| 开源状态与协议 | 完全开源 (Apache-2.0 免费商用) | 闭源商业 API (火山引擎独占) | 闭源商业 SaaS |
| 支持语言数量 | 150 种语言互译 | 28 种主流语言 | 30+ 种语言 |
| 视频音节对齐控制 | 原生支持 (Index-Homura 偏差<10%) | 不支持音节约束 | 不支持 |
| 说话人原声音色克隆 | 原生支持 (Index-Echo 语音管线) | 需外挂复杂 TTS 方案 | 不支持 (纯文本) |
| 长文档全文上下文 | 2B 支持 262K / 9B 支持 229K | 4K 上下文 (长文需手动切片) | 支持文件上传但按段处理 |
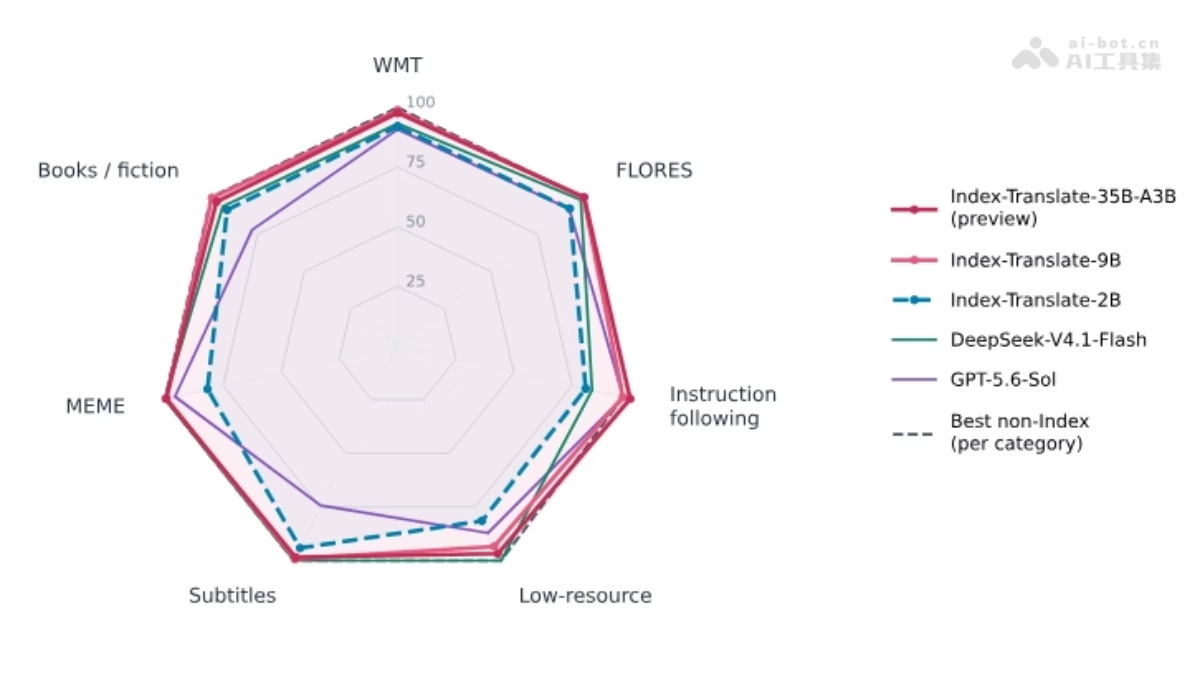
| 二次元与社区热梗优化 | 自建 MEME 评测优化 (懂梗翻得通) | 通用商务语料为主 | 学术商务正规文本 |
五、 生产实战:本地基于 vLLM 极速拉起与调用示例
Index-Translate 提供了 2B、9B 以及 35B-A3B 多种参数规格,单张消费级显卡即可轻松部署 2B 与 9B 模型:
# 1. 克隆代码仓库并安装依赖
git clone https://github.com/bilibili/Index-Translate.git
cd Index-Translate
pip install -U vllm -r inference/llm/requirements.txt

# 2. 本地拉起 2B 极速翻译服务
vllm serve IndexTeam/Index-Translate-2B \
  --host 127.0.0.1 \
  --port 8000 \
  --max-model-len 4096

# 3. 命令行调用音节可控视频翻译示例
python inference/llm/syllable_translate.py \
  --text "哔哩哔哩 (゜-゜)つロ 干杯~" \
  --target en \
  --syllables 8 \
  --model IndexTeam/Index-Translate-2B
📝 站长洞察 (Editor’s Insight)
B站此次开源 Index-Translate,展示了垂直场景模型对通用通用大模型的“降维打击”。传统大模型(如 GPT-4o 或通用翻译服务)虽然词汇量庞大,但在影视短视频剪辑与工业级配音管线中,根本无法解决“字数超标导致字幕溢出”或“音节失调导致配音嘴型对不上”的现实痛点。Index-Homura 将音节预算转化为模型生成的硬约束,而 Index-Echo 更是把说话人特征提取直接融入翻译管线,这种“图文音一体化协同”的设计理念正是内容工业化 AI 改造的核心所在。随着 Apache-2.0 的全面开放,无论是个人 Vlog 创作者还是出海短剧团队,都将迎来边际成本无限趋近于零的多语种本地化红利。
Index-Translate 主要解决什么问题?
它主要解决视频出海配音时的三类痛点:译文时长失控、口型与字幕不同步,以及传统翻译丢失原声演员音色。项目还针对长文档一致性和社区热梗翻译做了优化,更适合泛娱乐本地化场景。
Index-Homura 的音节控制效果怎么样?
文中给出的实测结果显示,Index-Homura 在 SandGlass 评测集上,81.92% 的输出音节偏差被控制在 10% 以内。这意味着译文更容易直接对齐原视频画面,减少后期人工删改。
Index-Translate 能用于商业部署吗?
可以。文章明确提到该项目采用 Apache-2.0 商业友好协议,且提供 2B、9B、35B-A3B 等不同规格,2B 和 9B 还可在单张消费级显卡上部署,适合本地化和生产环境试用。
跨语言配音如何保住原声感?
要同时保留说话人音色、韵律和停连习惯,不能只做文本翻译后 TTS。实操上通常先做语义对齐,再做音色迁移和时长控制,并用目标语言的自然发音规则修正重音与节奏。
64K长文翻译怎么防前后打架?
需要把长文拆成局部窗口,但保留全局记忆和术语表一致性。工程上可用分段翻译、跨段检索和全局校对三层机制,重点锁定人名、专有名词、指代关系和文风统一。
🌐 English Executive Summary — Bilibili Open-Sources Index-Translate: 150-Language Controlled Dubbing and Long-Form Consistency
Bilibili has open-sourced the Index-Translate suite, covering 150 languages and targeting syllable deviation under 10% for video dubbing. The release introduces Index-Homura for duration- and syllable-budget-controlled short-form dubbing, Index-Echo for cross-language dubbing that preserves original speaker timbre via end-to-end S2ST, and NativeLong for consistent terminology across 10,000+ character long-form translations. Built on Qwen3.5 under the Apache-2.0 license, it is positioned for content export, media localization, and community translation workflows.
- Index-Homura explicitly budgets syllables to keep dubbing timing and deviation within 10% for short videos.
- Index-Echo performs end-to-end cross-language dubbing while retaining speaker voice timbre for higher industrial usability.
- NativeLong improves long-document translation consistency by resolving name/term drift across thousands of characters.


