

💡 站外导读:如今不少产品团队拿到上百条 App Store 差评或客服工单后,习惯直接打包丢进 Claude Code 或设计助手,期待 AI“一键分析痛点并画出新版界面”。但省掉人工研究提炼这一步,代价究竟有多大?尼尔森诺曼集团(NN/g)今日公布的 96 组对照实证研究给出了冷峻答案:直接喂原始评论生成的界面,达标率显著落后 8.4 个百分点,很多关键业务约束甚至被大模型直接“忽略”。
一、 6×2 因子对照与双模型编排:NN/g 如何用 96 份盲测原型量化设计上下文
为了验证不同形态的研究上下文(Research Context)到底如何左右 AI 生成界面的真实可用性,NN/g 研究团队设计了一套极为严谨的 6 × 2 因子实验(共 6 种研究输入条件 × 2 类典型设计任务 × 每组 8 次独立随机生成 = 96 份独立 HTML 原型 `Prototype.html`)。在所有试验中,基础任务提示词与设计系统文件(`design.md`)保持完全一致,唯一改变的只有随提示词注入的用户研究资料。
在模型工程管线上,研究团队在无头模式(headless mode)下运行 Claude Code 脚本,刻意采用了工业界常见的“规划 + 构建双模型编排(Orchestration)”:先由规划模型 Claude Fable 5(high-effort)通读任务要求和研究上下文,撰写一份详尽的设计规格说明书(Spec);随后再交由构建模型仅依据该规格编写前端代码——构建模型完全看不见原始研究文件。单页航班改签表单由 Claude Sonnet 5 构建,多步移动电商结账流程则交由 Claude Opus 5.5 操刀,以规避复杂交互状态下的编码 Bug。
| 实验控制维度 | 任务一:航班改签单页表单 | 任务二:移动端电商多步结账流 | 双盲评测与质量控制机制 |
|---|---|---|---|
| 原始用户语料构建 | 从 Twitter US Airline Sentiment 随机抽取 100 条航班取消/改签推文 | 从 ShoppingAppReviews 检索 65 条结账评论 + 人为混入 40 条无关噪音评论 | 所有测试均使用独立全新会话(Fresh Session),零跨轮历史污染 |
| 人工+AI 提炼对照材料 | 由研究员借助 Claude Opus 5.5 归纳为 9 条研究发现与设计建议 | 由研究员归纳为 11 条研究发现与设计建议,分别导出 PDF/MD/Persona | 每条结论附带痛点描述、支撑评论频次及明确的设计修改建议 |
| 评分卡与模型栈 | 27 项非公开客观验收标准;Fable 5 规划 + Sonnet 5 构建 | 33 项非公开客观验收标准;Fable 5 规划 + Opus 5.5 构建 | 由未参与实验的 NN/G 高级管理者先盲看 5–10 个试点样本拟定评分卡 |
| 双盲独立交叉判分 | 人工点击浏览器逐项实测 vs Codex GPT-5.6-Terra(读代码引证) | 累计覆盖 96 份原型、共 2,880 次单项标准判定(排除 10 次不适用项) | 分歧项回溯核查并消除歧义重判后,人机评委达成约 96% 一致率 |
二、 77.9% vs 69.5%:实验结果揭示原始数据的“长尾盲区”与低估效应
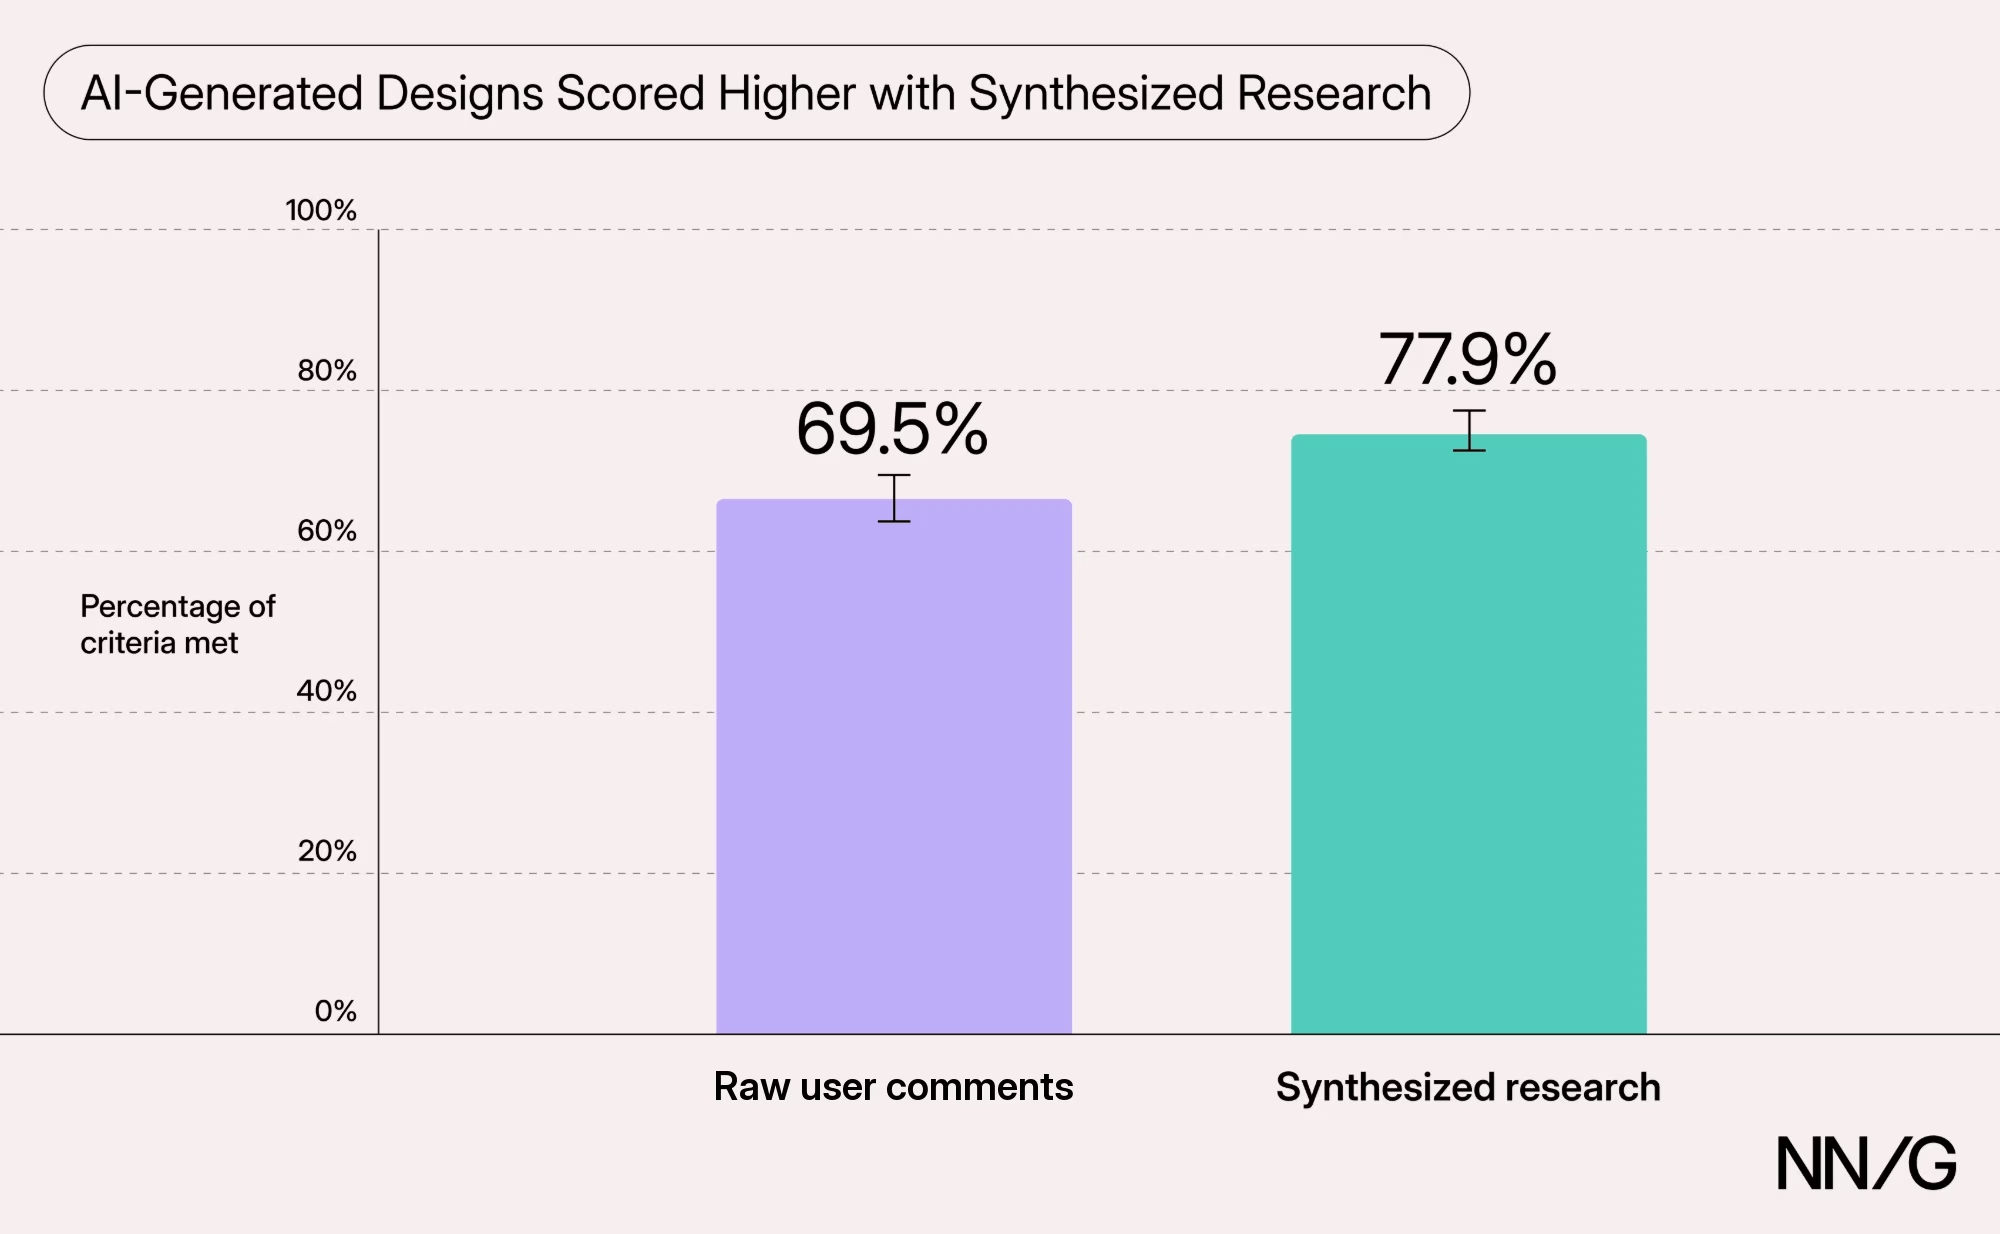
揭盲统计结果显示,向 AI 提供经过研究者提炼的研究发现与设计建议时,生成界面的平均评分卡达标率达到 77.9%;而直接投喂原始用户评论组仅达到 69.5%,两者相差 8.4 个百分点且具备极强统计显著性(p < 0.001)。其中,单页航班改签任务的提升尤为剧烈(高出 11.4 个百分点),电商多步结账任务则稳步提升 5.5 个百分点。
更值得警惕的是具体失效案例的分布。在航班改签任务中,有几条原始推文抱怨取消改签会影响常旅客里程积分——但直接接收原始评论生成的所有 8 个界面无一提及里程规则说明;反观使用提炼洞察组的全部界面,100% 都在改签卡片中清晰列出了积分影响提示。在电商结账流里,针对“结账途中购物车商品神秘消失”的用户抱怨,超过半数原始数据组原型未能保证每一步都展示所购商品与总价,而提炼洞察组几乎全部稳稳守住了这一底线。
NN/g 特别提醒,现实生产环境中的差距可能远不止 8.4 个百分点。原因有三:其一,本实验用的原始语料过于“干净”,超半数评论都指向有效发现,而真实应用商店评论中往往只有约三分之一包含对产品有用的信息;其二,每组样本仅约 100 条短评,远未达到大模型在数千条企业工单面前的注意力稀释极限;其三,机票改签与电商结账属于 AI 训练集中极度成熟的经典范式,若换成垂直 B2B 或复杂金融审批流程,仅靠原始反馈的失误率还会成倍放大。
三、 为什么喂再多原始反馈也救不了 AI?缺少“解释层”与多方权衡决策
表面看,大模型拥有超长上下文窗口和极强总结能力,似乎没必要再由人类研究员写一遍 Findings Deck 或 Markdown 报告。但 NN/g 在机理分析中指出了两个根本性瓶颈:
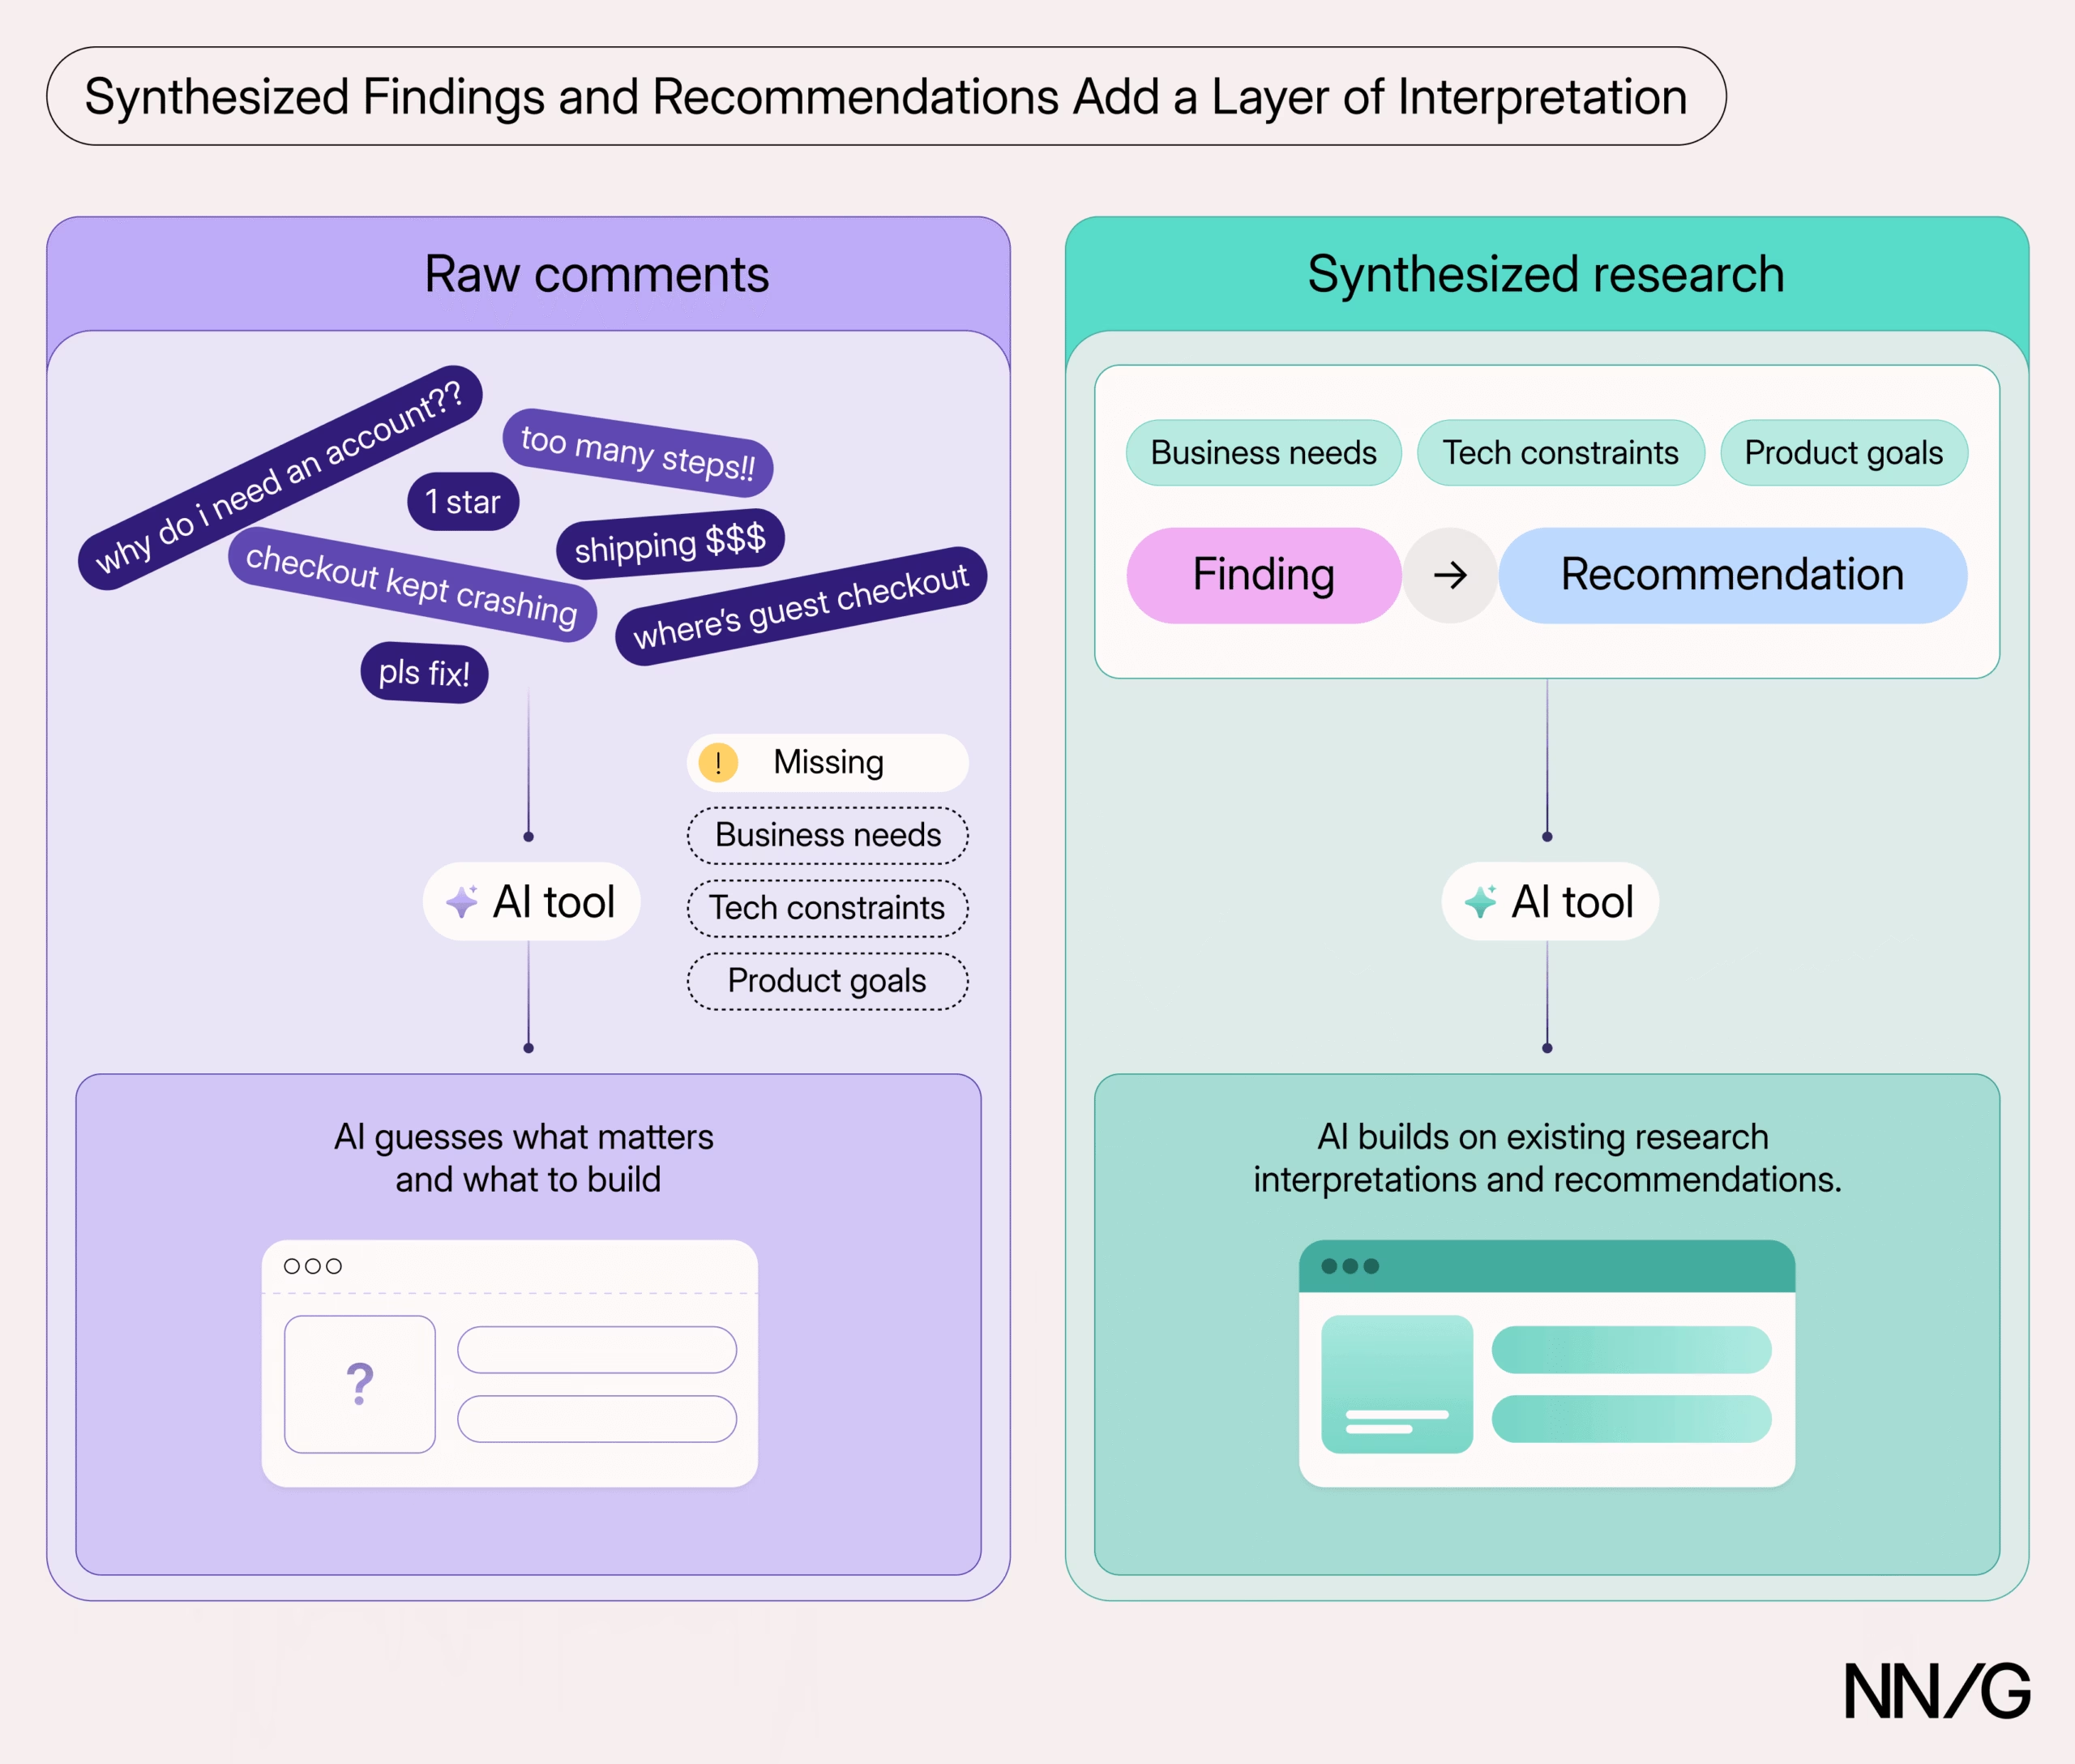
第一,原始用户数据里只有“现象观察”,没有“解法配方”。用户非常擅长吐槽哪里卡住了(例如“结算时购物车空了”),却极不擅长提出靠谱的改版方案;即便用户在评论里顺带提了某个功能建议,真实行为往往也与口头诉求背道而驰,再加上评论之间互相打架、夹杂大量情绪噪音,模型极易被少数声量大的情绪带偏。
第二,界面设计从来不是用户诉求的简单映射,而是商业目标、技术约束、产品路线与历史试错的多维权衡。提炼研究发现(Findings)解决的是“哪些现象真正在统计和体验上重要”,而撰写设计建议(Recommendations)则把这种解读直接翻译成了清晰的设计决策。如果不把这层人类判断塞进上下文,等于强迫 AI 在毫不知晓公司研发约束的前提下,在沙堆里自己瞎猜该优先修哪几个点。
四、 UX 上下文工程崛起:你的研究文档从此有了第二位读者——AI 工具
面对越来越高频的“AI 生成原型—快速迭代验证”工作流,NN/g 为产品与设计团队划出了一条必须正视的分水岭:研究交付物(Research Artifacts)现在同时拥有两位受众——人类同事,以及研发流水线上的 AI 工具。
团队不能再默认“把数据库或工单系统通过 MCP 接给大模型就算完成了上下文赋能”。能读大量原始文本,不代表模型知道如何挑出最关键的业务约束并准确落进 UI 组件里。设计团队必须系统性地践行 UX-Context Design(UX 上下文设计)——有意识地筛选、结构化组织并持续维护喂给 AI 的 UX 知识资产,例如明确区分哪些是经过定量频次验证的核心发现,哪些是强制落地的交互建议。
与此同时,NN/g 也坦诚列出了下一阶段待拆解的深水区研究问题:例如,提炼洞察带来的质量提升究竟有多少来自“归纳后的事实发现”,又有多少归功于“明确的设计建议”;将同一份结论封装成 Markdown、PNG 人物画像(Persona)还是 PDF 汇报胶片,对模型最终生成的界面精度会产生多大差异;以及面对动辄数千份用户访谈逐字稿和可用性测试笔记时,这套规律是否依然线性成立。
📝 站长洞察 (Editor’s Insight)
NN/g 用 96 份双盲原型和 2,880 次判分,给盲信“RAG 直连原始日志就能画好 UI”的团队泼了盆冷水。实验最警醒的是:哪怕用了 Claude Fable 5 规划与 Opus 5.5 构建,只要上游直接塞入未提炼的原始推文,“常旅客里程规则说明”等出现频次低却业务致命的长尾约束仍会在 100% 的输出里被丢弃。这再次印证:MCP 解决的是工具连上数据,上下文工程解决的才是模型按正确业务权重做权衡。未来 UX 研究员的核心壁垒不是画图手速,而是为 Agent 编写带决策权重的 ux-context.md 规范。
为什么直接喂原始用户评论给AI会降质?
因为原始评论只有现象和情绪,没有经过研究提炼的“解释层”和设计建议。模型容易被噪音、互相矛盾的反馈干扰,忽略关键业务约束,导致界面漏项或规则表达不完整。
NN/g这次实验用的是什么模型编排?
研究团队采用“规划+构建”双模型编排:先由Claude Fable 5读取任务与研究上下文,生成设计规格说明书,再交给构建模型按规格写代码;单页任务用Sonnet 5,多步结账流用Opus 5.5。
提炼后的研究洞察比原始评论强在哪里?
提炼材料会把痛点、频次和明确改法一起给到模型,帮助它抓住优先级和约束条件。实验中,这种方式把平均达标率从69.5%提升到77.9%,尤其改善了航班改签和结账流程中的关键遗漏。


