Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
阅读: 视觉智能为什么不能只靠静态图片?对话Black Forest Labs创始人:FLUX 3音画联合训练、扩散与自回归之争及世界动作模型全拆解
Share
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
Latent Space 对话 Black Forest Labs 核心创始人 Andreas Blattmann 与 Dustin Podell:从 FLUX 到视觉智能与世界动作模型
Prompt 语宙 > 强化 AI 学习 > 视觉智能为什么不能只靠静态图片?对话Black Forest Labs创始人:FLUX 3音画联合训练、扩散与自回归之争及世界动作模型全拆解
强化 AI 学习

视觉智能为什么不能只靠静态图片?对话Black Forest Labs创始人:FLUX 3音画联合训练、扩散与自回归之争及世界动作模型全拆解

Prompt 语宙研究院
最近更新: 2026年11月22日 下午8:09
Black Forest Labs FLUX 3 世界模型 多模态模型 扩散模型
SHARE
⚡ Prompt 语宙 AI 导读 · 30 秒核心看点
  • FLUX 3 不再只做静态图,而是把像素、运动、声音和动作预测放进同一底座联合训练。
  • Self-Flow 通过统一流匹配与蒸馏,兼顾多模态生成质量和推理效率,降低视频生成门槛。
  • FLUX Kontext 证明少量关系标注也能学会复杂编辑,且在身份保持与老照片修复上更贴近真实需求。

💡 站外导读:为什么靠文生图起家的实验室,要把算力全面押注到视频、原生音频与机械臂动作预测?在 Latent Space 最新长谈中,Andreas Blattmann 与 Dustin Podell 复盘了离开 Stability AI 创立 BFL 的历程,结合 FLUX 3 官方实证,深度拆解多模态视觉智能、扩散与自回归算力取舍及世界动作模型路线。

走出静态图像的感知天花板:为什么 FLUX 3 必须同时吞下像素、运动与声音?

接球直觉与“三模态联合投影”:单一传感器永远丢失另一半物理现实

当谈及为何不满足于把静态文生图做到极致、而是决意转向视频与世界模型时,Andreas Blattmann 抛出了一个极富物理直觉的“接球实验”:如果有人向你扔出一颗球,你在大脑写下抛物线微分方程之前,手臂就已经提前伸向了落点。这种无需显式符号推演的预测能力,正是 Black Forest Labs 所追求的“真实世界视觉智能(Real-World Visual Intelligence)”。按照 BFL 的底层工程哲学,没有任何一种单一模态能完整描述客观世界——静态图片只截取了某瞬间的空间结构,视频补齐了时间轴、动态轨迹与质量惯性,而音频则编码了纯视觉摄像头极易错过的机械碰撞因果关系(例如撞击声响精准锁定了物体接触的时刻)。

阅读目录
  • 走出静态图像的感知天花板:为什么 FLUX 3 必须同时吞下像素、运动与声音?
    • 接球直觉与“三模态联合投影”:单一传感器永远丢失另一半物理现实
  • 移动相机、抗闪烁视频超分与 FLUX Kontext:从几小时关系实验长出的工程护城河
    • 共用主干网络消除帧间抖动(Shimmer),从“狗戴帽子”先验撬动跨帧身份保持
  • 自回归 vs 扩散流匹配:算力账单与推理延迟的硬核取舍,以及 FLUX 3 早期战绩
    • 为训练阶段买单还是为推理出图速度买单?原生音画视频盲测直面国内外一线阵营
  • 从影视生成走向 2027 物理 AI 与机器人:FLUX-mimic 揭开世界动作模型路线图
    • 两条腿打通 Action Prediction,为什么灵巧机械臂与视频创作跑在同一个基座上
      • 📝 站长洞察 (Editor’s Insight)

如果只训练单模态模型,网络最多只是该孤立投影上的优秀拟合器;只有把图像、移动视频与声音信号放进同一套架构联合训练,模态之间的物理约束才会迫使模型学出背后共享的现实世界表征——声音必须严丝合缝匹配碰撞瞬间的画面,物体后续运动必须受制于此前帧中的质量与动量。为此,BFL 在 Self-Flow(高效对齐多模态生成与理解的统一流匹配方案)基础上大幅扩充算力与数据管线,打造出原生多模态底座 FLUX 3。据 BFL 官方博客披露,与常规 Flow Matching 基线相比,Self-Flow 在各模态上的生成 Fréchet 距离误差显著压低,且在后续微调下游操作任务时获得了明显更高的平均成功率,使单模型得以一口气打通最长 20 秒的 720p/1080p 原生音画视频、多语种精确口型对话、首尾及多关键帧控制以及低成本快速试错的 Draft Mode 草稿预览模式。
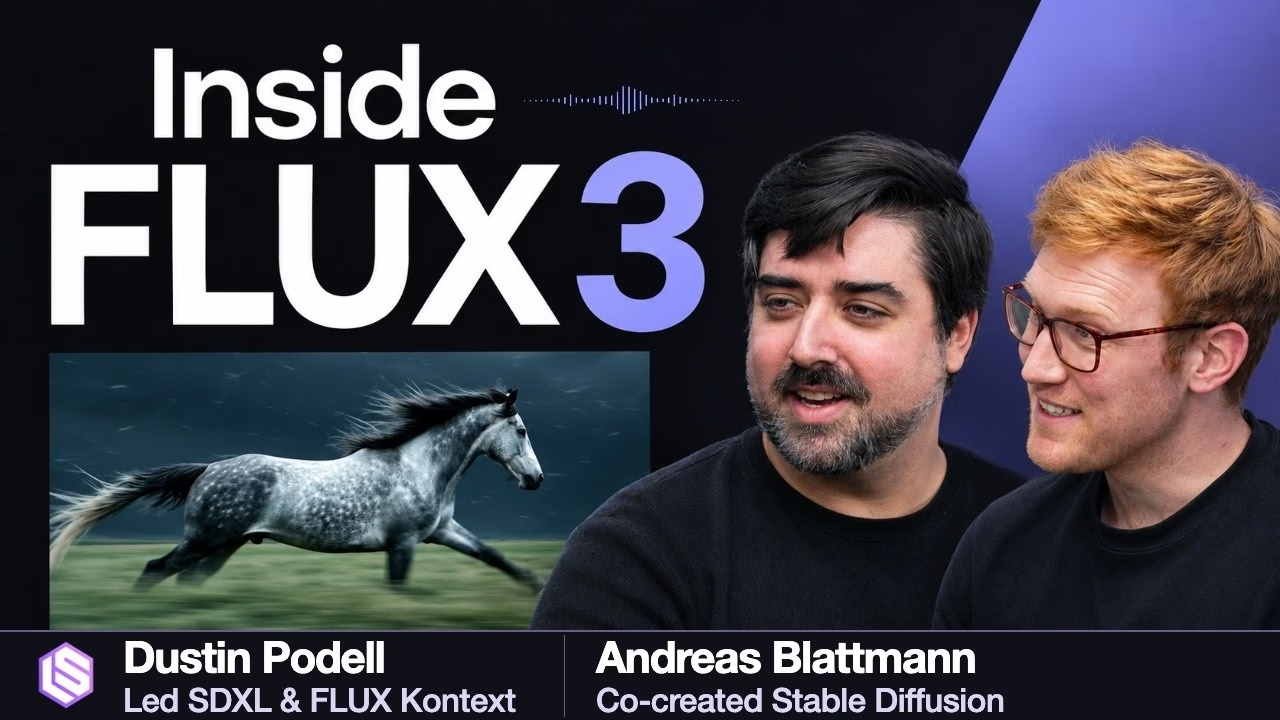
Latent Space 深度技术专访 Black Forest Labs 创始人封面:探讨从像素、运动与声音中构建视觉通用智能

移动相机、抗闪烁视频超分与 FLUX Kontext:从几小时关系实验长出的工程护城河

共用主干网络消除帧间抖动(Shimmer),从“狗戴帽子”先验撬动跨帧身份保持

在具体的模型工程拆解中,访谈披露了两个极易被外界忽视、却直接决定生成质量上限的技术细节。其一是“移动相机(Moving Camera)”蕴含的三维强监督信号:当镜头从人物正面平滑环绕到背后时,哪怕训练集只是普通的二维视频流,模型也必须在连续时间窗口里“欠账必还”,交出合理且结构一致的脑后部与空间遮挡关系——这比仅仅判断单张静态帧是否好看要严苛得多。其二则落在视频超分辨率(Upscaling)环节:如果把一段视频拆成单帧独立锐化,每一帧单独看都清晰锐利,但连起来播放却会因为超分器在相邻帧做出微小差异化脑补而剧烈闪烁(shimmer)。BFL 的工程解法是拒绝外挂独立超分模块,直接从同一个 FLUX 3 主干衍生出视频超分管线,借由原生时空一致性把 720p 输出无损升格至 1080p 全高清。

更令人拍案的是主力图像编辑模型 FLUX Kontext 的诞生秘辛。Dustin Podell 回忆,团队最初并没有直接铺开庞大标注工程,而是基于一个精巧的先验猜想:既然一个基础图像模型已经知道怎么画“戴着帽子的狗”,那它的隐空间里一定已经学懂了物体之间的空间附着关系。于是他与一位同事仅收集了极少量的关系标注照片,跑了一轮短短几小时的微调实验,验证模型能否学会“把指定 Logo 印到一件衬衫上”。尽管第一版效果略显粗糙,但验证出的强泛化潜质足以说服全队投入数月时间死磕数据清洗与模型迭代。最终上线后最令 Podell 动容的并非商业广告,而是大量普通用户拿 FLUX Kontext 修复泛黄破损的家族老照片——能在跨编辑与跨帧过程中牢牢守住一个人的面部身份特征,才是视觉工程真正被真实生活感知的时刻。
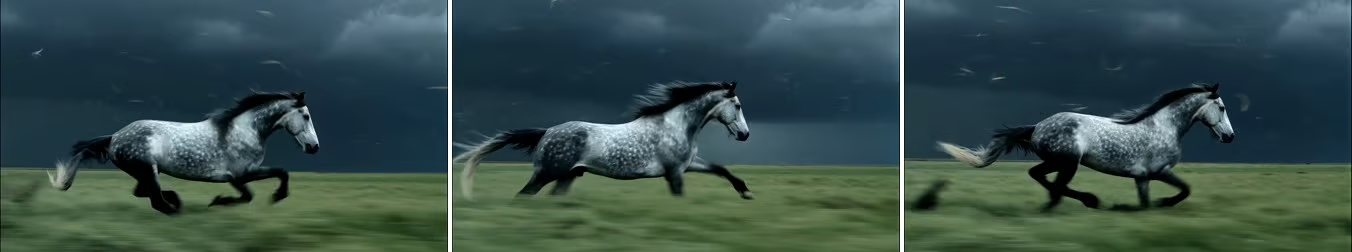
Black Forest Labs FLUX 3 跨图像、视频、原生音频与动作预测的统一多模态能力组图

自回归 vs 扩散流匹配:算力账单与推理延迟的硬核取舍,以及 FLUX 3 早期战绩

为训练阶段买单还是为推理出图速度买单?原生音画视频盲测直面国内外一线阵营

面对“大语言模型式自回归(Autoregressive)架构是否终将吞并图像与视频生成”的业界尖锐提问,Andreas Blattmann 给出了极其清醒的算力经济学回答。他坦承自回归架构拥有无可争议的训练端红利:单条训练样本中的所有 Token 都可以被并行纳入目标函数同步学习,信息利用率极高;但回到扩散与 Flow Matching 阵营,团队可以通过轨迹蒸馏(distillation)把原本漫长的多步采样过程一路压缩到仅仅“屈指可数的几步(a handful of steps)”,从而在推理端换来极低的端到端延迟与并发成本。换言之,两条路线的本质分歧并不在于审美偏好,而在于团队究竟愿意为“训练算力吞吐”买单,还是为“千万用户等待出图的推理账单”买单。

在商业化与评测进度上,BFL 披露的 FLUX 3 Video(10 秒 720p 原生音画文生视频)早期人类盲测偏好数据已经相当亮眼:在多组一对一盲测中,FLUX 3 面对 Luma Ray 3.2 拿下 93% 偏好率,面对 Runway Gen-4.5 达 77%,面对 Grok Imagine Video 为 69%,面对 Kling v3 Pro 达 60%,面对 Happy Horse v1 与 1.1 分别为 59% 与 57%,而在对比 Seedance 2.0 与 Gemini Omni Flash 时也保持了 52% 的微弱领先;随后的正式发布版评估中,其在图生视频维度上进一步实现与 Seedance 2.0 打平并领跑其余主流对手,同时支持含中文、英、日、德、法、西等十余种语言的精确口型同步与多镜头叙事切换。
BFL 官方 Self-Flow 与标准 Flow Matching 对比图:跨模态生成误差显著下降且机械臂操作任务微调成功率更高
技术范式 / 模型路线 核心训练信号与表征机制 训练与推理算力经济学取舍 时序一致性与物理 AI 延展能力
传统静态图像扩散模型 纯图文对空间分布学习,缺乏时间轴与声学因果约束 单图推理可蒸馏加速,但无法直接建模跨帧连续性 难以泛化至三维视角旋转与物理动作预测
拼接式视频生成与独立超分管线 帧间预测与后处理锐化割裂,各模块分别做局部决策 多管线串联维护复杂,叠加后处理增加端到端耗时 极易产生逐帧细节闪烁(Shimmer)与物理脱节
纯自回归(Autoregressive)视觉路线 离散/连续 Token 序列预测,单样本全 Token 并行监督 训练阶段样本利用效率高,但高分辨率长序列推理步数多、成本重 与语言同构易统一接口,但长程时序视觉保真度仍受序列长度制约
BFL FLUX 3 (Self-Flow 统一底座) 图像+移动视频+原生音频+动作四维对齐联合流匹配 Flow Matching 支持少步数蒸馏低延迟,配合 Draft Mode 分级省费 同主干超分消除闪烁,可直接作为 FLUX-mimic 机械臂动作基座
视觉智能主流技术路径对比与 Black Forest Labs FLUX 3 统一底座工程定位表

从影视生成走向 2027 物理 AI 与机器人:FLUX-mimic 揭开世界动作模型路线图

两条腿打通 Action Prediction,为什么灵巧机械臂与视频创作跑在同一个基座上

这场技术长谈最具有前瞻性的一幕,落在后半程关于“世界动作模型(World Action Models)”与 2027 机器人生态的推演上。BFL 团队明确指出,真正理解物理动力学、材料形变与三维遮挡的视频模型,与能够控制机器人完成精细操作的物理 AI(Physical AI),在底层表征上本就同源。在 BFL 的技术路线图里,通向动作预测(Action Prediction)正通过两条并行路径加速推进:一方面在 Self-Flow 框架内把原生动作预测直接整合进 FLUX 3 主模型;另一方面则把海量视频预训练出的动力学感知主干作为基础底座,让合作伙伴仅用有限的特定任务遥操作数据就能微调出高性能专用动作策略模型。

目前,BFL 已经与灵巧操作机器人企业 mimic robotics 联合推出视频-动作模型 `FLUX-mimic`,并开始在奥迪(Audi)的真实生产制造任务中展开验证测试。按照 BFL 公布的完整产品矩阵,接下来将围绕同一套多模态流匹配主干分批落地四大支柱:`FLUX 3 Video`(已开放 API 与精选合作伙伴接入的音画视频生成)、`FLUX-mimic & FLUX 3 Action`(面向科研与工业伙伴的动作预测)、`FLUX 3 Image`(图像合成与精细编辑)以及面向开源社区的多模态权重底座 `FLUX 3 Dev`。对于视觉大模型赛道而言,从“画一张好看的图”到“在统一架构内联合预测感知、语言与物理动作”,新一轮基础设施洗牌才刚刚鸣枪。

📝 站长洞察 (Editor’s Insight)

听完 Andreas Blattmann 和 Dustin Podell 这场长谈,最震撼的不是 FLUX 3 盲测胜率,而是欧洲这支视觉团队清醒的第一性原理工程观。许多团队还在把文生图、视频生成、超分和具身智能拆成四套模型各自内卷,BFL 却用 Self-Flow 死磕同一套现实世界表征,连抗闪烁超分与奥迪产线机械臂微调都长在同一主干上。更值得技术团队借鉴的是 FLUX Kontext 的起点:用一个“狗戴帽子”直觉,拿少量样本跑几小时验证先验可行性后再全力压上——这种低成本快速验真的研发纪律比盲目堆卡稀缺得多。

🧭 文中关联 AI 工具官网与参数卡(语宙 AI 导航)
Stability AI ↗
Stability AI提供多种开放模型,涵盖图像、视频、音频、3D物体和语言等领域,具有开放、免费、可定制等特
❓ 常见问题解答(FAQ)
FLUX 3 为什么要做视频和音频联合训练?

因为静态图片只能表达瞬间结构,无法覆盖运动轨迹、碰撞时刻和因果关系。把图像、视频、音频放进同一架构联合训练,模型才能学到共享的现实世界表征,提升多模态一致性与真实感。

Self-Flow 对 FLUX 3 的作用是什么?

Self-Flow 是 BFL 用来统一多模态生成与理解的流匹配方案。它帮助模型在图像、视频、音频等任务上获得更好的生成质量,并在后续下游操作任务中提升成功率,同时支持更高效的推理。

FLUX Kontext 适合做什么类型的图像编辑?

它适合需要保持主体身份和空间关系的编辑任务,例如给狗加帽子、把 Logo 印到衣服上、修复泛黄破损老照片等。其优势是能在跨编辑过程中尽量保住人物面部特征与对象关系。

🕸️ 语宙向量知识图谱 · 语义强关联深度内链
🎨 所属权威专题:Midjourney & Flux 咒语库 →
🏛️ Prompt 语宙研究院 · Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
📄 Markdown 纯净版
💡 这篇内容对您有启发吗?
📡 RSS 订阅✨ 提交 AI 工具 / 合作
🚀 Prompt 语宙 AI 创作者生态:探索 2,800+ 全球实用 AI 工具与高精度生图提示词咒语库
🧭 语宙 AI 导航 (ai.paooo.com)🎨 AI 生图 Prompt 库📚 核心专题导航⚡ AIGC 早报生成器
FLUX.1 Krea [dev] 开源:黑森林与Krea AI联手打造,照片级文生图模型,美学与真实感兼得
Elon Musk:被误解的领袖 [译]
RAPTOR:树状组织的递归抽象检索技术 [译]
从第一视角视频自学到全链路自我进化!智元机器人重磅发布GO-3 Preview:首创WRAM具身原生架构、斩获三项权威评测第一与年底开源规划全景深度拆解
AI 搜索可见度≠商业转化:38 组决策提示词实测,揭示企业为何因缺乏“深层证据链”痛失销售管道
TAGGED:Black Forest LabsFLUX 3世界模型多模态模型扩散模型
分享
Email 复制链接 打印
Share
Prompt 语宙研究院 头像
ByPrompt 语宙研究院
Follow:
Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
上一篇 Google 官方详解网站迁移至 CDN 如何避免爬虫流量激增打崩源站与误封 Googlebot 导致搜索掉收录 刚切上CDN源站反被爬虫打崩?Google官方拆解迁移翻车悖论:冷缓存雪崩、验证码误杀与预热止血指南
Ad image
Ad image

最近更新

Google 官方详解网站迁移至 CDN 如何避免爬虫流量激增打崩源站与误封 Googlebot 导致搜索掉收录
刚切上CDN源站反被爬虫打崩?Google官方拆解迁移翻车悖论:冷缓存雪崩、验证码误杀与预热止血指南
AI 工具
GitHub 正式上线 Repository insights 页面,集中展示 Copilot 代码审查采纳率与评论分类统计结果
AI代码审查到底有没有被采纳?GitHub上线Repository insights与repos-1-day API:四维信号、力度趋势及统计陷阱全拆解
AI 工具
Forrester AI 颠覆评估模型 17 大技术与服务品类分布图:呈现受颠覆、中立、争夺与加速四类市场象限及细分赛道数量
80%技术市场面临AI重塑冲击!Forrester拆解200+细分赛道颠覆矩阵:四大象限与Top 20合同采购谈判实战
最新趋势
Unsiloed AI 联合创始人 Adnan Abbas(左)与 Aman Mishra(右)合影,团队已完成 Felicis 领投的 750 万美元种子轮融资
olmOCR-Bench 88.0 登顶超越 GPT-5.5!Unsiloed AI 获 750 万美元融资:双流视觉模型与热图切片架构全拆解
最新趋势

相关推荐

谷歌DeepMind重磅开源TIPSv2:多模态模型SOTA,零样本分割领先,参数效率极高
AI 工具AIGC 资讯

谷歌DeepMind重磅开源TIPSv2:多模态模型SOTA,零样本分割领先,参数效率极高

Prompt 语宙研究院
Google DeepMind TIPSv2 图像-文本检索 多模态模型 零样本语义分割
PyTorch 加速生成式 AI 第二部分:高速 GPT [译]
强化 AI 学习

PyTorch 加速生成式 AI 第二部分:高速 GPT [译]

宝玉的分享
Llama PyTorch 大模型微调 开源大模型
展示 Gemma 在常用基准测试中的性能,与 Llama-2 的 7B 和 13B 版本进行了比较的图表
强化 AI 学习

Gemma:推出全新的顶尖开放模型 [译]

宝玉的分享
Gemini PyTorch TensorFlow 大模型微调 开源大模型
腾讯混元 hunyuan-large-vision:多模态视觉大模型,52B激活参数登顶国内榜首,重塑视觉理解与内容创作
AI 工具AIGC 资讯

腾讯混元 hunyuan-large-vision:多模态视觉大模型,52B激活参数登顶国内榜首,重塑视觉理解与内容创作

Prompt 语宙研究院
AIGC 多模态模型 大模型微调 腾讯混元 视觉理解
/ Prompt 语宙 /

探索生成式 AI 的无限创作潜能,一站式获取前沿 AIGC 资讯、高阶 Prompt 咒语与全球实用 AI 工具。

核心专栏

  • 语宙 AI 工具导航
  • EVA 视觉抠图工坊Hot
  • 出海数字营销宝典
  • AI 生图咒语灵感库
  • 24H 硅谷 AI 情报流

生态与服务

  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作

标签

开源大模型 AI智能体 AI办公效率 AI绘画提示词 OpenAI 大模型微调 Midjourney AI编程 stable diffusion AI视频生成 ChatGPT 3D与空间智能 HuggingFace AI音频与语音 RAG检索增强 Claude Flux AIGC Gemini 通义千问 Anthropic Llama Cursor DeepSeek Prompt AI Agent Kimi 智谱AI 具身智能 YouTube
Prompt 语宙Prompt 语宙
Follow US
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.