Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
阅读: 首创全网无全注意力层与单流狂飙2122Token!NaiveAI重磅开源309B MoE大模型Naive-N0.5-Flash:SWA+DSA混合稀疏、原生1M上下文与AI研发AI全景实测深度拆解
Share
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
NaiveAI 开源 Naive-N0.5-Flash 309B MoE 大模型架构与推理加速全景基准图
Prompt 语宙 > 最新趋势 > 首创全网无全注意力层与单流狂飙2122Token!NaiveAI重磅开源309B MoE大模型Naive-N0.5-Flash:SWA+DSA混合稀疏、原生1M上下文与AI研发AI全景实测深度拆解
最新趋势

首创全网无全注意力层与单流狂飙2122Token!NaiveAI重磅开源309B MoE大模型Naive-N0.5-Flash:SWA+DSA混合稀疏、原生1M上下文与AI研发AI全景实测深度拆解

Prompt 语宙研究院
最近更新: 2026年11月1日 下午2:07
AI研发AI MoE架构 Naive-N0.5-Flash NaiveRT 稀疏注意力
SHARE
⚡ Prompt 语宙 AI 导读 · 30 秒核心看点
  • 全网剔除全注意力层,SWA+DSA交替堆叠,兼顾1M上下文与长程召回。
  • 309B MoE仅激活15.5B参数,配合轻量索引器与三阶段训练提升效率。
  • NaiveRT投机解码实测单流2122 tokens/s,推理延迟显著低于常规框架。

💡 站外导读:当大语言模型的上下文窗口迈向 1M 甚至数百万 Token 时代,传统的 Full Attention(全局注意力)机制正在遭遇显存与算力的二次方复杂度(O(N²))死锁。业内多数团队选择粗暴的线性蒸馏或硬截断窗口,却往往付出长程召回断崖式下跌的惨痛代价。由 NaiveAI 开源的 309B MoE 大模型 Naive-N0.5-Flash,不仅彻底在全网络中剔除了全局注意力层,更通过 SWA(滑动窗口注意力)与 DSA(动态稀疏注意力)的交替混合堆叠,打通了原生 1M 超长序列处理与单流 2,122 tokens/s 的极致吞吐,展现了“AI 自主研发 AI(AI4AI)”的惊人工业化潜力。
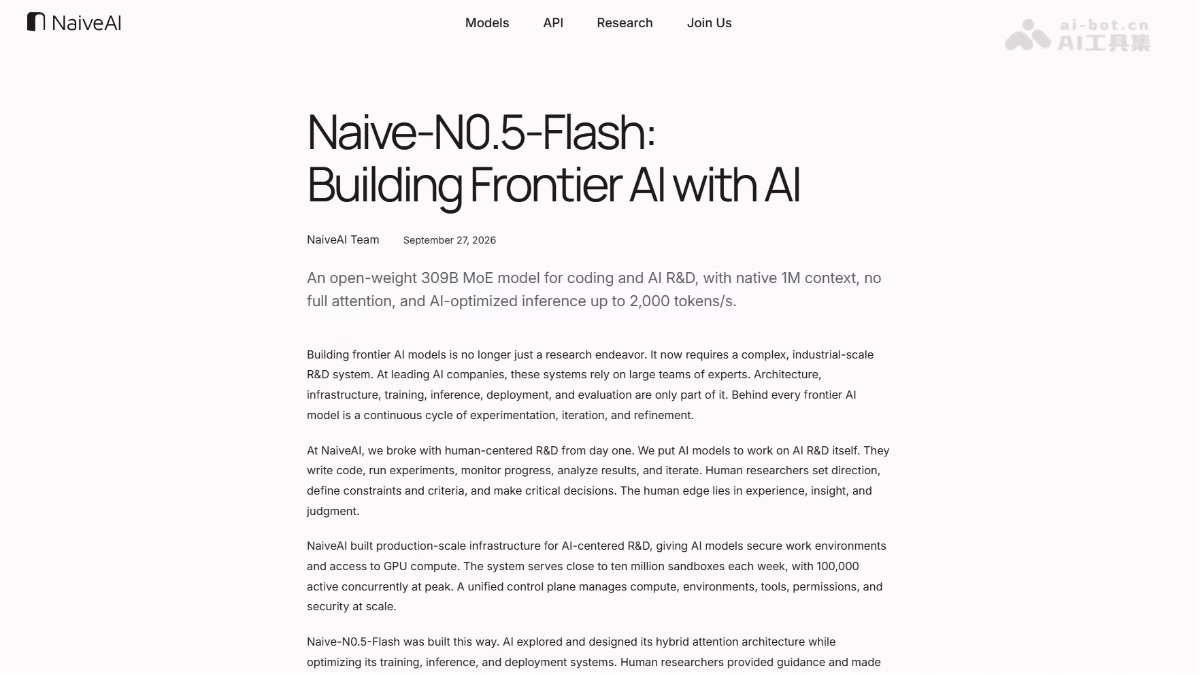
NaiveAI 开源 Naive-N0.5-Flash 309B MoE 大模型架构与推理加速全景基准图

阅读目录
  • 一、告别 O(N²) 显存噩梦:全网络剔除全局注意力的架构革命
  • 二、底层工程解密:轻量索引器、三阶段渐进训练与算子级卸载
  • 三、推理栈极致压榨:NaiveRT 投机解码与 2122 tokens/s 吞吐实测
  • 四、全维基准横评:Naive-N0.5-Flash vs 同级主流开源模型
  • 五、企业级生产部署指南与硬件选型规范
      • 📝 站长洞察 (Editor’s Insight)

一、告别 O(N²) 显存噩梦:全网络剔除全局注意力的架构革命

在当前的长程编程、跨代码库重构以及长周期智能体(Agentic Workflow)任务中,百万级别上下文已不再是实验室玩具,而是生产级环境的刚需。然而,全注意力机制在序列长度膨胀时,KV Cache 的显存驻留开销与计算复杂度呈指数级爆炸,使得线上部署成本高昂且首字延迟难以承受。

Naive-N0.5-Flash 采取了极其激进却经过严密数学论证的结构重组路线。该模型基于小米 MiMo-V2.5 基础架构进行深度重构,总参数量达 309B,每个 Token 仅动态激活 15.5B 专家参数(约 5% 稀疏比),并实现了全网络 0 全注意力层(Zero Full-Attention Layers):

  • SWA(滑动窗口注意力):负责捕获连续局部语境,窗口大小锁定为 128 Token,保证浅层语法解析与短语关联的极致轻量。
  • DSA(动态稀疏注意力):负责穿透超长历史,由轻量化索引器对全部历史 Token 动态打分,精准召回权重最高的 top-2048 Token 注入主干计算。
  • 5:1 交替交织堆叠:模型将 SWA 与 DSA 按照 5:1 的周期比例交替编排,在完全剔除全局注意力层的前提下,彻底攻克了“大海捞针”长程记忆衰减难题。

二、底层工程解密:轻量索引器、三阶段渐进训练与算子级卸载

为了让 309B 庞然大物在 1M 上下文下兼顾训练收敛速度与数值稳定性,NaiveAI 团队联合其 AI 研究 Agent 设计了三项底层工程核心技术:

  1. 轻量化索引器重构:传统的 DSA 索引常依赖高算力开销的 MLA(多头潜变量注意力),Naive-N0.5-Flash 将其重构为 GQA(分组查询注意力),将查询头从 64 个骤降至 16 个。这一改进直接让索引路径的选择耗时削减了 44%,而在长程 Agent 评测任务中没有任何召回损失。
  2. 三阶段渐进式对齐与预训练:
    • 阶段一(50B Token 知识注入):冻结主干权重,利用 KL 散度损失,将轻量索引器的注意力分布与标准全注意力进行高保真拟合;
    • 阶段二(3T Token 稀疏继续预训练):切换为纯稀疏注意力机制,注入 3 万亿 Token 的高质量代码与研发语料,完成信息检索路由的物理收敛;
    • 阶段三(200B Token 研发精调):以 1M 完整上下文进行监督微调(SFT)并平滑退火学习率,全流程由 AI 驱动 Top-K 召回与梯度异常监控。
  3. 算子级激活卸载与 Halo 序列并行:针对 SWA 只需局部窗口而 DSA 需全局扫描的异构特性,系统分别部署定制化的 Halo 序列并行方案。在显存侧将激活卸载粒度细化至算子级,并显式固化 Top-K 索引,避免反复重计算引入随机抖动。在 512 张 GPU 集群下,仅耗时约 4 天即可高质量吞吐 1T Token。

三、推理栈极致压榨:NaiveRT 投机解码与 2122 tokens/s 吞吐实测

针对 MoE 模型长上下文推理中的访存受限(Memory Bound)瓶颈,官方同步开源了专为该架构量身定制的 NaiveRT 推理引擎,在工程实现上带来了多项关键飞跃:

  • 巨型算子融合(Mega-Kernel Fusion):将多头注意力打分、Top-K 筛选与专家路由内核深度融合,杜绝多余的全局显存往返(HBM Roundtrip)。
  • PDL 上下流 Kernel 物理重叠:通过流水线依赖重叠(Program Dependency Loading),使上一个 Token 的投机校验与下一个 Token 的草稿生成在 GPU 计算核心上并发推进。
  • 逐位确定性采样(Bit-level Deterministic Sampling):完美支持按随机种子逐位对齐,使得强化学习(RL)探索环境中的 Rollout 采样与最终训练的 Logprob 完全一致,彻底终结了分布式训练中的浮点对齐漂移。

实测数据显示,在标准推理模式下,NaiveRT 输出稳定在 50 tokens/s;而在极速投机解码模式下,单流解码峰值狂飙至 2,122 tokens/s,单轮解码延迟从业内常见框架的 12.3ms 大幅压缩至 3.4ms,较 SGLang 延迟降低达 72.4%。

四、全维基准横评:Naive-N0.5-Flash vs 同级主流开源模型

评测维度 Naive-N0.5-Flash DeepSeek-V4.1-Flash 行业基准常规 MoE
底层核心架构 SWA + DSA 混合稀疏,0 全注意力层 轻量 MoE + 动态稀疏混合 标准 Dense / 全注意力 MoE
总参数 / 激活参数 309B / 15.5B (约 5% 激活) 约 300B+ / 动态激活 70B~236B / 14B~28B
原生上下文长度 原生 1,000,000 (1M) Tokens 128K ~ 256K Tokens 32K ~ 128K Tokens
单流解码峰值速度 2,122 tokens/s (NaiveRT) 约 150 ~ 280 tokens/s 40 ~ 90 tokens/s
投机解码单轮延迟 3.4 ms 约 8.5 ms 12 ~ 25 ms
NL2Repo 代码基准得分 71.9 分 68.4 分 61.2 分
AI 研发能力 (PaperBench) 63.2 分 (MLE-bench: 73.7%) 专项数据未公开 约 45 ~ 52 分
研发驱动范式 人类定目标 + AI 闭环研发 (AI4AI) 传统人类算法团队主导 传统人工训练微调

五、企业级生产部署指南与硬件选型规范

针对希望将 Naive-N0.5-Flash 引入私有代码审查、自动化架构演进与长流程 Agent 系统的团队,建议遵循以下标准部署 SOP:

  1. 显存与算力配置:推荐采用支持 FP8 混合精度的集群环境(如 NVIDIA H100/H800/H200 或 L40S 阵列)。FP8 量化权重体积约为 315GB,为承载 1M 极长上下文的 KV Cache 与投机解码缓冲区,建议单节点配备 8×80GB 显存规格。
  2. 环境依赖快速就绪:
    pip install "transformers[torch,kernels]>=5.17.0" accelerate vllm
  3. 模型实例化与加载:通过 HuggingFace 或 ModelScope 拉取 NaiveAI/Naive-N0.5-Flash-FP8,指定 trust_remote_code=True 与 device_map="auto"。
  4. 生产级吞吐释放:若业务场景需要压榨出 2,000+ tokens/s 的极速体验,需直接拉取官方 NaiveRT Docker 镜像,并配合 CUDA Graphs 与 Flash-Linear-Attention 内核启用极速投机服务通道。

📝 站长洞察 (Editor’s Insight)

Naive-N0.5-Flash 的发布在业界投下了一枚深水炸弹,其最震撼之处并不仅在于它将单流解码速度推高到惊人的 2,122 tokens/s,而在于它彻底打破了“长上下文必须依赖全注意力”的教条主义。更值得深思的是其背后的研发组织范式——这是一个由人类制定技术指标与验证协议,而具体架构拓扑试错、超参调优、Top-K 动态召回诊断全由 AI 智能体端到端自我迭代打磨出的生产级基模。从 SRE 与系统工程的视角来看,随着模型参数与上下文长度的爆炸,依靠人工逐层分析 Profiler 已经遭遇效能瓶颈,这种“代码可解释、系统自优化、AI 研发 AI”的正反馈闭环,正在成为下一代前沿大模型工程进化的最强护城河。

❓ 常见问题解答(FAQ)
Naive-N0.5-Flash为什么能支持1M上下文?

核心在于完全取消全注意力层,改用SWA局部窗口与DSA动态稀疏召回的混合堆叠。这样既避免了O(N²)显存与算力爆炸,又能通过top-2048历史Token检索维持长程信息能力。

Naive-N0.5-Flash的SWA和DSA分别做什么?

SWA负责128 Token窗口内的局部语境建模,适合短语和语法关联;DSA则对全历史Token进行动态打分,召回最重要的top-2048 Token注入主干计算。两者按5:1交替堆叠。

NaiveRT的2122 tokens/s实测意味着什么?

这说明该推理引擎在极速投机解码模式下具备极高吞吐,单流生成速度达到2122 tokens/s,延迟压缩到3.4ms,适合对长上下文和低时延都有要求的生产级推理场景。

🔬 语宙深潜追问 · 进阶实操拆解
超长上下文如何避免注意力失真?

关键是分层记忆:近端用高密度注意力保细节,远端用稀疏路由和摘要记忆保全局。再配合位置编码校准、检索增强与分段压缩,才能在1M上下文里兼顾召回率和推理稳定性。

2122 tokens/s适合哪些生产场景?

更适合高并发检索、批量摘要、代码补全和长文档问答这类吞吐优先任务。若是高精度推理或强一致性生成,仍要看首token延迟、输出稳定性和显存成本,不能只盯峰值速度。

🗳️ 读者观点微投票 · 您的实战立场是?
1M上下文真能替代全注意力吗?
🕸️ 语宙向量知识图谱 · 语义强关联深度内链
  • Ling-2.6-flash:蚂蚁百灵打造‘干活’模型,104B参数仅激活7.4B,Token效率碾压同行
  • 2800亿MoE仅激活140亿且原生百万长上下文!百度重磅开源文心5.5 Flash Base:首创Latent-Gated稀疏注意力、ECHO序列外推与全基准同尺寸SOTA全景架构深度拆解
  • 180B 参数激活仅 6B!基元律动发布 Agent 原生模型 NeoHorse-1.5-Flash:首创“第二圈”递归自我改进闭环、ALE 飙升 9.2 分与 NL2Repo 软件工程实测全景拆解
  • 560B参数每步仅活25B且原生百万长文本!蚂蚁百灵发布Ling-3.2-flash:首创KDA记忆召回与视觉-执行闭环架构全景深度拆解
🌐 English Executive Summary — NaiveAI Open-Sources 309B MoE with Full Attention-Layer Elimination and 1M Context

NaiveAI has open-sourced its flagship 309B Mixture-of-Experts model, Naive-N0.5-Flash, reporting the first full-network removal of attention layers while maintaining native 1M-context capability. The model uses a hybrid SWA+DSA sparsity design with alternating stacking, activates only 15.5B parameters, and employs a lightweight indexer plus a three-stage training pipeline. In NaiveRT speculative decoding, it achieves 2,122 tokens/s in single-stream throughput with substantially reduced inference latency.

  • First reported full-network elimination of attention layers while supporting native 1M context.
  • Hybrid SWA+DSA sparsity with alternating stacks and efficient MoE activation (15.5B active of 309B).
  • NaiveRT speculative decoding demonstrates 2,122 tokens/s single-stream throughput with lower latency.
🏛️ Prompt 语宙研究院 · Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
📄 Markdown 纯净版
💡 这篇内容对您有启发吗?
📡 RSS 订阅✨ 提交 AI 工具 / 合作
🚀 Prompt 语宙 AI 创作者生态:探索 2,800+ 全球实用 AI 工具与高精度生图提示词咒语库
🧭 语宙 AI 导航 (ai.paooo.com)🎨 AI 生图 Prompt 库📚 核心专题导航⚡ AIGC 早报生成器
科大讯飞发布讯飞星火X2:国产算力赋能,数学推理与多语言能力比肩国际顶尖
人均配百个Agent且直面认知过载!微软纳德拉预言2000万智能体入驻企业:自研Agent调度开发环境、长程自治演进与人机共生架构全景深度拆解
告别Vibe Coding虚火!Optimizely解密企业级营销智能体落地法则:从“输出审核”走向“输入约束”、专用Harness架构与800落地页规模化实战
诊断准确率 83.2% 碾压全科医生两倍!微软重磅发布医疗多智能体系统 MAI-DxO 荣登《Science》:顺序诊断 SDBench 与虚拟会诊降本全景深度拆解
谷歌DeepMind推出AlphaProof Nexus:AI攻克56年数学悬题,颠覆科学发现范式
TAGGED:AI研发AIMoE架构Naive-N0.5-FlashNaiveRT稀疏注意力
分享
Email 复制链接 打印
Share
Prompt 语宙研究院 头像
ByPrompt 语宙研究院
Follow:
Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
上一篇 微软推出专为结构化决策与 Agent 编排设计的 Microsoft-Decision-1 架构全景图 速度狂飙35倍且输出完全免费!微软重磅发布新一代AI决策模型Microsoft-Decision-1:36项基准登顶第一、毫秒级概率评分与Agent路由编排全景拆解
下一篇 生数科技新一代旗舰视频生成大模型 Vidu Q4 Preview 官方产品与生成实操界面 15图+3音频多主体一致性创业界纪录!生数科技重磅发布旗舰视频大模型Vidu Q4 Preview:首创U-ViT端到端音画同出、4K 10-bit影视级运镜全景实测拆解
Ad image
Ad image

最近更新

Latent Space 对话 Black Forest Labs 核心创始人 Andreas Blattmann 与 Dustin Podell:从 FLUX 到视觉智能与世界动作模型
视觉智能为什么不能只靠静态图片?对话Black Forest Labs创始人:FLUX 3音画联合训练、扩散与自回归之争及世界动作模型全拆解
强化 AI 学习
Google 官方详解网站迁移至 CDN 如何避免爬虫流量激增打崩源站与误封 Googlebot 导致搜索掉收录
刚切上CDN源站反被爬虫打崩?Google官方拆解迁移翻车悖论:冷缓存雪崩、验证码误杀与预热止血指南
AI 工具
GitHub 正式上线 Repository insights 页面,集中展示 Copilot 代码审查采纳率与评论分类统计结果
AI代码审查到底有没有被采纳?GitHub上线Repository insights与repos-1-day API:四维信号、力度趋势及统计陷阱全拆解
AI 工具
Forrester AI 颠覆评估模型 17 大技术与服务品类分布图:呈现受颠覆、中立、争夺与加速四类市场象限及细分赛道数量
80%技术市场面临AI重塑冲击!Forrester拆解200+细分赛道颠覆矩阵:四大象限与Top 20合同采购谈判实战
最新趋势

相关推荐

仿真刷榜近满分,真机落地即翻车?商汤实测揭秘 GPT-6-Astra 具身智能断崖:12大仿真与8款机械臂体检,状态误判痛点与 RoboRSI 递归自愈破局
最新趋势

仿真刷榜近满分,真机落地即翻车?商汤实测揭秘 GPT-6-Astra 具身智能断崖:12大仿真与8款机械臂体检,状态误判痛点与 RoboRSI 递归自愈破局

Prompt 语宙研究院
GPT-6-Astra RoboRSI 世界模型 具身智能 商汤科技 机器人评测
实时动态交互遭遇滑铁卢!英伟达携手UT-Austin发布Realtime-Bench:最强GPT-6 Astra成功率仅44%、盲目堆算力失效与时机博弈全景评测深度拆解
最新趋势

实时动态交互遭遇滑铁卢!英伟达携手UT-Austin发布Realtime-Bench:最强GPT-6 Astra成功率仅44%、盲目堆算力失效与时机博弈全景评测深度拆解

Prompt 语宙研究院
GPT-6 Astra Realtime-Bench 大模型评测 实时交互 英伟达
用户交出密码遭里程盗刷风险与触碰FAA合规红线!美联航重磅封杀个人AI智能体代订机票:账号凭证共享漏洞、真人行李确认法规死锁与企业零信任防御全景深度拆解
最新趋势

用户交出密码遭里程盗刷风险与触碰FAA合规红线!美联航重磅封杀个人AI智能体代订机票:账号凭证共享漏洞、真人行李确认法规死锁与企业零信任防御全景深度拆解

Prompt 语宙研究院
AI Agent 网络安全 美联航 自主智能体 零信任
DeepScientist:西湖大学发布全自动AI科学家系统,实现科研流程全自动化
AI 工具AIGC 资讯最新趋势

DeepScientist:西湖大学发布全自动AI科学家系统,实现科研流程全自动化

Prompt 语宙研究院
DeepScientist 全自动AI科学家 多智能体架构 西湖大学 贝叶斯优化
/ Prompt 语宙 /

探索生成式 AI 的无限创作潜能,一站式获取前沿 AIGC 资讯、高阶 Prompt 咒语与全球实用 AI 工具。

核心专栏

  • 语宙 AI 工具导航
  • EVA 视觉抠图工坊Hot
  • 出海数字营销宝典
  • AI 生图咒语灵感库
  • 24H 硅谷 AI 情报流

生态与服务

  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作

标签

开源大模型 AI智能体 AI办公效率 AI绘画提示词 OpenAI 大模型微调 Midjourney AI编程 stable diffusion AI视频生成 ChatGPT 3D与空间智能 HuggingFace AI音频与语音 RAG检索增强 Claude Flux AIGC Gemini 通义千问 Anthropic Llama Cursor DeepSeek Prompt AI Agent Kimi 智谱AI 具身智能 YouTube
Prompt 语宙Prompt 语宙
Follow US
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.