

💡 站外导读:在生命科学计算领域,如果说蛋白质结构预测因 AlphaFold 的问世而步入成熟期,那么更具动态多样性、掌控遗传调控与生命起源奥秘的 RNA(核糖核酸)则始终是 AI 攻坚的“未开垦暗区”。中国科学技术大学研发团队在生命科学与人工智能交叉领域取得里程碑式突破,其自研的开源 RNA 序列基础模型 structRFM 核心成果正式荣登国际顶级科学期刊《自然》(Nature)。不仅在 2100 万条高质量配对数据上实现了序列与微观折叠的统一双重预训练,团队更将全部权重、源码与训练集彻底开源,打破了全球生物医药底层基座的技术垄断。
攻坚生命科学深水区:为何 RNA 结构预测是比蛋白质更硬的骨头?
在生物化学的中心法则与生命调控图谱中,RNA 早已超越了传统教科书中“遗传信息传递中介”的单一定位。从 mRNA 疫苗、非编码 RNA 的转录后调控,到基因编辑工具 CRISPR-Cas 系统的导向 RNA(gRNA),RNA 大分子直接参与并调控着细胞内极其精密的生命活动,是当前全球创新药研发竞相角逐的下一代核心战略靶点。
然而,与氨基酸序列相对规整、依赖固定化学键约束的蛋白质不同,RNA 分子仅由四种基础核苷酸(A、U、C、G)构成,其构象柔性极高,极易在细胞生理环境中发生复杂的动态折叠、微观假结(Pseudoknots)以及多重构象跃迁。传统的 X 射线晶体学或冷冻电镜(Cryo-EM)解析实验耗时长达数月且费用高昂,而过往基于热力学自由能最小化算法的计算生物学工具在长程依赖预测上面临极其严峻的组合爆炸困境,精准解析 RNA 二级结构与立体构象一直是阻碍前沿新药发现的底层绊脚石。
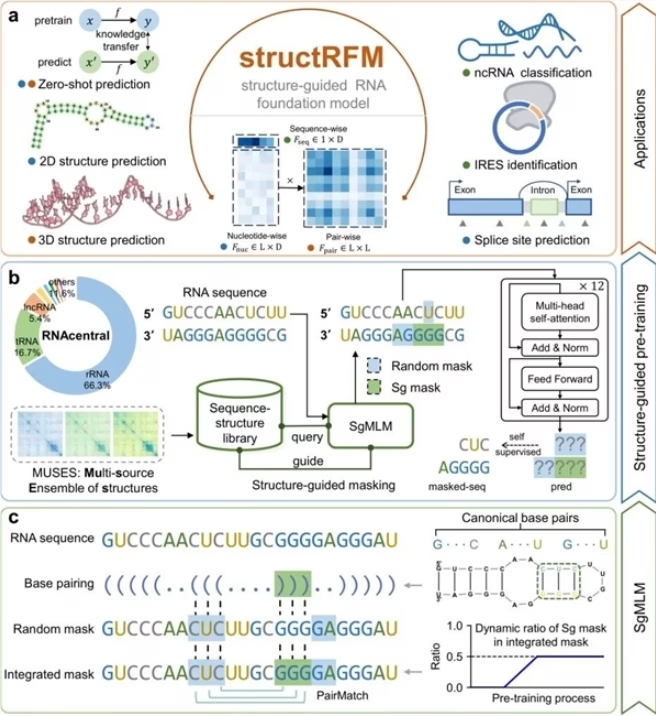
2100 万配对数据铸就基石:structRFM 的双模态联合预训练架构
面对这一世纪难题,中国科学技术大学科研团队从数据基建与预训练算法层面做出了根本性创新。为了解决生物界长期面临的“结构标注真值数据极度匮乏”的瓶颈,团队构建了包含约 2100 万条经过高精计算注释的“序列-二级结构配对数据集”,构筑起迄今为止全球规模最大、质量最高的 RNA 高精度基石底座。
在此坚实的数据基座之上,structRFM 首创了双重掩码与多粒度注意力融合架构:
- 序列上下文与拓扑结构协同自监督学习:在模型预训练阶段,算法不再将 RNA 粗暴视为单纯的一维文本字符串,而是将序列局域环境与由氢键折叠形成的复杂接触拓扑矩阵进行同步编码,强制模型学习碱基配对的深层物理约束;
- 三阶特征自动联合提取:在下游推断中,研究人员仅需输入任意一段一维未折叠序列,structRFM 即可端到端秒级输出“序列级全局表征”、“核苷酸级局部特征”以及“核苷酸对级(Pairwise)几何约束特征”的三阶联合张量;
- 强大的长程抗噪与长序列泛化:通过引入自适应分段注意力机制,structRFM 成功将计算边界扩展至成千上万碱基的长链非编码 RNA(lncRNA),有效克服了传统模型在超长序列下的注意力弥散缺陷。
| 核心评估维度 | 传统单模态/热力学预测模型 | 中国科大 structRFM 双模态预训练模型 |
|---|---|---|
| 预训练数据广度与深度 | 仅依赖数千条实验真值,泛化能力极其受限 | 2100 万条精确注释的配对数据,覆盖海量多样性物种 |
| 结构预测范式机制 | 单纯一维语言模型,缺乏真实的二维/三维拓扑感知 | 序列与微观折叠双重预训练,内化物理化学热力学因果律 |
| 三维立体构象协同赋能 | 二级与三维割裂,误差逐级放大且无法反向校准 | 特征直接嵌入 3D 预测管道,三维空间分辨率与精度大幅跃升 |
| 开源透明度与全球可及性 | 商业药企或闭源云服务,关键数据与权重严格保密 | 数据集、模型权重、代码 100% 全量开源,零门槛免费使用 |
多任务全能基座:从剪接位点推演到 3D 构象协同优化的临床跃迁
在严苛的国际科学基准测试与跨机构消融实验中,structRFM 展现出了令人惊艳的多任务通用赋能实力。在零样本同源性分类测试中,模型以显著优势刷新国际 SOTA;在下游三维结构预测模型的微调验证中,融入 structRFM 特征后,三维构象重建的均方根偏差(RMSD)指标取得了突破性改善。此外,在临床极为关切的 RNA 剪接位点精准识别、内部核糖体进入位点(IRES)活性判定以及罕见病相关致病突变筛查等复杂场景中,该模型均展现出了极高的鲁棒性,为小分子靶向 RNA 药物的虚拟筛选提供了坚实的算法护城河。
全量开源的学术胸襟:以算力平权击穿跨国药企技术壁垒
尤为令人肃然起敬的是,在《自然》发表核心成果的同时,中国科学技术大学研究团队毅然选择将价值巨大的 2100 万条配对训练数据、预训练模型的所有分层权重以及底层全部训练推断源码在 GitHub 与 HuggingFace 上向全球无保留开源。这一崇高举措打破了跨国制药巨头与少数硅谷闭源实验室对顶级生命计算资产的围剿垄断,让全球广大的高校学者、中小生物初创团队能够平等地站在最前沿的巨人大脑肩膀上,共同加速人类抗癌、抗病毒新药与基因治疗的研发征途。
📝 站长洞察 (Editor’s Insight)
中国科学技术大学 structRFM 荣登《Nature》并全量无保留开源,是中国科研力量在“AI for Science”核心战略制高点上的一次教科书级胜利。长期以来,全球生物信息学软件与核心生化数据库多被欧美顶尖实验室或跨国药企垄断,国内新药研发在底层工具链上常年面临潜在的卡脖子隐忧;而由蛋白质迈向动态结构更为扑朔迷离的 RNA 领域,更是全球大模型角逐的最前线。科大团队不仅在算法层面突破了双模态预训练的技术天花板,更以顶级科学家的公义胸怀击碎了算力与数据壁垒,将极具商业价值的核心资产作为全球公共品公开发布。这种将硬核技术研发与开源科研共同体深度绑定的范式,正是中国前沿科技在全球舞台赢得真正尊重与引领未来的最佳范例。


