


💡 站外导读:随着 AI 编程智能体(Coding Agents,如 Claude Code、Cursor、Devin 等)深入企业级生产代码库,长程任务中数十轮交互引发的百万级 Token 上下文膨胀与昂贵 API 账单正成为工程团队无法承受之重。今日,微软研究院(Microsoft Research Redmond)联合加州大学伯克利分校(UC Berkeley)正式开源全新成本控制框架 TokenEconomizer。通过在真实软件工程评测集 SWE-Bench 上的严格剖析,研究团队揭示了 30% 重复探索、70% 闲置工具负载与 32% 死循环浪费三大黑洞,并首创不修改底层模型与 Agent 核心逻辑的“黑盒经验控制器”,实测将智能体单任务调用成本大幅降低 18.4% 至 30.9%,且任务解决成功率(Pass@1)不降反升。
一、 编程智能体的隐形开销黑洞:SWE-Bench 60 任务深度 Profile 诊断
在自主 AI 智能体(Autonomous Agents)被广泛寄予厚望接管端到端软件开发的今天,企业开发者普遍遭遇了一个难以言说的财务困境:为智能体指派一个看似简单的 GitHub Issue,往往在几十轮工具调用与反思迭代后,消耗数十万乃至数百万输入输出 Token,导致单次修复任务的 API 费用高达数美元甚至数十美元。
为了探明 Token 消耗究竟浪费在哪里,微软研究院团队首先使用代表性开源工程智能体 Claude Code 对权威评测集 SWE-Bench 中的 60 个真实 Python 开源项目 bug 修复任务进行了严格的执行期画像分析(Profiling)。在按顺序执行各仓库任务的过程中,研究人员发现了三个惊人且高度通用的开销浪费根源:
1. 重复发现已知事实(Rediscovering the same facts):当一个代码仓库累积执行了 5 个以上任务后,智能体在后续探索中竟然有 30% 的工具调用是在机械式地“重复摸索”此前任务中早已验证过的项目结构(如测试用例目录位置、特定包的 import 语法或环境变量)。而在跨仓库的统计中,这种重复行为仅占 7%,证明智能体对特定代码库严重缺乏记忆沉淀能力。
2. 闲置工具的上下文暴击(Paying for unused tools):智能体在每一轮交互中都被迫携带包含 23 个工具完整 JSON Schema 的超长描述,但在整个长程执行中,高达 16 个工具从未被调用过一次。这些静止不动的工具描述白白吃掉了每一轮往返的大量输入 Token。
3. 失败任务的死循环失控(Getting stuck on failures):在所有评测用例中,仅占 17% 的失败任务却烧掉了整个实验总 Token 预算的 32%。当智能体面对语法不兼容或难以逾越的逻辑错误时,往往陷入反复尝试相同命令的死循环,直到上下文撑爆或达到硬性步数限制。
二、 TokenEconomizer 架构解密:三大黑盒经验控制机制全景透视
面对上述痛点,传统的优化策略往往采用粗暴手段,如统一截断历史对话、裁剪系统提示词,或调低大模型的深思考档位(Reasoning Effort)。然而实验证明,这些静态策略虽能节省部分 Token,却会导致智能体在复杂推理场景中任务解决率灾难性跳水。
微软与 UC Berkeley 提出的 TokenEconomizer 采取了一种全新的架构哲学:构建一个轻量级、黑盒式的经验控制器(Black-Box Experience Controller)。它不修改底层大语言模型的权重,也不侵入现有智能体的核心逻辑,而是作为一个常驻侧车(Sidecar),在每个编码会话结束后自动解析交互日志,提炼知识并作用于下一次会话:
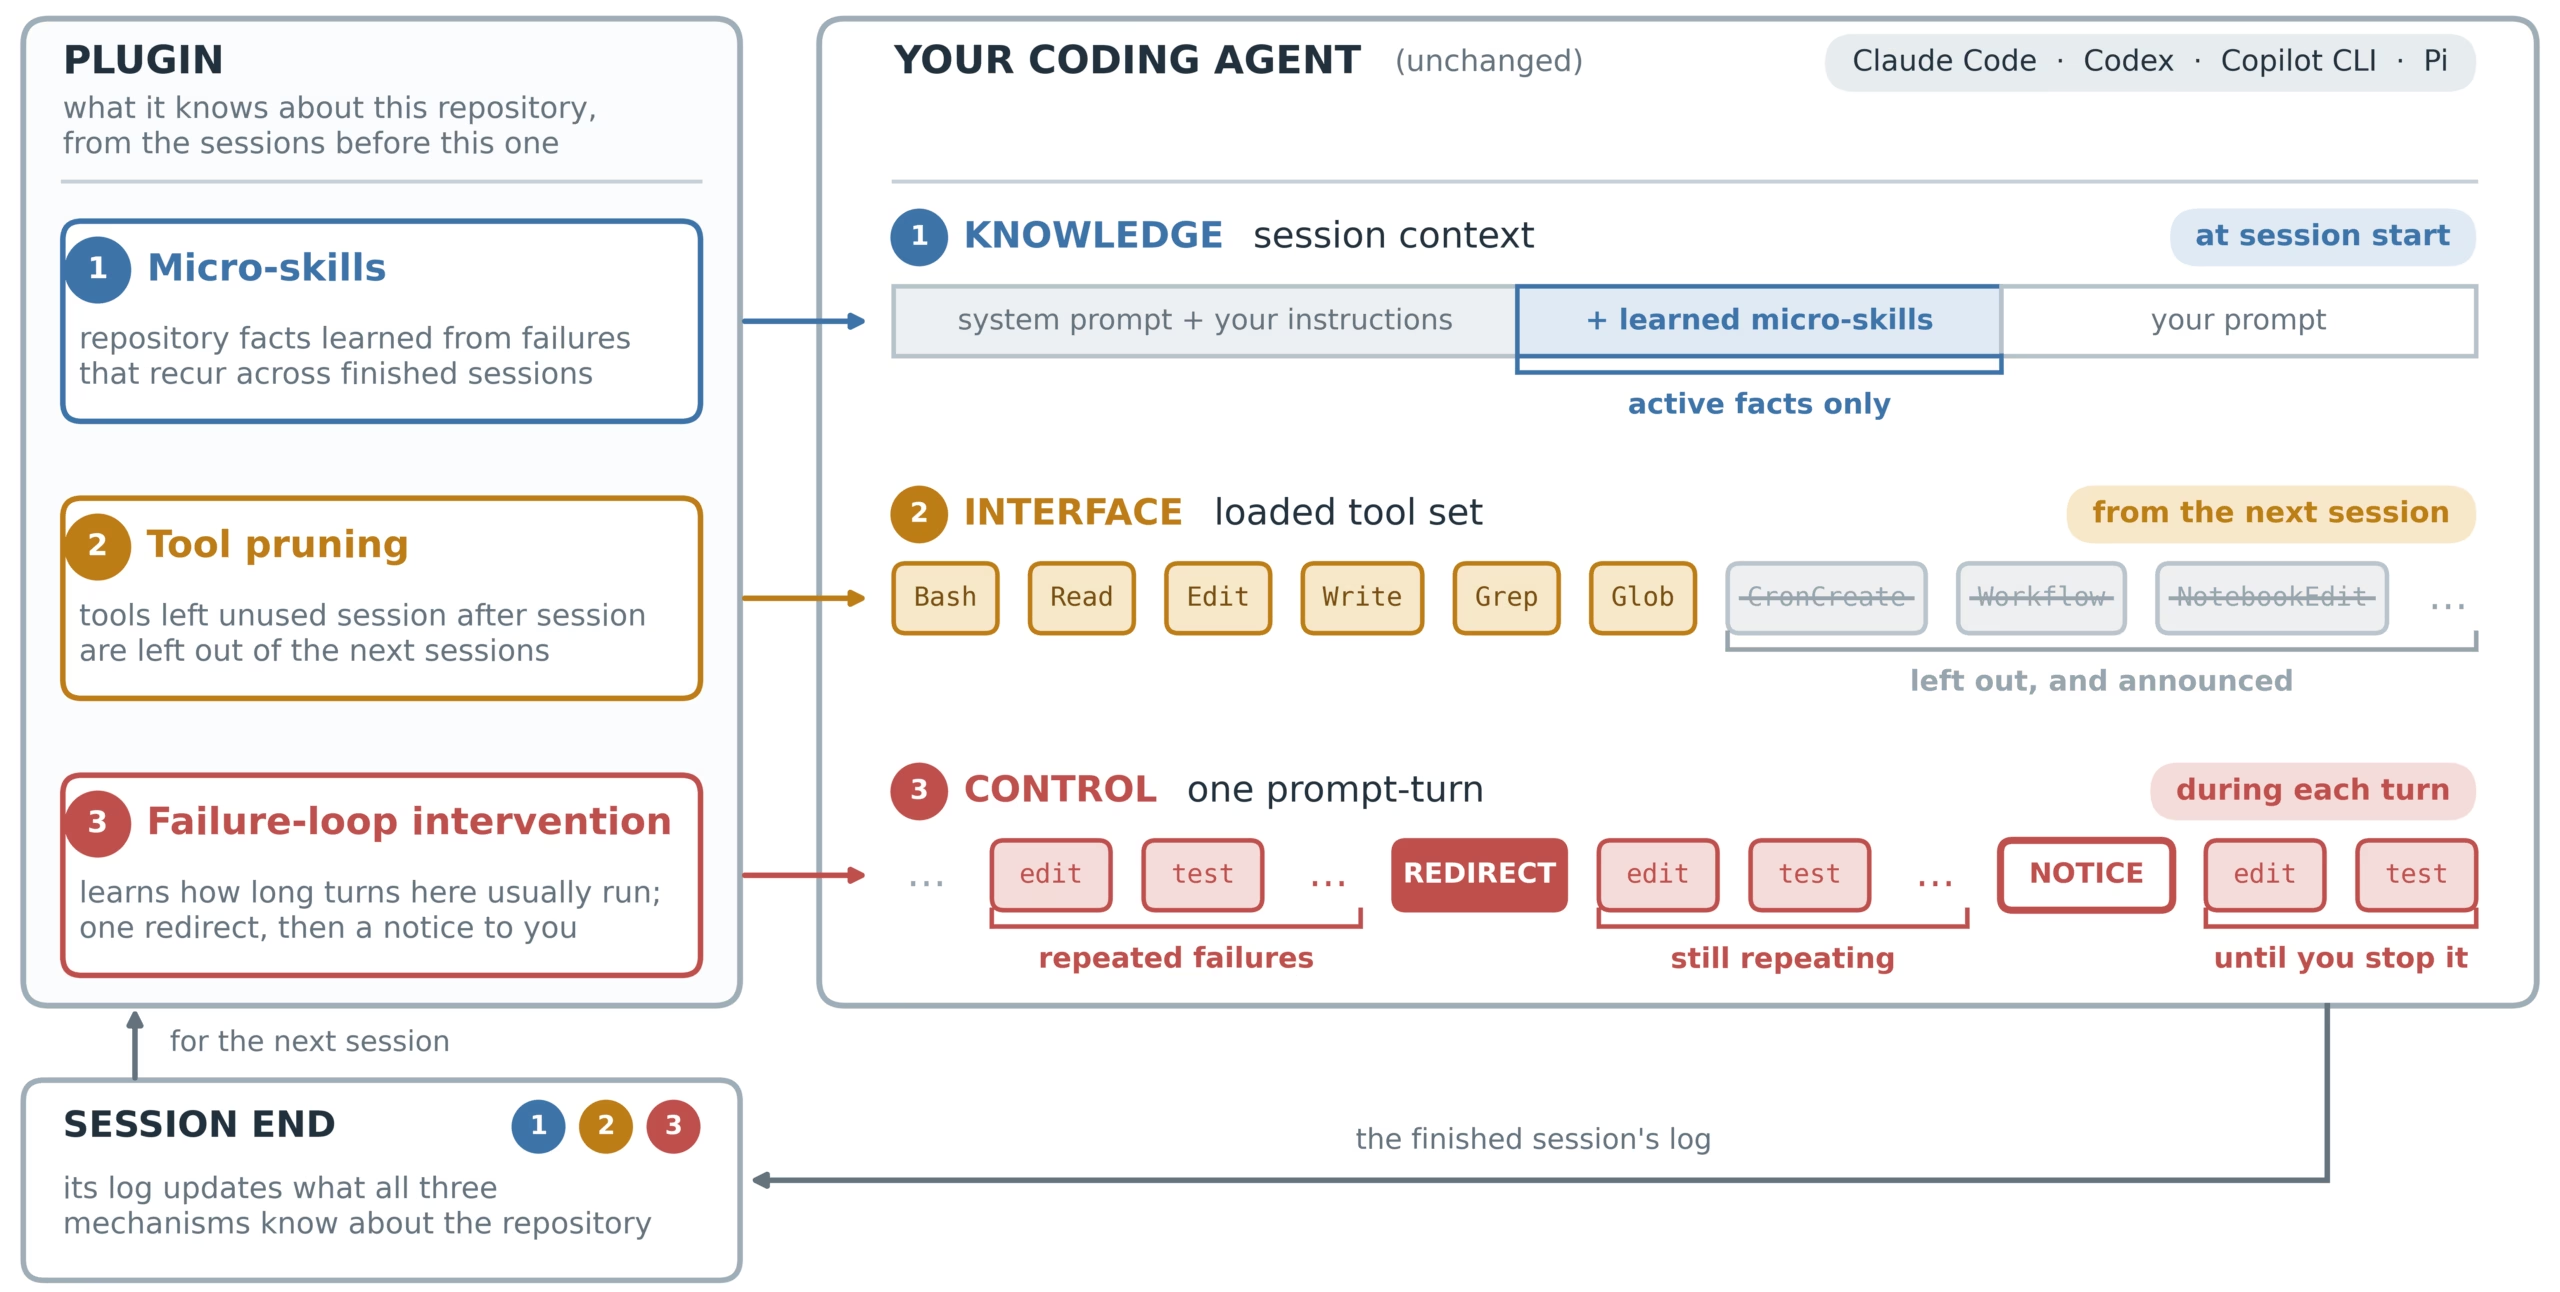
1. 微技能轻量沉淀(Micro-skills via Repository Memory)
TokenEconomizer 能够从历史会话中识别跨任务重现的代码库模式,将其提炼为一句话简明笔记(如“该仓库测试用例需通过 pytest -m unit 运行”)。为防止噪声污染,该机制设置了严格的置信度门槛:只有当某个模式在多个会话中被多次证实,才会被注入到智能体的初始上下文;一旦后续执行产生冲突反例,该笔记将立即被动态退役。
2. 动态工具按需剪枝(Tool Pruning)
根据当前代码仓库的历史调用概率分布,TokenEconomizer 在每次任务启动时智能剔除智能体极不可能使用的低频工具 Schema,显著缩减单轮输入 Token 开销。与此同时,控制器硬性锁定运行命令(run_command)与文件编辑(edit_file)等核心通用工具绝对不被剪裁,并在智能体明确请求时支持动态召回恢复。
3. 失败死循环智能干预(Failure-Loop Intervention)
引入极轻量的裁判模型(Judge Model),实时监控智能体是否在连续数轮中遭遇同类报错。裁判模型能够精准区分“智能体仍在积极推进不同解法”与“陷入原地打转的死循环”。一旦判定卡死,控制器会即刻注入一条简短的外部引导 Note,督促智能体更换解题思路;若引导后依然无效,TokenEconomizer 会及时暂停任务并向人类开发者预警,彻底杜绝无谓的算力燃烧。
三、 严谨工业级实证:跨 277 任务评测成本直降 30.9% 与成功率反常逆势上升
为了验证 TokenEconomizer 在真实工程环境下的鲁棒性,研究团队在涵盖 6 个主流开源仓库的 277 个 SWE-Bench 任务上展开了详尽评测,并覆盖了 5 组不同的 AI 编程智能体与底层基座模型组合。在所有仓库初始阶段,TokenEconomizer 均从零历史经验启动,以模拟开发者接入全新项目的冷启动表现。
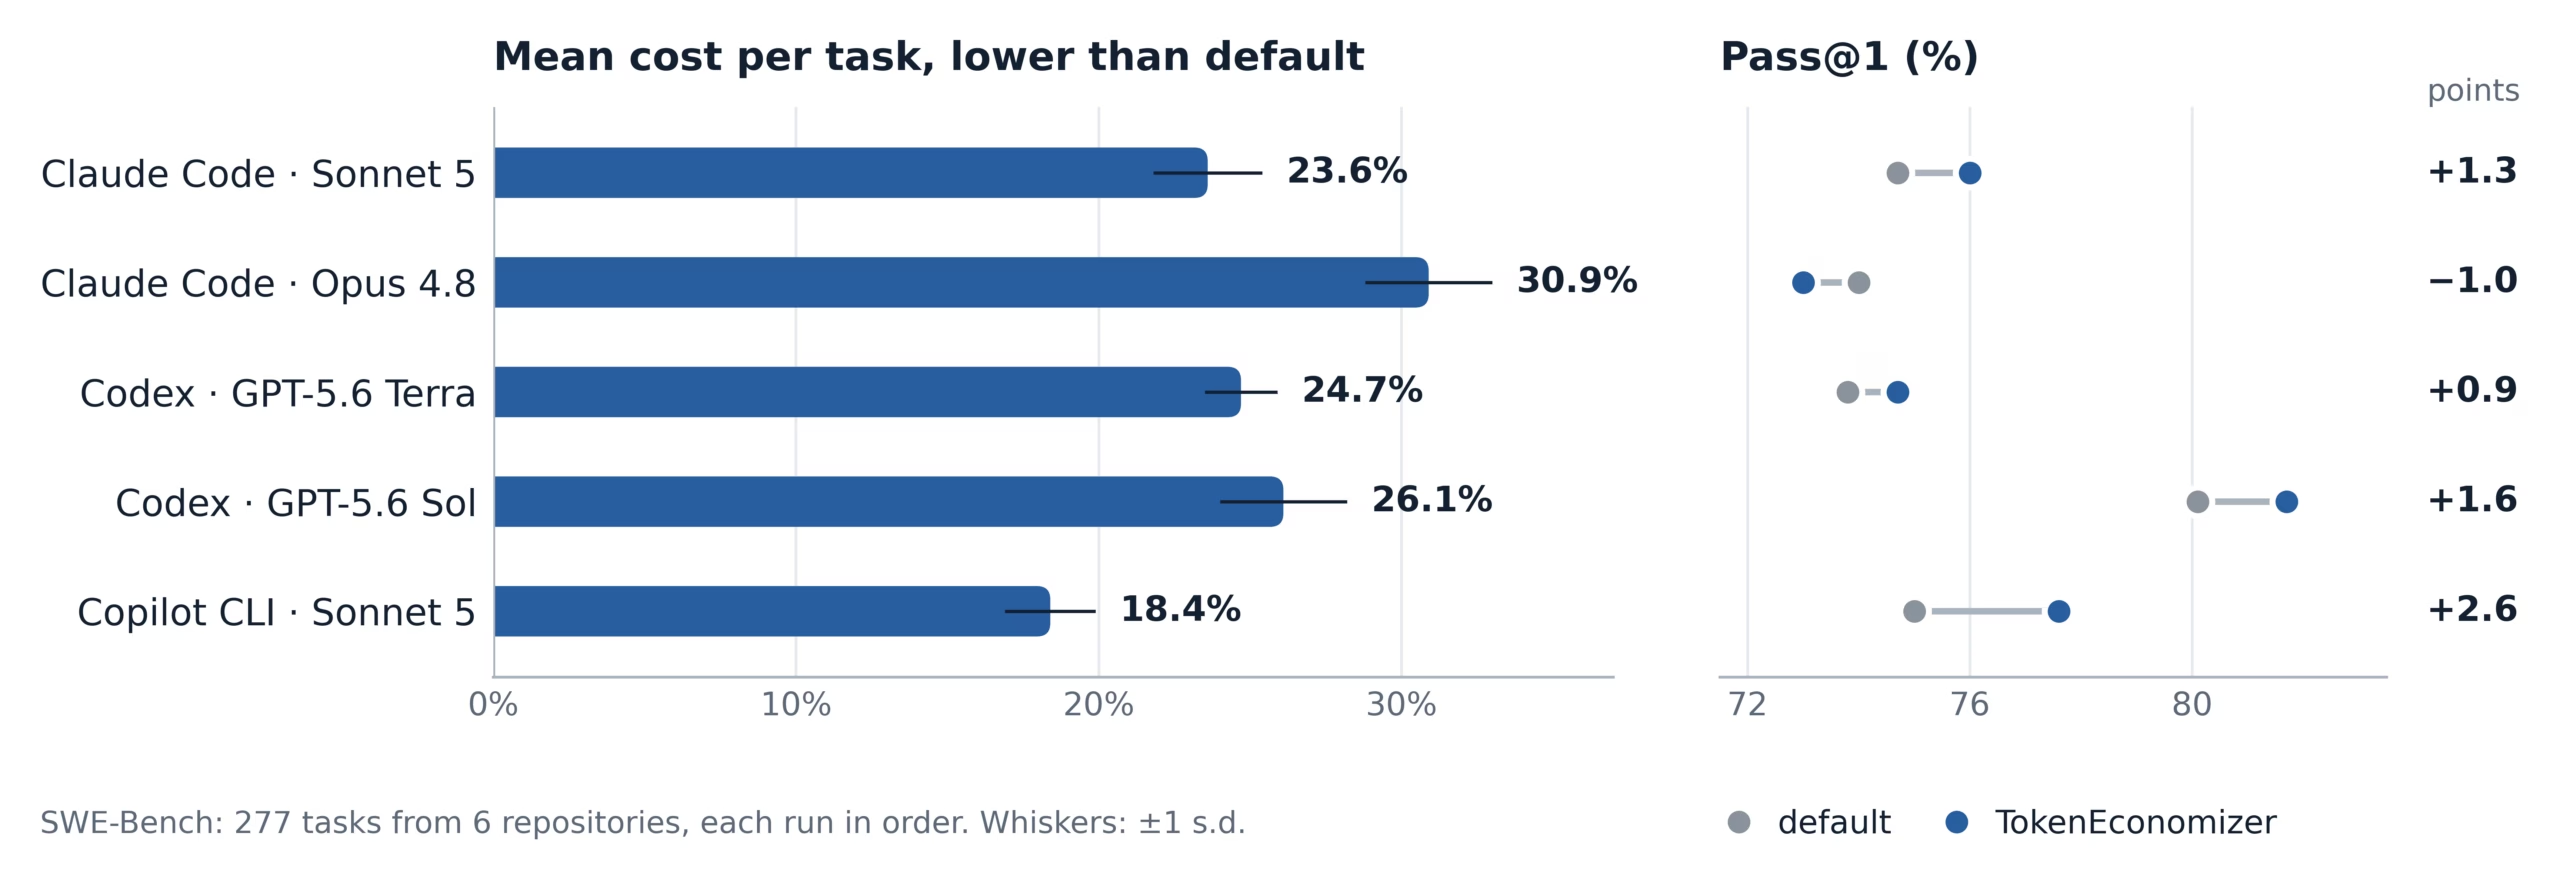
评测数据揭示了极其惊人的降本增效成果:在全部 30 组“仓库-模型”测试对中,TokenEconomizer 将平均任务成本全面降低了 18.4% 至 30.9%(已完全扣除控制器自身极轻量推理调用的开销)。更具突破性的是,在降低三成成本的同时,智能体的首轮通过率(Pass@1)在 4 组模型组合中不仅没有下降,反而实现了显著逆势上扬!
经验累积效应同样得到了完美印证:随着任务在同一仓库中推进,早期任务由于控制器处于探索学习期成本接近基线,但从第 6 个任务开始,累计 Token 消耗在所有仓库中均稳固下探至默认基线之下。此外,这一机制在跨领域迁移中展现了极高通用性:在连续网页开发基准 Web-Bench 上实现了 16.0%–21.2% 的成本缩减;在要求极高的跨仓库安全审计任务中,亦斩获了 6.4%–19.6% 的稳定节约。
四、 AI 编程智能体成本控制范式全景对照
我们将业界主流的几种智能体成本控制手段与微软/UC伯克利的 TokenEconomizer 进行了多维度横向架构对比:
| 控制策略类别 | 核心技术手段 | Token 节约率 | 对 Pass@1 成功率影响 | 实现复杂度与副作用 |
|---|---|---|---|---|
| 暴力调低推理档位 | 强制降低 reasoning_effort / 思考步数 | 约 20% – 35% | ❌ 灾难性暴跌 (平均下降 15%-25%) | 极低成本,但导致复杂代码逻辑严重无法闭环 |
| 滑动窗口强制截断 | 硬性移除 N 轮之前的历史上下文 | 约 15% – 25% | ❌ 逻辑断层 (易丢失初始业务要求) | 易造成智能体失忆,引发重复编译与低级错误 |
| 静态提示词压缩 | 利用小型模型预先蒸馏 Prompt 说明 | 约 8% – 15% | ➖ 基本持平或轻微下滑 | 维护成本高,无法适应仓库特定架构与工具分布 |
| TokenEconomizer (微软/伯克利) | 微技能沉淀 + 动态工具剪枝 + 死循环仲裁 | ✅ 18.4% – 30.9% | ⭐ 逆势提升 (在 4 组模型组合中反超) | 零模型权重修改,全本地经验存储,零专用 Key 依赖 |
目前,微软与 UC 伯克利团队已将 TokenEconomizer 开源为标准化插件,支持作为外挂伴侣与现有主流 AI 编程智能体协同工作。所有经验数据完全持久化在开发者的本地机器上,无需外部 API 密钥即可直接发挥降本威力,为整个智能体工程界树立了极其宝贵的工程范式标杆。
📝 站长洞察 (Editor’s Insight)
微软研究院与 UC 伯克利推出的 TokenEconomizer,直击了当前 Agentic AI 落地中最尖锐的‘ROI(投入产出比)断层’。过去一年,很多企业研发团队在将自主编码智能体引入复杂 Monorepo 或微服务架构时,最直观的体感不是效率翻倍,而是月底飙升的云端 Token 账单——尤其是当智能体陷入测试报错死循环、或者反复调用全量 grep 搜索已经确认的目录结构时,Token 的燃烧速度令人咋舌。传统做法往往是粗暴调低模型思考档位或限制步数,但这必然带来代码质量下滑与任务失败率暴增。TokenEconomizer 最精妙的架构哲学在于‘黑盒治理与经验自学习’:它不需要修改任何大模型权重,也不强绑定特定的商业 Agent 框架,而是在会话外层构筑了一个极轻量的控制平面,把上一次编程中碰壁学到的知识沉淀为下一次的即时先验。这种‘让智能体学会算账与自省’的工程设计,正是自主 Agent 从玩具走向大规模工业化量产所必需的核心基础设施。
TokenEconomizer是什么?
TokenEconomizer是微软研究院与UC伯克利开源的AI编程智能体成本控制框架。它以黑盒经验控制器形式运行,不改底层模型和Agent核心逻辑,通过沉淀仓库经验、按需裁剪工具和干预死循环来降低Token消耗。
它为什么能降低AI编程成本?
文章给出的原因有三点:减少重复摸索已知事实、剔除长期不用的工具Schema、及时阻断失败任务中的死循环。这样能显著压缩每轮上下文长度,并避免无效反复调用,从而降低API账单。
TokenEconomizer会影响任务成功率吗?
不会按文章实测结果那样牺牲效果。研究显示,它在SWE-Bench上将单任务调用成本降低18.4%至30.9%的同时,Pass@1不降反升,说明省Token与保性能可以同时实现。


