

💡 站外导读:通用大模型直接套进编程智能体框架(Harness),常伴随工具盲目试错与Token膨胀。Hugging Face发布完整Harness Adapters强化学习配方,不改基础权重,直接把Qwen3.8-27B放进Pi、OpenCode与Hermes真实容器跑AsyncGRPO训练,SWE-bench Pro最高暴涨25.5个百分点且工具调用大砍53%至73%,更可无冲突融合成通用超级适配器。
一、告别“假循环”仿真:把原版 Agent Harness 原封不动塞进强化学习回路
开源基础模型出厂时面向的是泛化能力,而非某一款特定编程智能体框架(Agent Harness)的上下文格式、工具描述或错误回传机制。因此当开发者将 Qwen3.8-27B 这类 27B 级模型接入终端代理工具时,往往会白白丢掉大量潜能与推理成本——例如在 pi 框架下跑 Terminal-Bench 2.1,基座模型 pass@1 仅有 39%,平均每道题要烧掉 2.9K Tokens;而一旦冻结底座权重、加挂一枚经强化学习定制的 LoRA 适配器,通过率直接跃升至 55%,平均 Token 消耗压低到 1.5K,模型想得更少、调用工具更准、首次出手命中率显著拔高。
更关键的工程突破在于训练架构本身。绝大多数传统 RL 框架(如 verl 的 AgentLoop、SkyRL-Gym、rLLM、slime 或 ART)都要求开发者在 Python 里按训练框架自己的接口重新写一遍简化版智能体循环,这种“仿真重写”不可避免地引入线上部署与线下训练的交互偏差。Hugging Face 此次借鉴 Agent Lightning v1.0(“harnessed agentic RL”)与 SkyRL Harbor 集成的思路,利用 OpenEnv 与 Harbor 构建预装真实软件的 Docker 镜像,直接运行未做任何魔改的 Pi 1.5.2、OpenCode 2.2.7 与 Hermes Agent v0.22.6,并在 Harness 与 vLLM 推理服务之间架设透明代理记录真实发出的 Token 序列,真正实现“部署即训练、轨迹零失真”。
二、从 59,000 个环境中严选 171 道黄金赛题:OpenEnv 四重校验与难度筛选
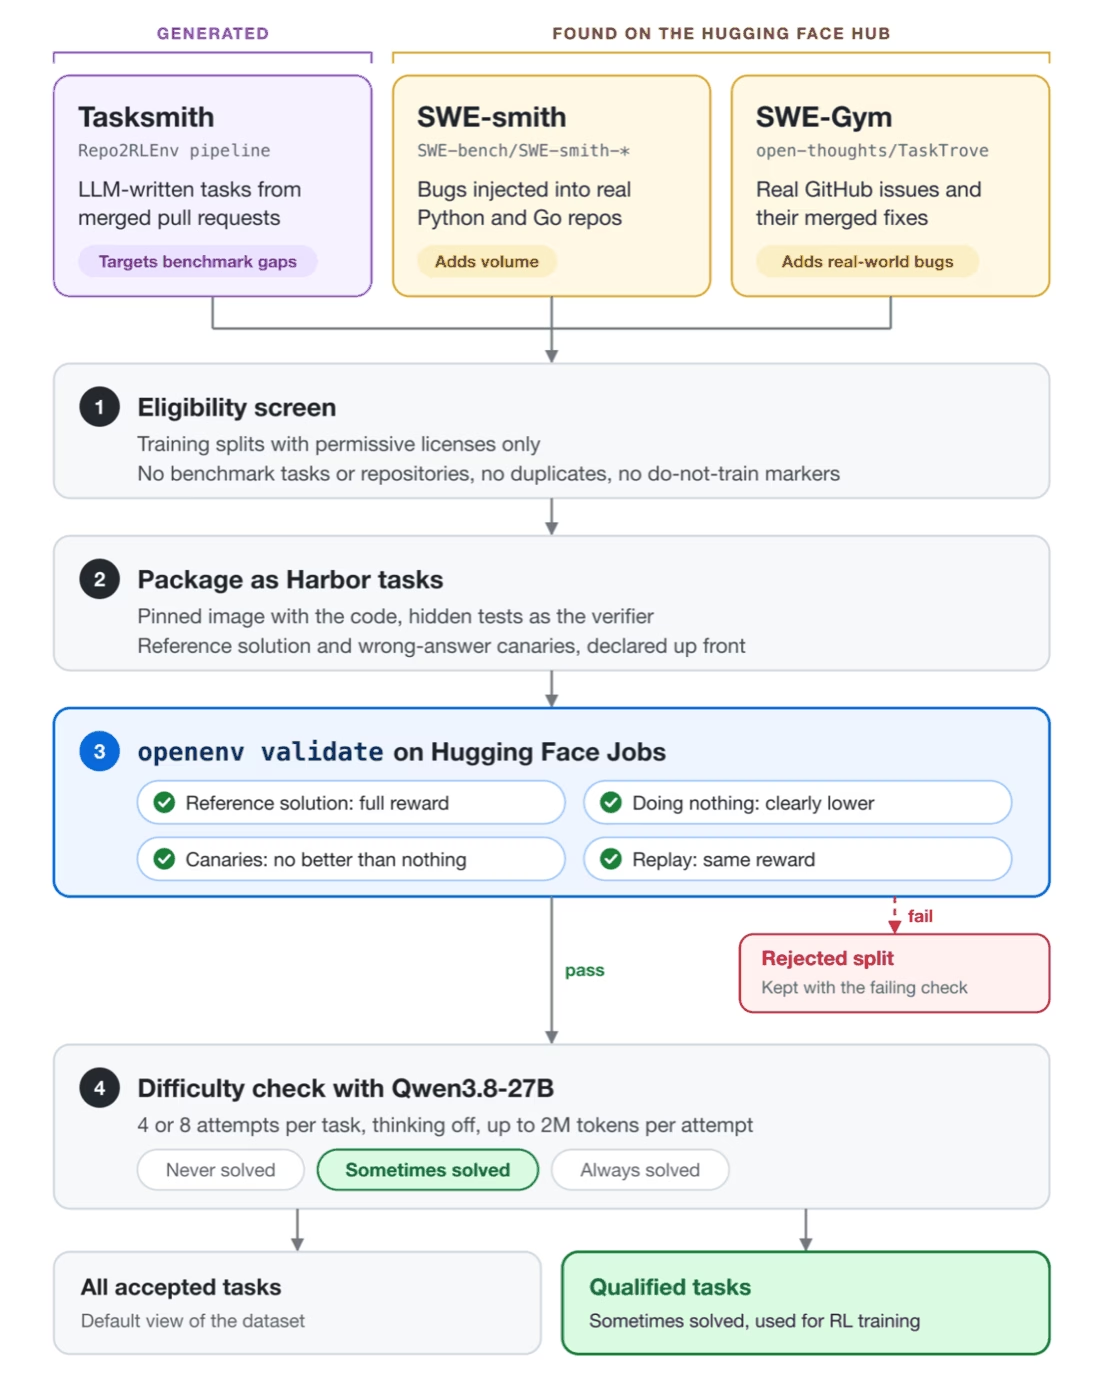
智能体强化学习最致命的隐患不是算力不足,而是验证器(Verifier)作弊或任务难度失衡——放水通过的验证器会教坏模型,而全对或全错的题目在 GRPO(组相对策略优化)中根本产生不了梯度信号。Hugging Face 团队从 Hub 约 59,000 个 Harbor 格式环境中剔除重复项、评估集与禁训数据,精准锁定两大训练仓并自建第三路合成管线:SWE-smith(在真实 Python 与 Go 仓库注入运算符翻转或大模型改写 Bug,贡献 717 题)、SWE-Gym / TaskTrove(直接抽取真实 GitHub Issue 与已合并修复补丁,贡献 130 题),以及借助 Repo2RLEnv 旗下 Tasksmith 靶向补齐 HTTP 流式传输、文件系统与序列化短板(从 30 个合并 PR 成功炼出 24 题,最终合计构成覆盖 35 个仓库、单仓上限 40 题的 871 题数据集 harness-hub/agentic-coding-envs)。
为了剔除脏数据,每道候选题都要先过一轮 openenv validate --sandbox hf-sandbox 四重语义与确定性测试:参考答案必须拿满奖励(semantic.oracle_max)、空操作必须显著低分(semantic.floor_gap)、“金丝雀”已知错误解绝不能反超空操作(semantic.canary_floor),且重放参考解得分必须完全一致(runtime.episode_determinism)。1,127 条初选样本最终有 858 条闯关成功,同时这一关还抓出了 Tasksmith 误放不完整实现以及 Terminal-Bench 2.1 官方 regex-log 验证器放过已知错解的隐藏缺陷。
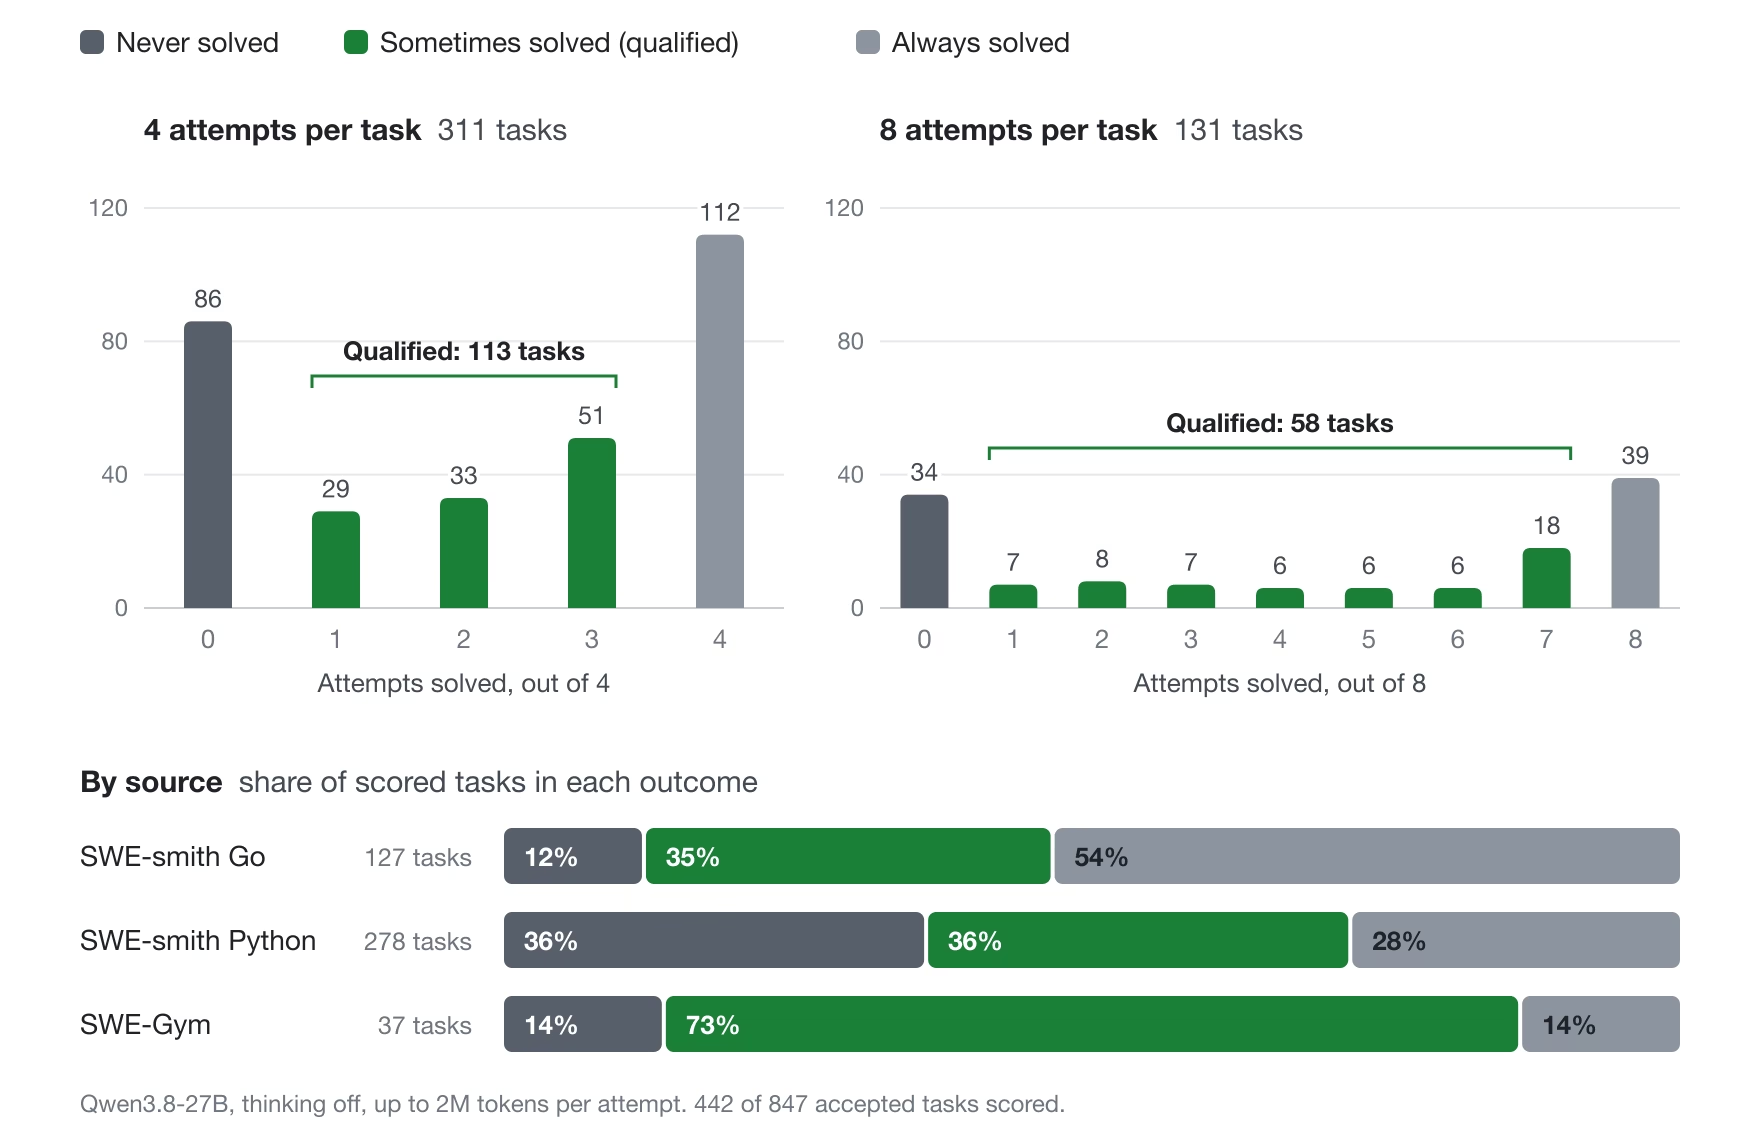
紧接着,团队让基座 Qwen3.8-27B 对候选题各尝试 4 次(分层抽样仓尝试 8 次)做“难度标定”:在 442 道有效题里,151 题每次必对、120 题全军覆没,唯有余下 171 题(占 SWE-Gym 73%,而 Go 题大多过于简单、逾三分之一 Python 注入题则全错)属于“时对时错”的 Qualified 黄金训练集。团队在 8×H200 上用 OpenCode(限 48 次调用)跑 50 步 4 组消融实验证明,剔除坏验证器并仅保留 Qualified 子集,才能在有限步数里打出最陡峭的有效奖赏曲线。
三、2×B200 异步 GRPO、SafeAgents 防越界与近乎正交的“超级适配器”融合
正式训练全面采用 TRL 稳定版 AsyncGRPOTrainer——其核心优势在于无需死等整个批次中最慢的长尾轨迹跑完即可推进下一步梯度更新。团队通过 all-linear 方式在 Qwen3.8-27B 上挂载 LoRA,训练 rollout 期间关闭思考模式以拉高吞吐,奖励函数由“验证器通过与否 + 0.1 工具效率加分”组成。经过 Termgrade 环境上的三档学习率扫描(1e-5 几乎原地踏步 0.52→0.50;1e-4 在 40 步内将轨迹轮数从 18 压塌至 6 且熵失控;5e-5 长程易震荡),最终稳定锚定 2e-5。
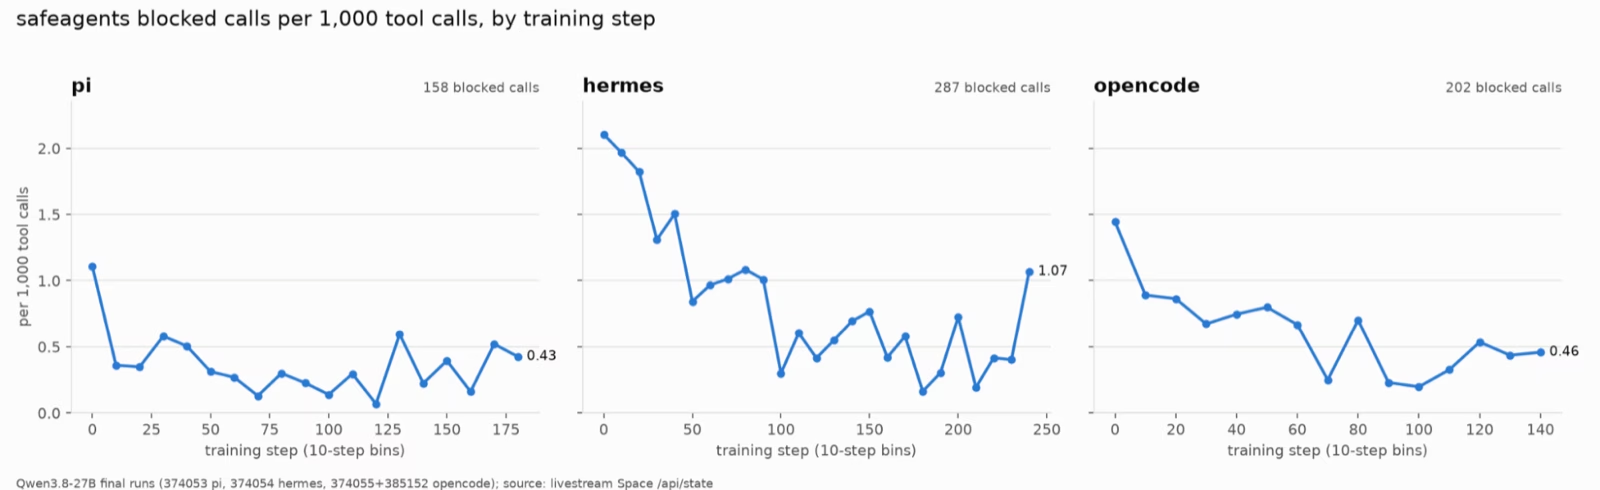
硬件编排方面,每个适配器独占两张 NVIDIA B200 GPU(1 卡专职 vLLM 推理服务、1 卡负责参数更新),打满 --token-budget 并将 750 条环境任务与 300 条 Termgrade 任务按仓库家族交错洗牌,累计推进 598 步、消化 78,114 个样本与 1.67 亿训练 Token。训练过程中还全程挂载了开源防护插件 harness-hub/qwen-safeagents-plugin,在累计核验的 130 万次工具调用中精准拦截了 647 次疑似越权或触碰测试路径的违规操作,且千次调用被拦率随训练步数稳步下滑。
当 Pi(160 步)、Hermes(160 步)与 OpenCode(150 步)三枚专精 LoRA 训成后,研究团队逐层测量任意两者的权重增量余弦相似度,结果惊人地低至 0.01~0.02——说明不同框架把模型推向了几乎完全正交的参数空间。团队遂用 PEFT combination_type="cat" 沿秩维度拼出 Rank 96(3×32)的 super-adapter,并在 89 道 Terminal-Bench 2.1 上比对了三档缩放权重:直接相加(权重 1)虽让工具调用降至 13.4 次但 Pi 分数跌回 40.2% 底座水平;均值(权重 1/3)过度稀释收益;而 1/2 缩放系数取得了三框架均分 52.5% 且调用从 49.2 次压至 25.9 次的最佳平衡。
| 智能体框架 (Harness) | 评测基准 (Benchmark) | Qwen3.8-27B 底座 (非思考 / 思考) | 专精适配器 (非思考) | Super-Adapter (非思考 / 思考及调用降幅) |
|---|---|---|---|---|
| Pi 1.5.2 | SWE-bench Pro (Hard 51) | 40.0% / 74.0% | 64.0% (-60% 调用) | 46.0% (-73%) / 74.0% (-48%) |
| Hermes v0.22.6 | SWE-bench Pro (Hard 51) | 29.4% / 45.1% | 43.1% (-56% 调用) | 47.1% (-60%) / 60.8% (-36%) |
| OpenCode 2.2.7 | SWE-bench Pro (Hard 51) | 35.3% / 47.1% | 51.0% (-72% 调用) | 45.1% (-63%) / 66.7% (-31%) |
| Pi 1.5.2 | Terminal-Bench 2.1 (89 题) | 40.0% / 52.9% | 56.5% (-56% 调用) | 48.2% (-56%) / 57.6% (-25%) |
| Hermes v0.22.6 | Terminal-Bench 2.1 (89 题) | 44.7% / 58.8% | 58.8% (-70% 调用) | 55.3% (-53%) / 63.5% (-19%) |
| OpenCode 2.2.7 | Terminal-Bench 2.1 (89 题) | 47.6% / 54.9% | 52.4% (-53% 调用) | 52.4% (-68%) / 58.5% (-22%) |
四、横跨 Thinking 模式的意外爆发、跨框架迁移实测与“推理泄露”反思
在 131,072 Token 总上限、温度 0.8 且零人工调参的公平赛场下(需注意 Pi 默认不保留前序推理轮次,而 OpenCode 与 Hermes 会保留,故只能同框架内纵比不可跨框架横比),单框架专精适配器统治了“关闭思考模式”赛道:Pi 在 SWE-bench Pro 硬核子集由 39.2%(40.0% 成对计)跃升至 64.7%(+25.5 个百分点,p=0.002),Terminal-Bench 2.1 全集亦分别带来 Pi +16.3、Hermes +14.1 与 OpenCode 留出子集 +13.6 的显著跃迁;非思考下的工具调用量全面骤降 53%–72%,Token 总量亦减少 44%–60%。
真正的惊喜发生在开启默认 xhigh 思考模式之后:尽管融合版 super-adapter 在训练全过程中一秒钟都没开过思考模式,它在 6 组(框架×基准)对比中对开启思考的底座拿下 5 胜 1 平(均分从 55.5% 拔高到 63.5%,p=0.004),其中 Hermes 暴涨 +16 点、OpenCode 暴涨 +20 点,工具调用仍再省 31%–48%。此外,把 Pi 适配器直接搬到 OpenCode(44.8%→54.0%)与 Hermes(46.3%→56.1%)上依然能留住绝大部分增益并削减约 45% 调用;而在 300 题纯业务流自动化基准 AutomationBench 上,除了 Hermes 略掉 5.3 点外,Pi 与 OpenCode 反而小幅领先底座(27.0%/25.3% vs 23.0%),说明领域内强化学习并未摧毁通用分布外能力。
团队在文章末尾也坦诚披露了一个关键的“事后发现”:复盘评测轨迹时,他们观察到即便在禁用思考的模板下,经过 RL 的模型在调用工具前仍倾向于自发输出一两句诸如 ..wait? ..let me see 的简短内省文本——相当于一种隐性的 “Reasoning Leakage(推理泄露)”,试图绕开非思考约束借取思维链收益。不过由于所有对照均被严格锁死在相同的 Token 预算上限内,且它确实在同条件下远胜底座并在成本上碾压纯思考模式(社区更验证了该适配器甚至能跨版本提升 Swift-1.5 等 Qwen3.8 衍生体),这一现象反而为下一代混合思考/非思考联合 RL 训练指明了极富价值的研究方向。
📝 站长洞察 (Editor’s Insight)
这篇来自 Hugging Face 团队的工程长文,打破了“大模型能力全靠预训练和提示词微调”的迷思,把 Agent 工程推进到“模型与框架联合进化”新阶段。过去同一款 27B 开源模型套进不同 Coding CLI 表现往往大相径庭,动辄空转几十轮烧干预算;HF 给出的解法极其务实:别在训练框架里手写山寨 Agent 循环,直接把原汁原味的容器架进 OpenEnv,对着真轨迹用 AsyncGRPO 跑强化学习。更惊艳的是三款框架权重更新仅 0.01 至 0.02 的近正交特性——企业完全可以为内部工具链分别训出轻量 LoRA 再融合成通用超级适配器,用单卡跑出比肩闭源旗舰的性价比。
Harness Adapters解决了什么问题?
它解决的是通用大模型接入编程智能体框架时的工具盲试、Token膨胀和训练仿真失真问题。做法是不改底座权重,直接在真实Harness容器里做强化学习,让训练轨迹与线上部署一致。
为什么要先筛选Qualified黄金题?
因为GRPO需要稳定且有区分度的奖励信号。若验证器放水,模型会学坏;若题目全对或全错,又难以产生有效梯度。筛出“时对时错”的题,才能更高效地提升策略。
这套方法能带来哪些实测收益?
文中实测显示,Qwen3.8-27B接入后,SWE-bench Pro最高提升25.5个百分点,工具调用减少53%至73%,Token消耗也明显下降,且训练出的适配器还能融合成通用超级适配器。
AsyncGRPO为何比传统RL更适合容器训练?
AsyncGRPO把环境交互、奖励计算和参数更新解耦,能更充分利用并行容器与异步采样,减少等待空转。对工具调用类任务尤其友好,既提升吞吐,也更稳定地收集长链路轨迹。
可融合适配器上线前要重点验证什么?
重点看与底座的融合后是否出现能力回退、工具格式漂移和长上下文劣化。上线前应做多任务回归、失败案例回放和成本评估,确认收益来自真实泛化而非单一基准过拟合。


