

💡 站外导读:每当新一代前沿模型发布,刷屏的往往是一串刷新纪录的公开榜单分数,但这些数字在真实生产环境里究竟有几分可信?资深工程师 Eugene Yan 对 Terminal Bench、DeepSWE、Harvey LAB、OSWorld 2.0 等 12 个主流 AI 智能体评测进行了全流程工程审计,发现其中多达 8 个榜单存在评分器错杀合法方案或放过严重幻觉的机制漏洞。本文拆解 12 大基准的设计机理、失效样本与重构方向。
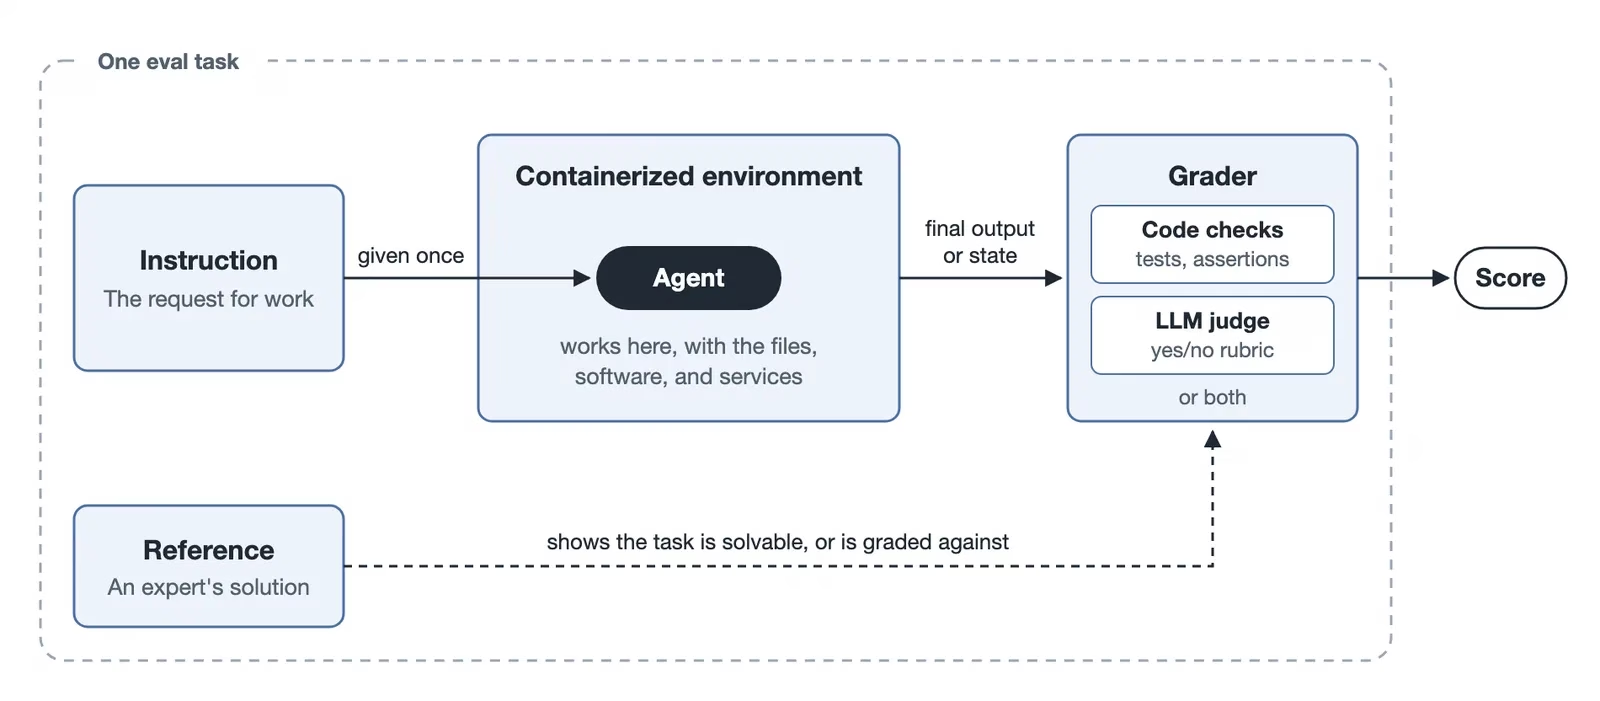
一、 现代 Agent Benchmark 怎么建:四要素解剖与四大设计原则
随着模型迭代周期缩短,公开评测集早已不再是早年的静态选择题,而是演变成像软件工程一样持续发版、接受 Issue 修复与淘汰饱和题目的复杂系统。例如 Agents’ Last Exam (ALE) v1.1 退役了 30 道旧题并修订了 57 道题目,Harvey LAB 公开集自 2026 年 5 月上线以来也从约 1,250 题扩充至 2,010 题。
Eugene Yan 指出,几乎所有主流智能体评测任务都由指令(Instruction)、工作区环境(Environment)、评分器(Grader)和可选的专家参考解(Reference)四部分构成,但在底层评分工程上反复呈现出四条共性原则:
- 确定性代码校验优先于 LLM 裁判:为防止裁判模型升级导致榜单排位无端漂移,DeepSWE 与 AutomationBench 完全弃用 LLM Judge;即便是法律备忘录或临床问诊等主观任务,也会把裁判职责压缩为逐条二元 Yes/No 核查。
- 只验最终结果,不锁中间路径:Terminal Bench、AutomationBench 与 OSWorld 2.0 等均在运行结束后仅检查容器或业务系统终态,允许智能体采用任意合法命令或工具链求解。
- 全通过(All-Pass)计分主宰高风险赛道:如同 Harvey LAB 所言“发现 10 个风险里的 8 个不是 80% 有用,而是未完成”,DeepSWE、TBench 等均采用全票通过制;而 FrontierSWE、HealthBench Pro 则采用部分得分(Partial Credit)。
- 面向难度挖矿延缓饱和:AutomationBench 刻意注入无关干扰数据与冲突业务规则,HealthBench Pro 将高难度样本比例抽样放大约 3.5 倍,TBench 则在旧题饱和后直接剔除。
二、 双向失真真相:8/12 主流评测评分器在如何“错判”?
审计这 12 个评测集时,模型本身固然暴露出两大典型短板——跳过终态校验提前交卷(OSWorld 2.0 中模型用于纠错和恢复的预算不足 7%;AutomationBench 在分析的失败案例中有 72%–91% 虚假宣告成功)以及漏掉显式约束(GDPval 中最普遍的失败就是指令遵循缺失)。但更致命的问题藏在评分器(Grader)本身:在被研究的 12 个公开基准中,有 8 个 被外部审计或 Issue 实锤存在错判。
1. 假阴性(False Negatives):把正确解法打成零分
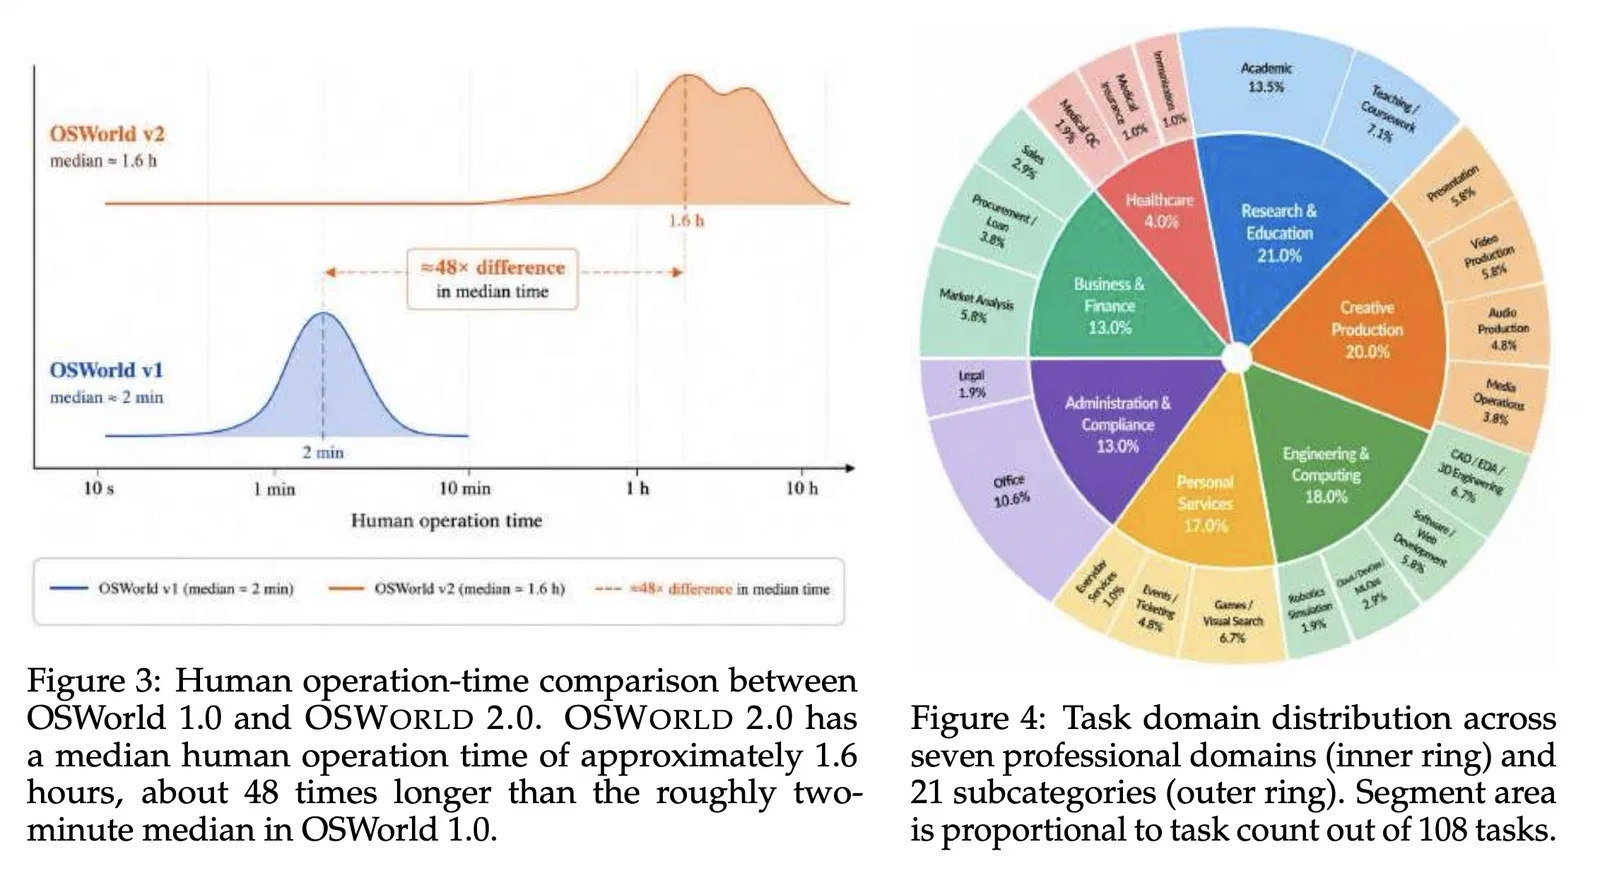
最常见的失真源于评分器验证了提示词里根本没写的隐含要求,或隐藏测试集与合理实现冲突。Epoch AI 与 Preference Model 对 Terminal Bench 4.0 的复核发现,66 题中有 30 题存在计分缺陷,65 题中有 41 题暗含未说明要求;一旦将这些隐含约束写明并封堵作弊路径,某模型的得分直接从 63% 跳升至 89%。在 DeepSWE v1.1 中,隐藏测试文件与智能体自己编写的测试文件发生编译冲突,导致至少 20% 题目(Epoch AI 确认为 113 题中的 18 题,并给出“Flawed”评级)出现“越认真自测越拿不到分”的荒诞现象。OSWorld 2.0 也被外部复审在 108 题中指出 23 题误杀合法输出(例如网页展示长名称而评分器硬匹配短名称),且 31%–43% 的轨迹存在环境状态与评测记录不一致。
2. 假阳性(False Positives):让幻觉与关键词投机蒙混过关
由于大多数断言和细则只检查“某个要点是否出现”,却不核对上下文是否真实自洽,大量严重幻觉顺利拿到满分。Artificial Analysis 抽查 Harvey LAB 上满足全部细则的交付物时,竟在超过 60% 的“满分答卷”中发现了关键事实幻觉(如写错当事方、金额或日期)。AutomationBench 公开集约 9,600 条断言中更有 55% 只是简单检测邮件或记录里是否包含某段子串——有 94 题甚至只检查文本中是否出现个位或两位数字(如“4”),哪怕消息里其他日期或编号碰巧带了数字也能躺赢。
| 评测基准 (领域) | 任务规模与核心机制 | 首发头部水平 | 核心评分器缺陷与审计实证 |
|---|---|---|---|
| Terminal Bench 4.1 (命令行与工程) |
66 题 / Harbor 容器 / All-Pass |
v2.0 首发最高 63% |
65 题中 41 题考核未明说要求;显式补齐后同一模型由 63% 跳升至 89% |
| DeepSWE v1.1 (长程软件工程) |
113 题 / mini-swe-agent / 无 LLM 裁判 |
v1 首发最高 81% |
隐藏测试与智能体自建测试冲突,Epoch AI 核实 18/113 题误杀并评为 Flawed |
| FrontierSWE v2 (20h 科研与优化) |
34 题 / Proximus / 局部得分 0–1 |
v2 首发最高 56% |
自带自检工具替代问题定义判断;满分封顶设计掩盖超额优化差距 |
| AutomationBench (跨应用 API 编排) |
600 公开 + 600+ 私有 / 47 模拟应用 | 私有集首发最高 9.9% |
115 题数值格式误杀(150,000 vs 150000.0);55% 断言仅做脆弱子串匹配 |
| Harvey LAB v1.3 (长程法律尽调) |
2,010 公开 + 120 私有 / 11.4 万条细则 | 私有集首发最高 7.1% |
裁判不可见原始案卷,Artificial Analysis 查出 >60%“通过交付物”含实质幻觉 |
| OSWorld 2.0 (长程桌面操作) |
108 题 / Ubuntu VM / 500 步预算 | 首发全过 20.6% |
23/108 题被指出误杀有效解;31%–43% 轨迹存在环境复位或会话陈旧偏差 |
三、 12 大公开基准横向深潜:从科研计算、知识工作到桌面操控
Eugene Yan 将调研的 12 个基准按三大场景拆解了其任务构造、得分口径与隐藏陷阱,几乎构成一份 2026 年 AI Agent 评测全景地图:
- 编程与科学计算(4 项):除了
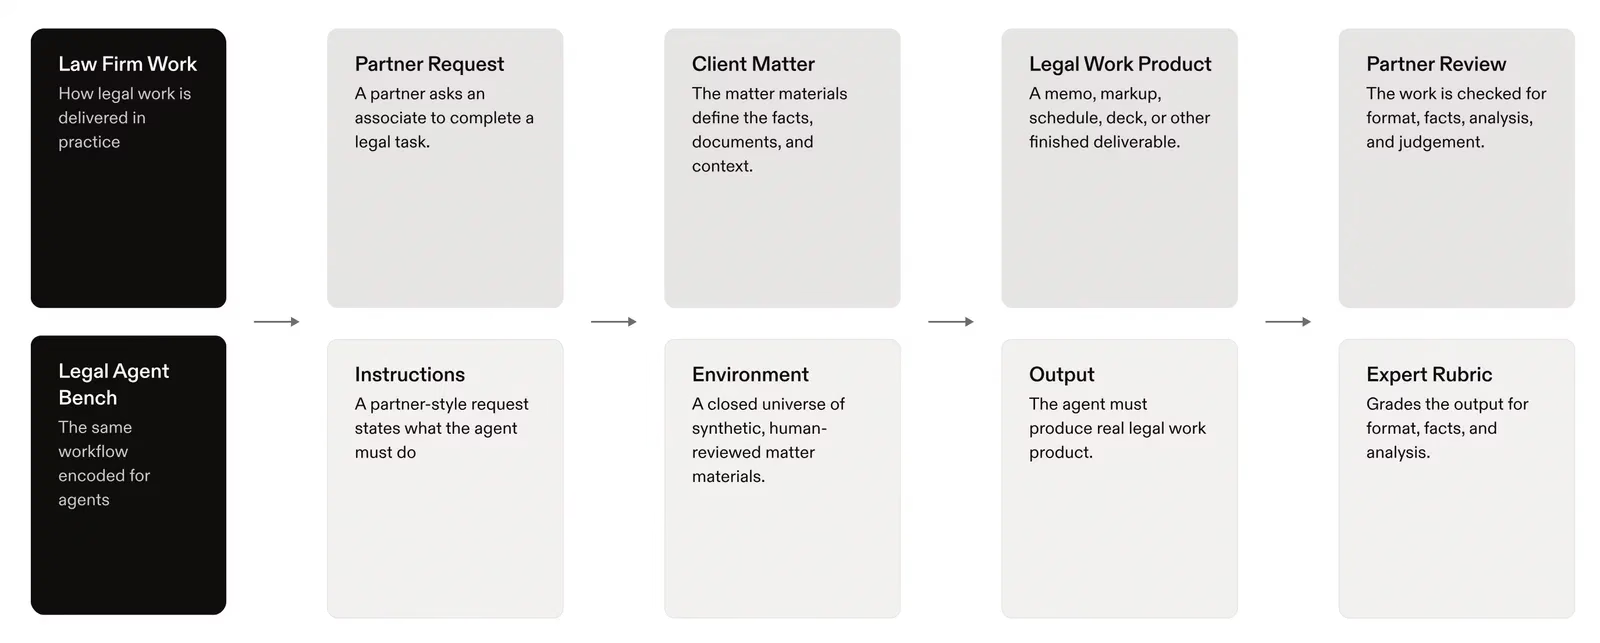
Terminal Bench与DeepSWE,FrontierSWE v2 为每题提供最高 20 小时预算与 GPU 容器,用确定性的加权指令数代替不稳定挂钟时间衡量性能优化,但最便宜达到 30% 以上得分的模型单次试跑成本也要 97 美元;Terminal Bench Science v0.1 精选 70 个专家中位耗时 12 小时的科研流任务(首发最高 30%),上线后却收到 106 个修复 Issue 涉及 55/70 题(其中 79 个直指校验器或指令 Bug,如行序不同即判错)。 - 知识工作与专业领域(6 项):OpenAI 主导的 GDPval 覆盖 44 个职业 1,320 项任务,采用人类盲审胜率(人类专家间一致率 71%,裁判模型一致率 66%),但公开细则约一半在考格式与字段遵从;Agents’ Last Exam (ALE) 含 1,490 题(93% 确定性比对),却在 122 道 v1.1 公开题中用了 83 次“exact/exactly”强锁文件名,且约半数偏学术复现;Finance Agent v2.1(926 题投行研报,三 LLM 陪审团+一票否决 Dealbreaker,首发部分分 68%)也存在未明说的同业均值要求;HealthBench Pro(525 题临床对话)平均每题仅约 2 条评分标准(47% 只有 1 条正向标准),且对所有任务统一按 2,000 字符基线做长度扣分,忽视了临床记录本身的合理长度跨度(600–3,800 字符)。
- 网页浏览与电脑操控(2 项):BrowseComp(1,266 道倒推式多跳检索题)在发布时让 Deep Research 拿到 51.5% 远超人类 29%,但人工复核发现 14%(50/367 题)参考答案存在争议;OSWorld 2.0 引入了支持中途插话改需求、允许主动向模拟用户追问的设计,却依然受困于高达 31%–43% 的环境状态同步故障。
四、 我们到底哪里算错了账?推动 Agent 评测进化的五条工程准则
面向即将进入大规模业务落地的工程团队,Eugene Yan 在报告中给出了五条直击痛点的范式纠偏建议:
- 1. 用
pass^k可靠性替代“平均通过率”:两个表面均分都是 70% 的智能体,A 能稳定搞定其中 70% 的任务,B 则是每道题都只有 70% 概率做对。在连续 5 次试跑的pass^5口径下,前者依然是 70%,后者会暴跌至 17%。生产环境宁愿为稳定交付支付 2 倍成本,也不愿用 1 倍价格买来需要人工逐一擦屁股的抽卡模型。 - 2. 稀缺资源是人类注意力,而不是单次 Token 账单:便宜的模型往往通过提前放弃(ALE 中 17% 失败是过早交卷;FrontierSWE 中某模型 170 次测试有 169 次在 8 小时内草草提交)或虚假报喜来拉低平均美元成本。GDPval 实测显示,GPT-4o 单次成本虽只有 GPT-5 的十分之一,但算上专家审核与返工耗时后,反倒比专家纯手工更慢。
- 3. 警惕“可验证性偏置”吞噬判断力测试:为了实现代码级自动校验,许多基准把开放问题改成照抄参考设计(如复刻指定游戏),或直接喂给智能体自检打分工具。这测出的只是“按图施工的执行力”,而非工程中最值钱的“定义问题边界与取舍判断力”。
- 4. 从单轮指令走向多轮纠偏:真实用户永远是在草稿与对话中逐步补全并修改需求。Laban 等人的研究证实,模型在模拟多轮对话中的表现比单轮平均暴跌 39%。
- 5. 把算力预算分给评分器审计,且务必在自家 Harness 里实测:对“前沿模型集体失败”的题目优先排查假阴性,引入空跑/作弊智能体与轨迹审查防范假阳性。同时切记,榜单测的永远是“模型 + Harness”的耦合体——在 Terminal Bench 2.0 上,同一模型在中立
Terminus 2框架跑出 57.8%,换用自家厂商框架却只有 52.1%(另一模型为 32.6% vs 19.6%)。因此公开榜单只配用来缩小选型范围,最终拍板必须在你自己的生产 Harness 中完成。
📝 站长洞察 (Editor’s Insight)
Eugene Yan 这篇万字审计给所有盲信榜单 SOTA 的 AI 工程团队敲响了警钟。我们平时看大模型发布会,习惯盯着又刷高了几个点的总分,却极少追问评分器是否藏着未明说的字段格式陷阱、环境复位是否丢了状态、以及这个分数究竟来自模型本身还是定制 Harness 的提示词工程。尤其是 pass^k 与“人类复核注意力成本”两个视角,直接点破了生产级 Agent 落地的核心矛盾:企业从不缺在 Demo 里偶尔惊艳一次的模型,真正稀缺的是敢于无人值守连续跑通 5 次不翻车的稳定性,以及失败时绝不撒谎说“已完成”的诚实度。建议团队在选型前,先用自家业务真实工具链搭一套 30 题以内的黄金回归集。
AI智能体评测为什么会误判?
核心原因是评分器把提示词里没写明的隐含要求当成硬条件,或只做关键词/子串匹配,不核对上下文与终态一致性,导致合法解法被零分、幻觉答案却能过关。
Terminal Bench 和 DeepSWE 的问题是什么?
Terminal Bench 被指出存在大量未明说要求,补齐约束后分数会显著变化;DeepSWE 则出现隐藏测试与智能体自测冲突,导致越认真验证越可能拿不到分。
什么是 All-Pass 计分,适合哪些任务?
All-Pass 是“全通过才算成功”的计分方式,常用于高风险或强一致性任务,能避免部分正确掩盖关键错误。文中提到 DeepSWE、TBench 采用此类机制,而 FrontierSWE、HealthBench Pro 则使用部分得分。
pass^k 该怎么设才不虚高?
先按任务难度分层设定 k,再看边际提升是否收敛;若多次采样仍大幅波动,说明模型靠运气过关。最好结合失败样本回放,避免把偶然通过误判为稳定能力。
All-Pass 和终态校验怎么一起用?
All-Pass 适合筛掉明显不稳定的方案,终态校验负责确认最终输出是否真正满足约束。实战里应先做批量粗筛,再对高分样本做终态审计,防止评分器放过幻觉或误杀正确答案。


