

💡 站外导读:语音识别一定要靠数十亿参数大模型才能扛住真实电话噪声与多语种混合?Reson8在Hugging Face依Apache 2.0协议开源0.5B轻量语音模型Rumble-2-Flash,给出新答案。该模型复用Qwen3-ASR架构实现Transformers与vLLM的Day-0无缝运行,并借助On-policy在线策略蒸馏与GOLD跨分词器对齐,以5亿参数跑出6.96%多语言WER与超7,000 RTFx吞吐,反超15倍体量竞品。
一、0.5B 参数原生适配 Qwen3-ASR:Apache 2.0 开源与 Day-0 零改造部署实战
对于正在搭建高并发语音交互 Agent、会议纪要管线或呼叫中心质检系统的工程团队而言,选型开源自动语音识别(ASR)模型往往面临两难:动辄 7B 至 30B 的大模型显存吃紧且并发昂贵,而传统小模型在跨语种与嘈杂通话下错误率飙升;更麻烦的是,许多科研向新架构需要维护魔改分支或开启高风险的 trust_remote_code 才能跑通推理。
Reson8 最新在 Hugging Face Hub 开源的 Reson8/Rumble-2-Flash 直击这一工程痛点。它仅有 0.5B(5 亿)参数,采用商业友好的 Apache 2.0 开源协议并覆盖 40 多种语言。在底层架构上,Reson8 没有另起炉灶定义私有结构,而是直接采用 Qwen3-ASR 架构标准——这意味着只要你的生产栈已经在跑标准的 transformers 或 vLLM,就能在 Day-0 零适配、无需 Fork 运行时、无需开启 trust_remote_code 的前提下直接拉起服务(同时官方也提供托管 API 调用)。
从官方给出的 Quickstart 示例可以看出其接口极为干净:通过 AutoProcessor 与 AutoModelForMultimodalLM 加载权重后,调用 processor.apply_transcription_request() 即可直接传入本地音频路径、远程 URL、NumPy 数组或上述对象的批量列表;省略 language 参数可自动语种识别,并在解码时按需切换 return_format="transcription_only" 或包含语言解析结果的 "parsed" 模式:
uv pip install torch transformers accelerate

from transformers import AutoProcessor, AutoModelForMultimodalLM

model_id = "Reson8/Rumble-2-Flash"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

inputs = processor.apply_transcription_request(
    audio="https://hf.co/datasets/hf-internal-testing/dummy-audio-samples/resolve/main/bcn_weather.mp3",
    language="English",  # 省略该参数即可触发自动语言检测
).to(model.device, dtype=model.dtype)

output = model.generate(**inputs, max_new_tokens=512)
generated = output[:, inputs["input_ids"].shape[-1]:]
print(processor.decode(generated, return_format="transcription_only")[0])二、核心算法揭秘:On-Policy 在线策略蒸馏 + GOLD 跨词表概率对齐
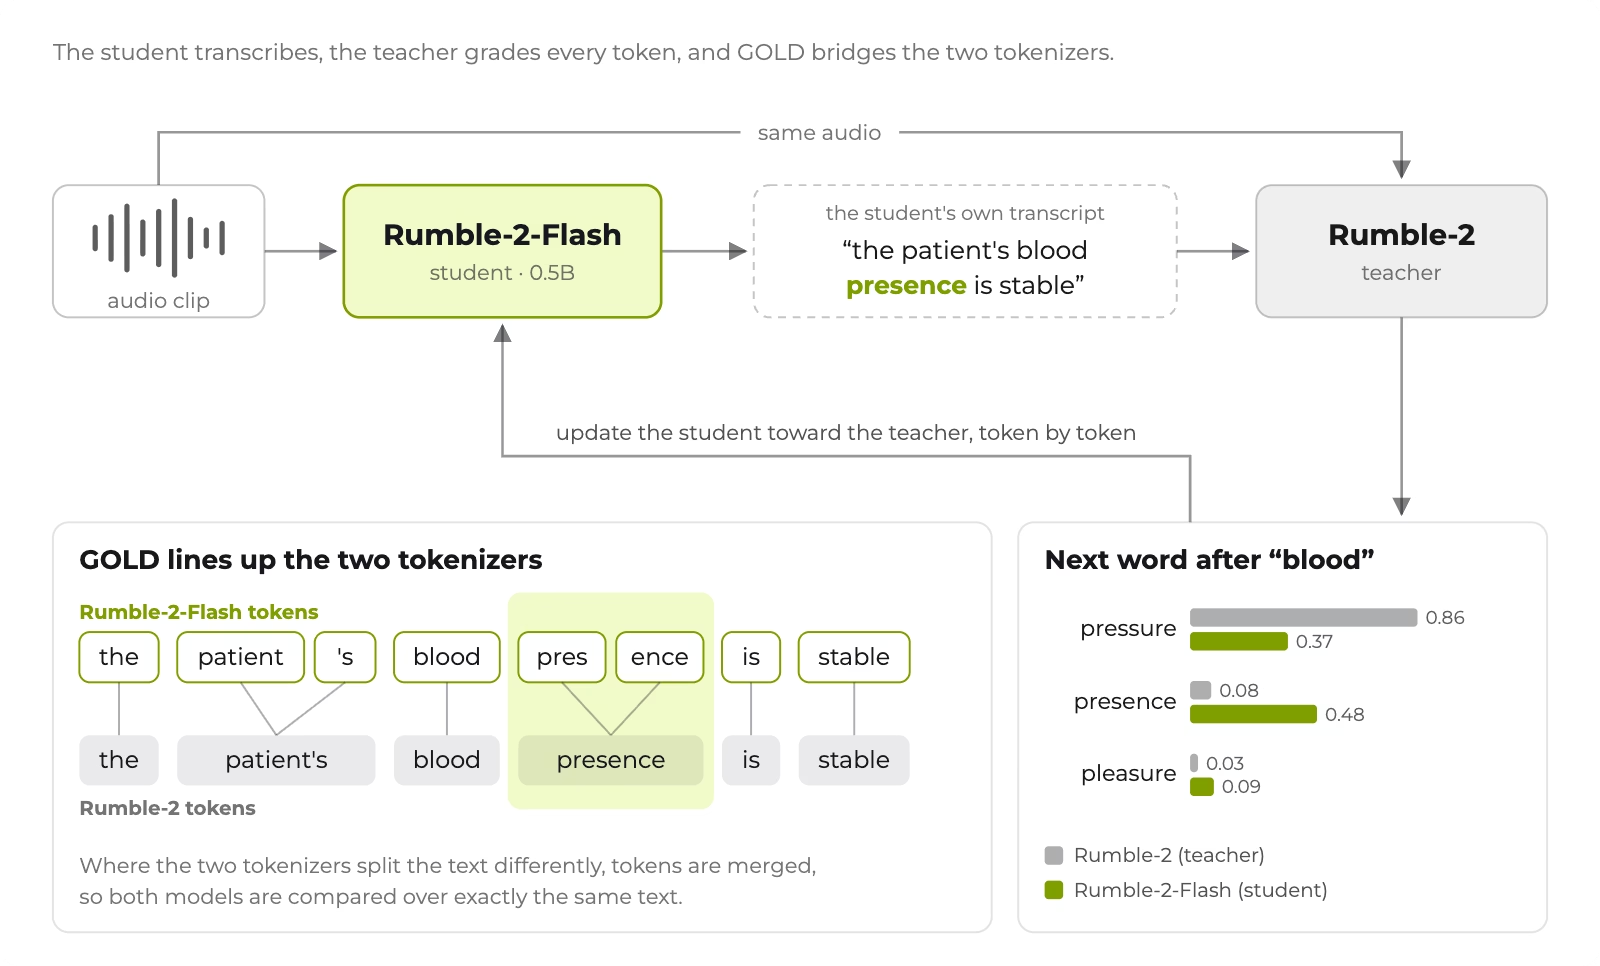
只有 0.5B 参数的小模型为何能具备媲美大模型的声学鲁棒性?Reson8 在博客中披露,团队为了探明“模型压缩到多小才会开始明显掉点”,选择将自家更大的生产级模型 Rumble-2 作为教师,采用 On-Policy Distillation(在线策略蒸馏) 对学生模型进行训练。
与传统“教师预先批量生成固定转录文本、学生做监督微调(SFT)”的离线蒸馏完全不同,On-Policy 模式下,学生模型必须自己对着音频进行转写解码;紧接着,教师模型会针对学生实际吐出的每一个 Token 位置逐一打分,并给出“在该上下文位置教师自己认为下一个词应该是什么”的完整概率分布。因为学生直接从自己犯错的分布轨迹中获得细粒度纠正(Token-level 反馈而非整段音频只给一个标量奖惩),纠偏效率呈数量级提升。
然而,在线策略蒸馏在工程上有一条传统铁律:教师和学生通常必须共享同一套分词器(Tokenizer),否则词表无法逐 Token 对齐。Reson8 为了兼容 Qwen3-ASR 生态必须沿用 Qwen 的词表,而自家教师模型 Rumble-2 拥有独立词表——为此团队引入了 GOLD 算法破除词表绑定限制。GOLD 会在两套分词器对同一段文本切分不一致的位置自动合并对齐 Token 跨度,确保双方始终在相同的文本片段上比较分布:两个词表中共同存在的 Token 直接对齐对比概率,其余差异 Token 则通过排序后的概率分布进行匹配计算。
三、多语言精度与极限吞吐实测:6.96% WER 反超 7B 模型,7,000+ RTFx 破音速推理
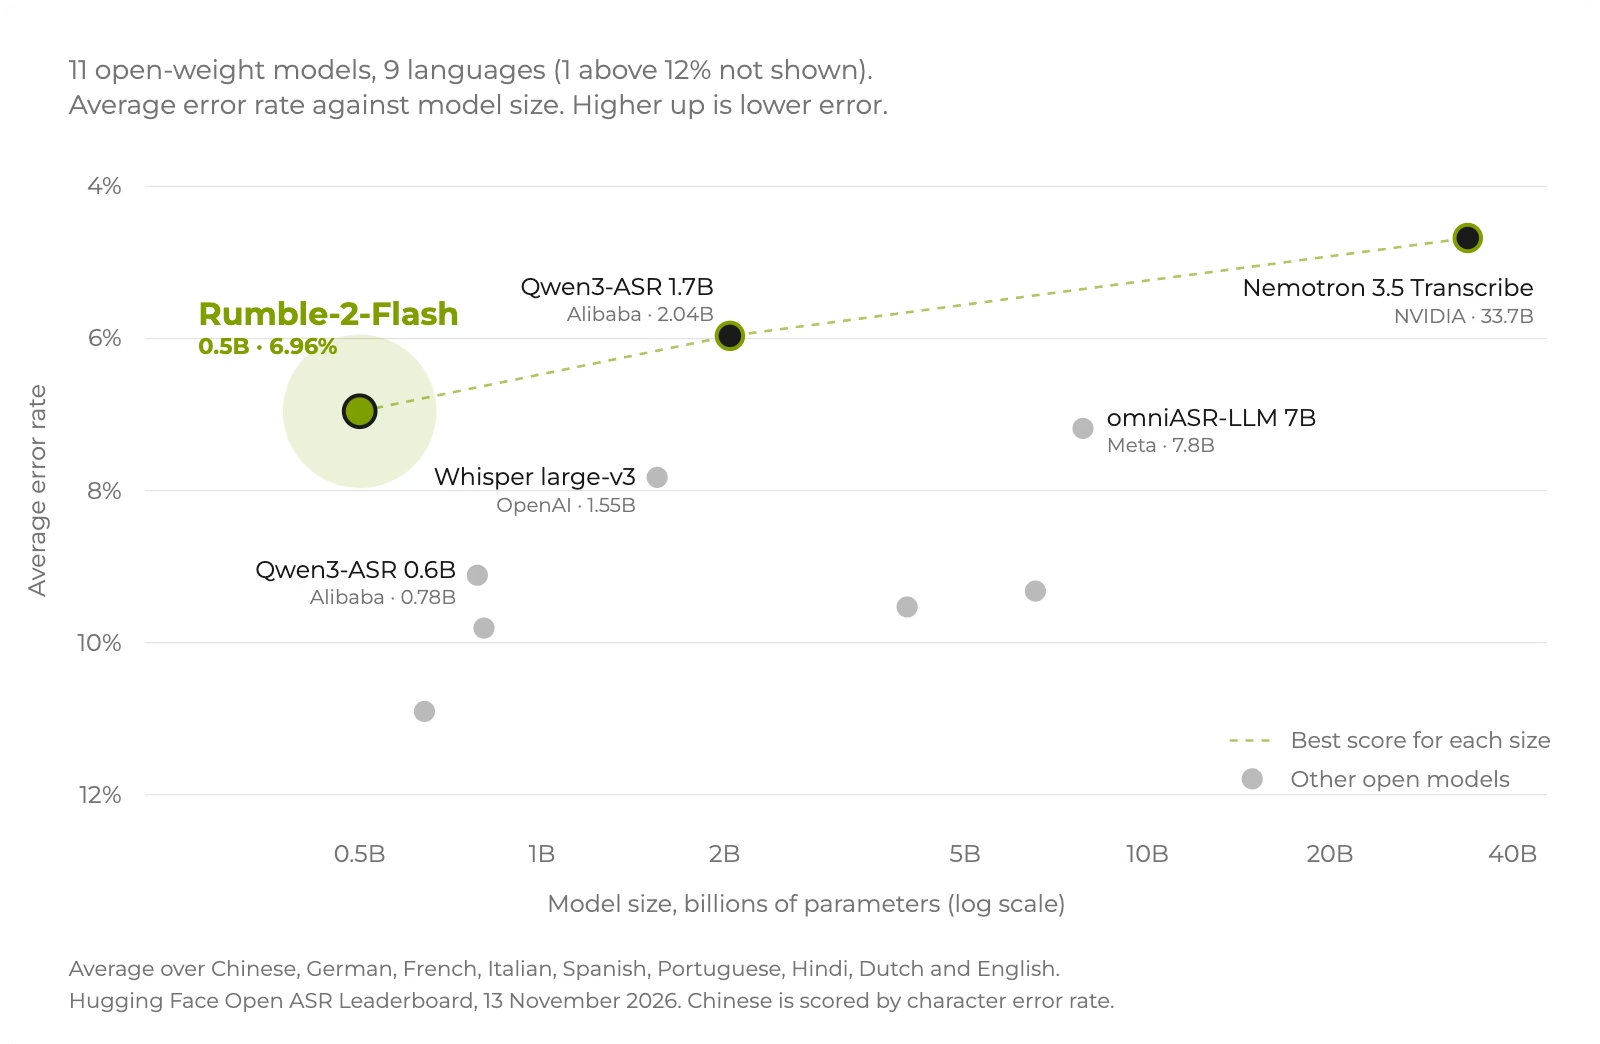
在 Hugging Face Open ASR Leaderboard 多语言赛道中,Rumble-2-Flash 横跨中文、德语、法语、意大利语、西班牙语、葡萄牙语、印地语、荷兰语与英语共 9 个主流语种测得 6.96% 平均词错率(WER)——以 0.5B 体量正面反超体量大出 15 倍的 Meta omniASR-LLM 7B,并领先经典的 Whisper large-v3;在纯英语赛道中,其平均 WER 进一步下探至 6.6%。
吞吐性能则是 0.5B 轻量化的另一大杀手锏。官方实测表明,Rumble-2-Flash 的吞吐随批处理(Batch)饱和度线性攀升:在 Open ASR Leaderboard 中样本充足、能够吃满 Batch 的大型数据集上,模型飙出了超过 7,000 RTFx 的惊人速度——换算下来,大约半秒钟就能完成一整小时音频的转写任务。
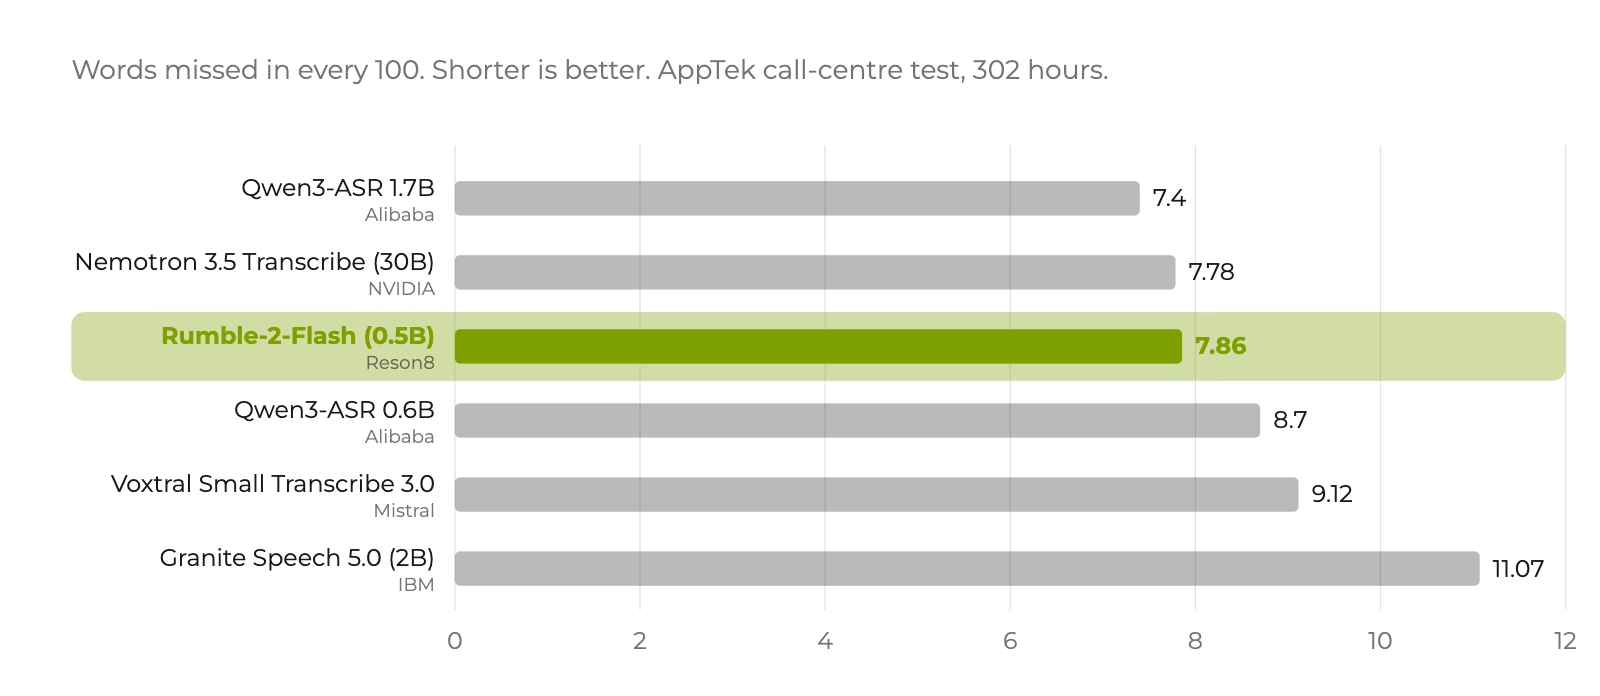
针对干净录音棚音频“容易刷高分”的业界通病,Reson8 还专门在 AppTek 真实呼叫中心基准(包含 302 小时热线通话录音、覆盖 14 种英语口音,且全部压缩带噪,统一采用 AppTek 官方评分脚本)进行了严苛测试。结果显示,Rumble-2-Flash 拿下 7.86% WER,几乎追平参数量高达 30B 的 NVIDIA Nemotron 3.5 Transcribe(7.78%),显著击败同族的 Qwen3-ASR 0.6B(8.7%),并紧咬规模三倍于己的 Qwen3-ASR 1.7B(7.4%)。
| 对比模型 | 参数量级 | Open ASR 多语种 / 英语 WER | AppTek 302h 电话基准 WER | 生态与部署特征 |
|---|---|---|---|---|
| Reson8 Rumble-2-Flash | 0.5B | 6.96% (9语种) / 6.6% (英语) | 7.86% | Apache 2.0,Qwen3-ASR 原生兼容 vLLM,峰值 >7,000 RTFx |
| Qwen3-ASR 0.6B | 0.6B | 同架构基准参照组 | 8.7% | 同门轻量基座,嘈杂电话口音错误率高于 Rumble-2-Flash |
| Qwen3-ASR 1.7B | 1.7B | 同家族中量级参照组 | 7.4% | AppTek 对比中唯一小幅领先的更大规模同系模型 |
| Meta omniASR-LLM 7B | 7B (约15x) | 多语言均值落后于 Rumble-2-Flash | — | 大模型参数负担高,显存占用远高于 0.5B |
| NVIDIA Nemotron 3.5 Transcribe | 30B (约60x) | — | 7.78% | 30B 重型商用/开源模型,Rumble-2-Flash 以 1/60 体量逼近 |
四、工程选型边界与语音 Agent 落地场景建议
在评估是否将 Rumble-2-Flash 引入生产环境时,技术团队需要看清两项关键边界条件:第一,超过 7,000 RTFx 的极端吞吐源自 Open ASR 大数据集下 满 Batch 并发填充,对于单路实时对话流(Batch Size = 1),实际收益主要体现为极低的显存占用与单步低延迟,而非直接套用 7,000 RTFx 的离线吞吐指标;第二,虽然它在 14 种英语口音与 40+ 语种上表现惊艳,但在强行业专有名词(如垂直医疗术语或特定代码库标识)场景中,依然需要结合业务词表热词或后端 LLM 纠错管线进行兜底。
综合来看,对于海量播客/客服录音的离线批量清洗、边缘端多语种字幕生成,以及与现有 vLLM 文本推理集群混部以榨干闲置 GPU 算力的场景,Rumble-2-Flash 在“精度、许可自由度(Apache 2.0)与标准生态零改造成本”三者之间交出了一份极难挑剔的工程答卷。
📝 站长洞察 (Editor’s Insight)
Reson8开源Rumble-2-Flash最值得工程团队借鉴的,并非单纯把模型压到0.5B,而是“架构向主流标准妥协+训练向在线蒸馏突破”的务实路线。过去许多垂直团队自研小模型,往往死在推理框架不兼容、开发者要专门维护Fork分支的最后一公里;Reson8果断借壳Qwen3-ASR标准词表与权重结构,并用GOLD跨词表对齐技术抹平了师生模型Tokenizer异构鸿沟,最终换来Transformers与vLLM的Day-0开箱即用。对于苦于高并发语音质检与语音Agent前端转写算力账单的团队,这种“5亿参数打平30B重型模型电话表现”的在线策略蒸馏范式,正在重新定义端云ASR的性价比基线。
Rumble-2-Flash适合哪些语音场景?
适合高并发语音交互Agent、会议纪要、呼叫中心质检等场景,尤其适合需要多语种识别、真实电话噪声处理和低成本部署的工程团队。
Rumble-2-Flash为什么能比大模型更快?
它只有0.5B参数,且复用Qwen3-ASR架构,能直接在transformers和vLLM中运行;官方披露吞吐超过7000 RTFx,因此可实现极高并发和快速转写。
On-policy蒸馏和GOLD对齐解决了什么问题?
On-policy蒸馏让学生模型基于自身输出接受逐Token纠偏;GOLD跨词表对齐则解决教师与学生分词器不同无法逐Token对齐的问题,保证蒸馏可用。
GOLD跨词表蒸馏怎么落地?
核心是把大模型的跨语言对齐能力迁移到小模型,同时保留目标语言的发音与标点分布。实操上要做多语种混训、统一 token 映射和难例重采样,否则小模型会在低资源语言上掉点明显。
7000+ RTFx部署要注意什么?
高吞吐不等于低成本,真正上线要看批处理策略、流式切分、显存占用和长音频稳定性。建议先压测不同 batch、量化方案和并发上限,再决定是否用 CPU/GPU 混部或边缘部署。


