Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
Search
  • Contact
  • Blog
  • Complaint
  • Advertise
© 2024 Prompt 语宙. HalfPX. All Rights Reserved.
阅读: 0.5B小参数拿下SOTA!蚂蚁百灵重磅开源Ming-3.0全链路语音模型家族:首创导演模式情绪微调、长音频端到端理解与免训热词注入全景实测
Share
登陆
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
Search
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • Contact
  • Blog
  • Complaint
  • Advertise
© 2023 Prompt 语宙. Paooo.com. All Rights Reserved.
蚂蚁百灵 Ming-3.0 全链路语音大模型家族官方架构与开源模型列表
Prompt 语宙 > AI 工具 > 0.5B小参数拿下SOTA!蚂蚁百灵重磅开源Ming-3.0全链路语音模型家族:首创导演模式情绪微调、长音频端到端理解与免训热词注入全景实测
AI 工具

0.5B小参数拿下SOTA!蚂蚁百灵重磅开源Ming-3.0全链路语音模型家族:首创导演模式情绪微调、长音频端到端理解与免训热词注入全景实测

站外新闻
最近更新: 2026年11月1日 上午10:07
Ming-3.0 蚂蚁百灵 语音大模型 语音识别ASR
SHARE

💡 站外导读:传统的语音技术往往被人工划分为语音识别(ASR)、音频理解(Audio Understanding)与语音合成(TTS)三大孤立领域,导致全链路交互中时延累加、情绪信息丢失且长音频推理极为笨重。蚂蚁百灵团队正式开源其自研的 Ming-3.0 语音大模型家族,涵盖 5 款专精模型,首创自然语言“导演模式”与显式行内副语言控制,并以 0.5B 的极轻量端侧参数规模斩获全球评测 SOTA,为智能座舱、AI 客服及长音频会议总结带来了一体化工业解决方案。
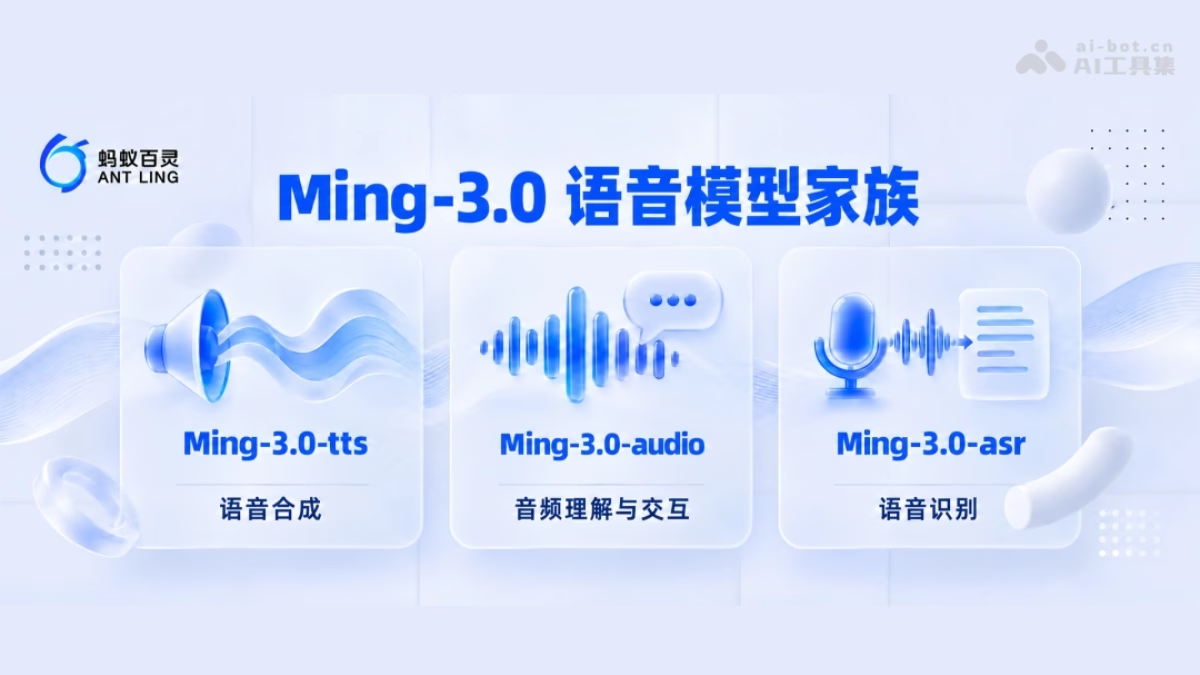
蚂蚁百灵 Ming-3.0 全链路语音大模型家族官方架构与开源模型列表
图 3:蚂蚁百灵 Ming-3.0 语音大模型开源矩阵与 Ling Studio 交互演示

一、全链路整合:Ming-3.0 语音模型家族的战略布局

在人机交互与多模态大模型的演进路径中,语音是最自然、信息密度最高的交互媒介。然而,传统的级联式语音方案往往面临“听得懂文字却听不懂语气、能播报台词却没有人类情感”的瓶颈。

阅读目录
  • 一、全链路整合:Ming-3.0 语音模型家族的战略布局
  • 二、硬核技术架构剖析:三大模块与五款核心模型
    • 1. TTS 系列与“导演模式”:0.5B 小参数的高自然度表演级合成
    • 2. 显式副语言控制:行内标签让笑声与叹息自然流露
    • 3. Audio 系列长音频理解架构:6.25Hz 低帧率表征与稀疏 MoE 混合注意力
    • 4. Context ASR 识别引擎:免训练上下文与多方言热词动态注入
  • 三、Ming-3.0 vs 小红书 FireRedASR2S 架构与能力全维对比
  • 四、开发者接入与工作流组合实操
  • 五、四大企业级核心应用落地场景
      • 📝 站长洞察 (Editor’s Insight)

Ming-3.0 是蚂蚁百灵全面开源的工业级语音模型全家桶,已历经支付宝、阿福健康 APP、蚁小保等核心千万级流量场景的深度锤炼,其产品线包括:

  • TTS 语音合成系列:推出 tts-0.5B 等模型,首创自然语言“导演模式”,用文字指令直接精细控制语速、重音、情绪起伏,甚至精准插入笑声与叹息。
  • Audio 音频理解与对话系列:推出 audio-flash 等模型,实现对长达数小时会议录音的端到端理解,自动提炼各方分歧与核心共识。
  • ASR 语音识别系列:推出 asr-tiny 等模型,独创 Context ASR 机制,无需重新训练即可动态注入业务专有热词与方言口音字典。

二、硬核技术架构剖析:三大模块与五款核心模型

1. TTS 系列与“导演模式”:0.5B 小参数的高自然度表演级合成

传统参数庞大的 TTS 往往部署成本高昂且难以实时交互,而轻量化模型又容易产生机械电音。Ming-3.0-tts 在仅 0.5B 参数的极小身材下,斩获了发音鲁棒性 93.2%(并列全榜第一)与 Controlled Voice 1069 Elo(开源权重第一)的傲人战绩:

  • 条件控制声学生成:将导演提示词(如“带着悲伤的语气,在后半句放慢节奏”)与音色参考特征联合编码为条件向量,与目标文本共同驱动声学生成,实现微表情级的情绪张力;
  • Voice Design 自由定制:无需庞大的微调过程,仅凭一段短参考音频或一段具象化的外貌性格描述,即可快速合成独具特色的拟真音色。

2. 显式副语言控制:行内标签让笑声与叹息自然流露

真实的人类交谈充斥着停顿、叹气、吞咽与笑声。Ming-3.0 引入了显式声学事件控制机制,创作者可以在文本中自由插入类似 [Laughter]、[Sigh]、[Cough] 等行内副语言标签,模型能精准在指定时序位置自然流露生理反应,打破了传统语音合成“一字一顿、生硬念稿”的死板质感。

3. Audio 系列长音频理解架构:6.25Hz 低帧率表征与稀疏 MoE 混合注意力

面对动辄 1~2 小时的长录音,直接输入会导致 Attention 矩阵平方级膨胀。Ming-3.0-audio-flash 采用了一整套端到端轻量化长程架构:

  • 在声学编码端采用 6.25 Hz 超低帧率表征,将音频 Token 序列长度大幅压缩;
  • 以自研 Ling-3.0 大语言模型为基座,深度融合 KDA 与 Gated MLA 混合注意力机制,在长上下文下精准保持多说话人声线记忆;
  • 配合稀疏 MoE(混合专家)计算分流,大幅压低长音频交互的推理资源开销,支持秒级连续问答与关键事实定位。

4. Context ASR 识别引擎:免训练上下文与多方言热词动态注入

在面对带有地方口音(如川普、粤普)以及涉及医疗术语、证券代码的专业场景时,传统 ASR 常常需要收集专用语料重新微调。Ming-3.0-asr-tiny 则巧妙复用了 LLM 基座强大的上下文先验理解能力:推理时只需在 Context 中动态附带当前用户的信息或专业词汇表,模型即可实时进行同音字校偏,综合错误率低至 4.41%。

三、Ming-3.0 vs 小红书 FireRedASR2S 架构与能力全维对比

对比维度 Ming-3.0 (蚂蚁百灵) FireRedASR2S (小红书)
产品核心定位 涵盖“合成+理解+识别”的全链路全能语音模型家族 专注工业级高准确率的 ASR 语音识别流水线系统
能力矩阵覆盖 语音合成 TTS、长音频理解 Audio、语音识别 ASR 全覆盖 专精识别领域(含 VAD、语种识别 LID 与标点预测)
TTS 表现力与创新 独创“导演模式”、行内副语言标签、0.5B 小参数 SOTA 不包含 TTS 模块
长音频直接理解 支持端到端长音频理解、观点提炼与结构化纪要输出 输出逐字稿,需级联外部大语言模型进一步处理
专有名词热词适配 Context ASR 零微调动态注入候选词与对话上下文 依靠特定解码词典或专用热词匹配模块
生产检验背景 支付宝亿级移动端、阿福 APP 语音医生、金融安全核身 小红书短视频与直播业务场景

四、开发者接入与工作流组合实操

开发者既可以通过蚂蚁百灵云端控制台极速接入,也可从 Hugging Face 完整拉取模型权重进行私有化部署:

  • 官方在线体验:访问 https://ling.tbox.cn,进入 Ling Studio Chat 即可在线体验 Ming-3.0-audio-flash 的长音频多模态问答。
  • 开源权重下载:项目已在 Hugging Face 全量开源:
    # 查看并拉取 Ming-3.0 开源权重合集
    https://huggingface.co/collections/inclusionAI/ming-30
  • 三合一业务闭环构建:在智能客服或数字人中,可将 asr-tiny(用户语音输入转写)与 audio-flash(意图推断决策)及 tts-0.5B(情感语音播报)串联,打造全双工、低延迟的语音互动闭环。

五、四大企业级核心应用落地场景

  • 智能会议秘书与长访谈整理:用 audio-flash 直接对两个小时的多人研讨录音进行结构化归纳,自动生成“达成的决策点、存在的分歧点、待办追踪事项”,大幅解放行政与纪要整理人员。
  • 影视动漫有声剧与角色配音:借助“导演模式”与 [Laughter]、[Sigh] 副语言标签,配音演员与创作者可低成本调优出哭腔、调侃、微颤等极具舞台感染力的声音资产。
  • 金融与政务方言多轮智能客服:asr-tiny 免微调注入社保、税务或理财专有名词,即便老年客户使用地方方言叙述,也能实现极高精度的意图捕获。
  • 车载语音助理与陪伴数字人:利用 0.5B 小参数的高效率,轻松在座舱 SoC 或边缘设备上离线运行,保障无网环境下的流畅陪伴交互。

📝 站长洞察 (Editor’s Insight)

语音交互被公认为是未来自主 Agent 与物理世界交互的天然外壳。但长期以来,行业内缺乏兼具“端侧极低算力消耗”与“专业级表演表现力”的开源全栈语音产品。蚂蚁百灵 Ming-3.0 的开源,最让人眼前一亮的是其对“情感表演”与“轻量化”的双重执着——用 0.5B 的小参数把发音鲁棒性做到全球顶尖,并首创用“导演模式”消除了冷冰冰的机械感。它让每一个普通开发者都可以零门槛搭建一个兼具高智商与高情商的专属语音智能体,是语音 AI 工业化落地的一记重拳。

ToonComposer:腾讯联手顶尖高校发布AI动画神器,草图秒变专业动画!
Mood AI
Jochem
FramePackLoop:AI一键生成无限循环视频,首尾无缝连接,赋能视频背景与创意设计
Pebblely
TAGGED:Ming-3.0蚂蚁百灵语音大模型语音识别ASR
分享
Email 复制链接 打印
Share
上一篇 火山引擎 Seedance 2.5 4K 视频生成模型官网展示与大荧幕级画质评测 大荧幕级质感与10-bit色彩!火山引擎重磅发布Seedance 2.5 4K视频生成模型:首创Draft样片试错工作流与影视级文戏微表情全景实测拆解
下一篇 Canva Brush 官方视觉语言设计编辑模型架构与跨页编辑实操界面 告别逐页手动微调与生成式死板图层!Canva重磅发布设计编辑模型Brush:首创智能体代码自检循环、提速69%且全元素二次可编辑深度实测拆解
发表评价

发表评价 取消回复

您的邮箱地址不会被公开。 必填项已用 * 标注

Please select a rating!

Ad image
- 入群领取知识星球折扣卷, 仅剩99份 -
Ad imageAd image

最近更新

StartLux Labs 开源决策模型家族 Startlux-Decision 官方架构与性能基准全景图
告别逐字生成算力浪费与黑盒幻觉!StartLux Labs重磅开源决策模型家族Startlux-Decision:单次前向毫秒级概率置信度、256K多模态长状态与Agent路由全景拆解
AIGC 资讯
生数科技新一代旗舰视频生成大模型 Vidu Q4 Preview 官方产品与生成实操界面
15图+3音频多主体一致性创业界纪录!生数科技重磅发布旗舰视频大模型Vidu Q4 Preview:首创U-ViT端到端音画同出、4K 10-bit影视级运镜全景实测拆解
AI 工具
NaiveAI 开源 Naive-N0.5-Flash 309B MoE 大模型架构与推理加速全景基准图
首创全网无全注意力层与单流狂飙2122Token!NaiveAI重磅开源309B MoE大模型Naive-N0.5-Flash:SWA+DSA混合稀疏、原生1M上下文与AI研发AI全景实测深度拆解
最新趋势
微软推出专为结构化决策与 Agent 编排设计的 Microsoft-Decision-1 架构全景图
速度狂飙35倍且输出完全免费!微软重磅发布新一代AI决策模型Microsoft-Decision-1:36项基准登顶第一、毫秒级概率评分与Agent路由编排全景拆解
AI 工具

相关推荐

AI 工具

EchoFox

remaker
AI 工具AIGC 资讯

快手AudioGen-Omni框架:多模态音频生成新突破,1.91秒生成8秒高清音频

站外新闻
AIGC AudioGen-Omni 多模态音频生成 快手 视频配音
AI 工具

Stillgram

remaker
AI 工具AIGC 资讯

小红书开源FireRedASR2S语音识别模型:2.89%超低字错率,支持20+方言与端到端部署

站外新闻
小红书 开源模型 方言识别 端到端ASR 语音识别
/ Prompt 语宙 /

Experience the limitless creative possibilities of generative AI and unlock new levels of innovation.

Quick Link

  • Remaker AI
  • BGRemaker 抠图Hot
  • AIGC 工具
  • Prompt 咒语生成器
  • 去水印工具

Support

  • Contact
  • Blog
  • Complaint
  • Advertise

标签

AIGC Midjourney prompt AI Agent GPT Image 2 openai 多模态大模型 字节跳动 具身智能 AI绘画 EvoLink灵感 开源工具 开源模型 Anthropic 开源大模型 早报 大语言模型 强化学习 MoE架构 腾讯混元 AI智能体 阿里通义 多模态AI AI视频生成 chatgpt AI工具 开源框架 教程 扩散模型 世界模型
Prompt 语宙Prompt 语宙
Follow US
© 2009-2026 Prompt 语宙. Paooo.com. All Rights Reserved.