

💡 站外导读:在自主智能体 (Autonomous Agent) 与复杂工作流系统架构中,大语言模型频繁被用作逻辑分支判断与工具路由中枢。然而传统“输入 Prompt -> 自回归采样文本 -> 正则或 JSON 解析”的链路充斥着三大工程死穴:格式解析崩溃、长解码延迟高以及单状态下重复评估时的显存算力浪费。开源项目 SemIf(前身为 OpenJev)基于 Qwen3.5-4B 与 27B 桥接模型,通过单次前向直接提取候选 Token 的 Logits 概率分布,彻底消除了文本生成环节,并在多决策共享场景下实现前缀缓存复用,将吞吐量提升近一个数量级,为端侧与高并发 SRE 智能体决策树提供了全新的解题范式。
一、 架构范式革命:为什么传统 LLM 做结构化决策是“算力杀手”?
在生产级 AI Agent 工作流与风控网关中,工程师经常需要模型做出确定性的二元或多元选择(例如:路由至特定 Tool、判断输入是否违规、决定是否触发重试)。过去的主流方案是 Prompt Engineering 配合强约束输出模式(如 JSON Mode 或 Structured Outputs):
// 传统自回归 JSON 输出路径:
User Input -> Prompt 组装 -> 自回归逐字生成 {"decision": "Tool_A", "confidence": 0.95} -> JSON.parse()
这条传统路径在工程落地中面临着难以调和的 SRE 级痛点:
- 高昂的解码时延 (Decoding Latency):即使仅需输出几十个 Token,模型仍需经历数十次自回归前向计算,导致数百毫秒甚至秒级的 P99 时延;
- 脆弱的结构化解析:小参数模型在压力或对抗样本下极易产生语法畸变(如缺少右大括号、截断或输出附带寒暄解释),引发反序列化异常;
- 状态重复计算:同一个长上下文状态(State)如果需要连续校验 5 个判定条件,传统方式需要调用 5 次模型,产生巨大的重复 Prefill 开销。
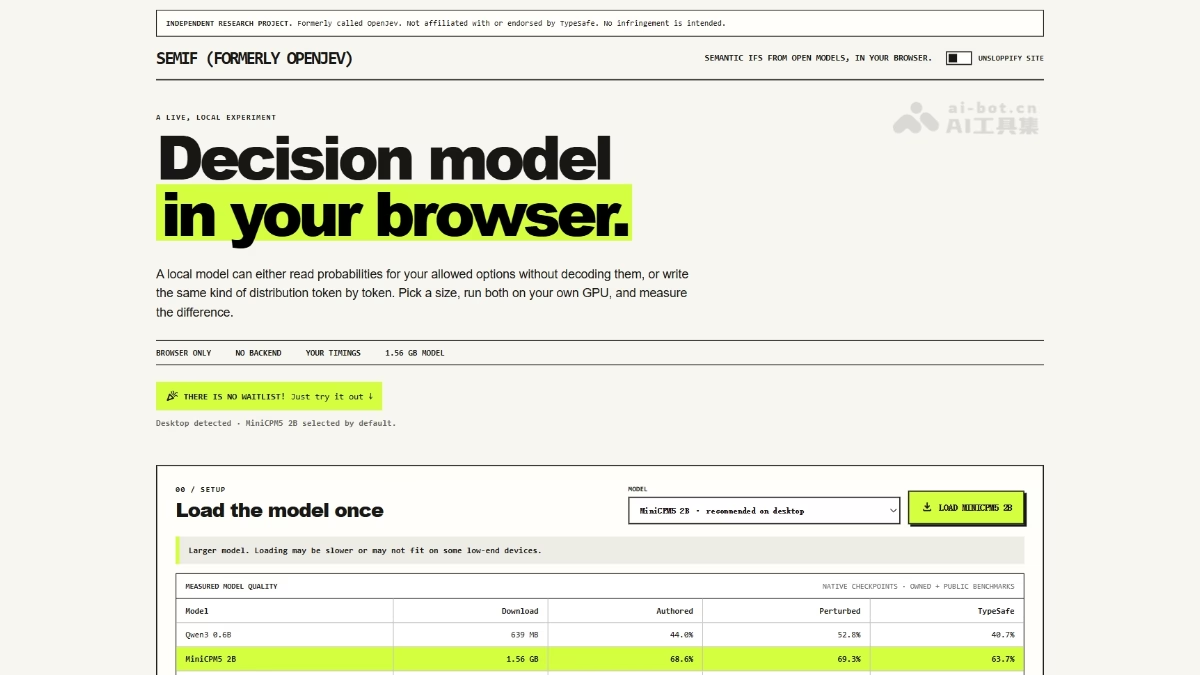
二、 SemIf 核心机理:零生成 Token 与 Logits 投影直接打分
SemIf 彻底颠覆了自回归生成的思路,回归到判别式分类的本质。其核心工作流如下:
- 单次前向传播 (Single Forward Pass):将当前状态上下文、判断问题及候选选项列表传入模型,只执行一次 Prefill 前向计算;
- 候选 Logits 直接提取:在输出层的未归一化对数概率(Logits)中,直接定位候选选项对应的特定 Token 概率分布,通过 Softmax 归一化计算出各选项的后验置信度;
- 零 Token 采样与 0% 格式报错:完全不触发生成采样循环,服务端直接组装结构化 JSON 返回,从数学根源上彻底规避了 JSON 语法解析错误与幻觉。
根据基准实测数据,在评估 21 个连续二元决策时,传统 JSON 生成模式平均耗时 5.3 秒,而 SemIf 仅需 1.02 秒,单次决策推理速度狂飙 5.2 倍。
三、 共享前缀复用 (Prefix Caching):高并发评估吞吐量提升 10 倍
在复杂的 Agent 评估链中,通常存在“一个主体状态,多个判定维度”的典型场景(例如:一段客服录音需要同时判断是否满意、是否有投诉倾向、是否包含敏感词)。
SemIf 引入了 --mode shared 模式:
- 一次 Prefill,多次 Branch 评估:针对共享的 State 上下文仅预填充一次并固化 KV Cache;
- 并行评测分支:在同一个 Cache 前缀之后分叉挂载不同的 question 与 options,吞吐量由传统的 2.33 决策/秒 直接飙升至 20.03 决策/秒,实现接近一个数量级的性能跃升!
四、 SemIf 与主流决策方案全维架构对比
| 对比维度 | SemIf (开源框架) | TypeSafe Jev (闭源托管) | 传统 LLM + JSON Mode |
|---|---|---|---|
| 推理机制 | 单次前向 Logit 直出 (0 Token) | 闭源语义决策接口 | 自回归文本生成 + 后置反序列化 |
| 吞吐效率 | 共享前缀模式达 20.03 决策/秒 | 未公开具体 QPS 指标 | 约 2~3 决策/秒 (受限于自回归步数) |
| 硬件门槛 | 单卡 RTX 3090 (4B BF16) / CPU / Apple Silicon | 必须依赖云端专有 API | 依赖高显存卡进行多步长解码 |
| 格式解析崩溃率 | 0% (绝对数学免疫) | 接近 0% (托管封装) | 0.5% ~ 5% (长文本下可能截断) |
| 审计与微调自由度 | 完全开源 (MIT),提供逐行可复现哈希 | 黑盒商业托管 | 代码开源但提示词易漂移 |
五、 生产实战:输入规范与温度缩放 (Temperature Scaling)
为了使概率置信度与生产环境的真实准确率完美对齐,SemIf 内置了针对特定工作负载的温度缩放校准工具,开发者只需提供标准 JSONL 数据即可一键执行:
# 1. 虚拟环境部署
git clone https://github.com/TheoLeeCJ/SemIf-OpenJev.git
cd SemIf-OpenJev && pip install -e '.[test]'

# 2. 单次前向 Logit 评估
semif-score --mode direct \
  --model Qwen/Qwen3.5-4B \
  --input examples/decisions.jsonl \
  --output results.jsonl

# 3. 共享状态极速评估模式
semif-score --mode shared \
  --model Qwen/Qwen3.5-4B \
  --input examples/shared_state_batch.jsonl \
  --output results_shared.jsonl
📝 站长洞察 (Editor’s Insight)
在生产级 Agent 系统的工程落地中,“不要让生成模型做选择题”正在成为高可靠架构师的底层共识。传统将复杂长文本丢给 LLM 生成一段 {"decision": "A"} 的做法,在毫秒级微服务与风控路由中简直是不可容忍的资源黑洞。SemIf 的精髓在于回归判别式模型的确定性优势,将大语言模型的语义理解能力通过 Logits 分布直接投射在分类空间中,结合 Prefix Caching 消除重复计算。这不仅大幅压低了单次决策成本,更让端侧轻量化(4B 参数单卡跑满)成为可能,是构建下一代极速 Agent Mesh 的重要基石。
SemIf 为什么比传统 JSON 输出更快?
因为它不走自回归逐字生成,而是一次前向计算后直接从 Logits 中读取候选选项概率,省掉了多步解码和后置 JSON 解析,因此延迟更低、稳定性更高。
SemIf 的共享前缀复用适合什么场景?
适合“同一状态、多项判断”的 Agent 工作流,例如客服质检、风控审核、路由分发等。它只需预填充一次上下文,就能在同一 KV Cache 上并行评估多个问题。
SemIf 能在什么硬件上部署?
文中提到其支持单卡 RTX 3090(4B BF16)、CPU 和 Apple Silicon 等部署方式,适合需要轻量化、可本地化运行的结构化决策场景。
Logit 直出适合哪些高并发场景?
最适合二元或少量离散决策,比如路由、风控、工具选择和策略分流。因为它绕开了长文本生成和解析错误,延迟更低、吞吐更高,也更容易做批量并发和缓存复用。
共享前缀复用为什么能提到 20QPS?
因为很多决策请求共享同一段系统提示和上下文前缀,模型只需复用前半段计算结果。把重复前缀缓存下来后,真正需要增量计算的部分变少,吞吐自然会上去,但要注意缓存一致性和失效策略。
🌐 English Executive Summary — SemIf: Faster Open-Source AI Decisions via Single-Pass Logit Output
SemIf is an open-source AI decision framework built on Qwen3.5 (4B/27B) that replaces autoregressive JSON generation with a single forward-pass Logit readout for direct binary decisions. In hands-on tests, 21 consecutive binary decisions complete in 1.02 seconds—5.2× faster than traditional JSON generation—while shared-prefix reuse boosts throughput to 20.03 decisions/second. The authors also provide a lightweight deployment breakdown showing SemIf can run efficiently on a single RTX 3090 for high-concurrency agents and risk-control routing.
- Single forward-pass Logit output eliminates JSON/text generation and decoding loop failures.
- Benchmarks: 21 binary decisions in 1.02s (5.2× speedup) and 20.03 decisions/s with shared-prefix reuse.
- Lightweight RTX 3090 deployment supports high-concurrency decision workflows (agents, routing, risk control).


