

💡 站外导读:生成式视觉大模型长期以来被诟病为“盲盒抽卡工具”,核心痛点在于设计师无法实现像素级局部修改、多图融合角色漂移以及复杂的图文信息图排版事实性匮乏。Google DeepMind 团队基于 Gemini 3.6 Flash 原生多模态底座正式推出 Nano Banana 2.1(API 标识 gemini-nano-banana-2.1)。该模型首创将大语言模型的显式 Thinking 推理链深度注入图像生成规划管线,支持多达 14 张参考图多主体保真融合与 1K/2K/4K 阶梯式输出,并在蒙版涂鸦局部编辑上逼近确定性控制,标志着 AI 绘图从“随机生成”向“工业化生产级设计”的代际跨越。
一、 底座跃迁与架构解密:Gemini 3.6 Flash 原生多模态统一生成范式
不同于业内普遍采用的“LLM 提词器 + 独立扩散模型 (Diffusion)”的外挂级联方案,Nano Banana 2.1 诞生于 Google DeepMind 最新的原生多模态架构体系。其底层深度整合了 Gemini 3.6 Flash 核心能力:
- 统一自回归与连续表征:在同一模型网络中直接实现多模态输入(文本、参考图、涂鸦蒙版)的统一编码,输出端支持直接生成视觉 Token;
- 1M 超长上下文吞吐:高达 100 万 Token 的上下文视窗,使得模型能够一次性载入数十页设计规范、全套品牌 VI 色卡及十数张参考素材进行协同分析;
- 解耦式分辨率阶梯:支持原生 1K、2K、4K 分辨率直出,并在 1:4、4:1、1:8 等极端超宽长幅排版中消除了传统扩散模型常见的拼接错位伪影。
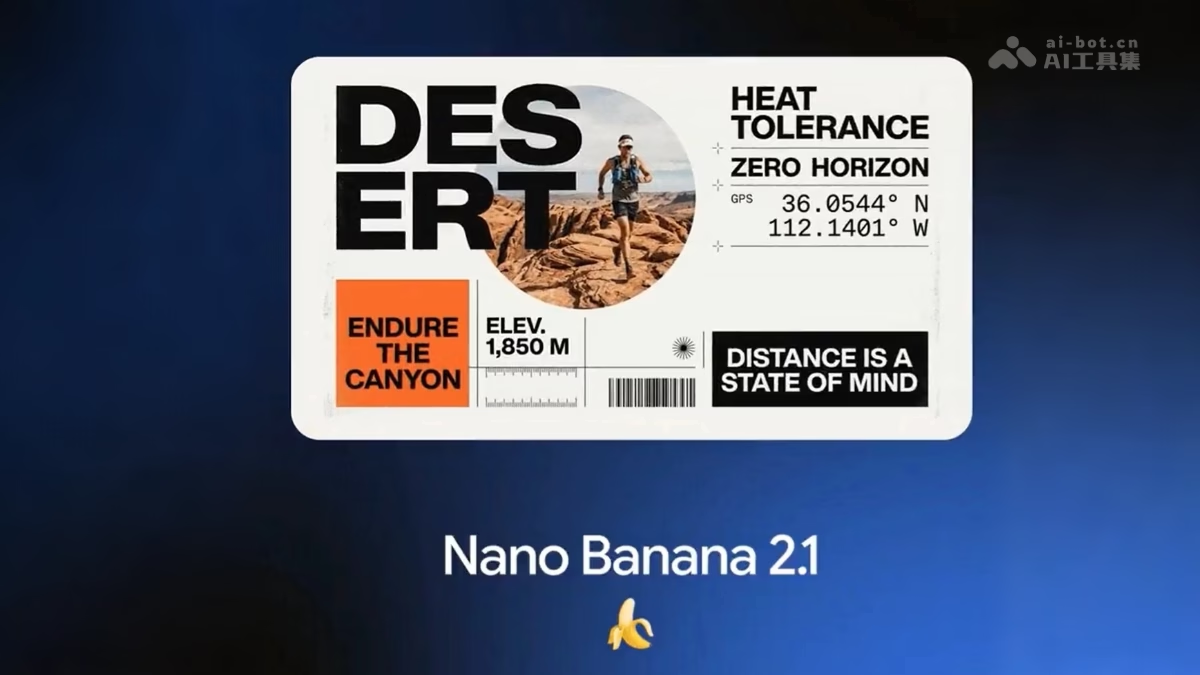
二、 关键技术破局:Thinking 推理模式如何重构平面设计与排版?
在 Nano Banana 2.1 中,Google DeepMind 首次引入了视觉生成的双轨推理机制:No Thinking 极速生成模式 与 Thinking 深度设计规划模式。
当开启 Thinking 模式后,模型在点亮像素之前会先经历显式认知推理过程:
- 语义结构拆解:自动分析海报或信息图的视觉权重层级(主标题、副标、数据图表、版权说明);
- 版式与留白规划:评估黄金分割比例、行间距以及排版避让规则,规避文字遮挡主体等低级错误;
- 实时检索 Grounding:联动 Google Web Search 与 Image Search 检索最新物理世界知识,确保科技信息图、科学结构图的事实准确性(其 Infographic Factuality 指标飙升至 0.521,断层领先旧版)。
三、 终结换脸漂移:14 张参考图融合与 1106 一致性评测
商业视觉生产最棘手的痛点莫过于“换镜头就换脸”或“多商品拼装变形”。Nano Banana 2.1 支持最多输入 14 张参考图,并在权威的多角色一致性(Multi-Character Consistency)评测中取得了 1106 分 的行业最高水准:
- 角色特质深度锚定:精准提取人物五官骨骼、发型光泽、服饰纹理并建立独立特征通道;
- 多实体交互重构:允许在同一画面中同时置入多位特定人物及多个品牌 SKU,并保持各自光影因果逻辑的高度一致;
- 去“AI 塑料感”:皮肤肌理、微小折痕与环境反射更趋近真实相机光学成像,告别千篇一律的蜡质磨皮质感。
四、 局部可控性革命:Mask/Ink 蒙版涂鸦如何做到“只改该改的”?
传统局部重绘工具往往在修改衣服颜色的同时,连带着把主体的动作、发丝甚至背景墙也进行了微弱重绘,导致版本无法对齐。Nano Banana 2.1 在 Mask/Ink-Based Editing 测试中获得了 1049 分 的卓越成绩:
| 核心维度 | Nano Banana 2.1 (Google) | ChatGPT Images 2.5 (OpenAI) | Midjourney v7 |
|---|---|---|---|
| 底层核心底座 | Gemini 3.6 Flash 原生多模态统一模型 | GPT Image 2.5 (Flare / Sunburst 双模型) | 专有混合扩散模型架构 |
| 推理思考模式 | 支持 Thinking 显式版式与约束规划 | 隐式多步微调提示词 | 无文本思考链机制 |
| 多图参考上限 | 最多 14 张参考图 | 最多 16 张参考图 | 最多 5 张且融合权重难以精准微调 |
| 事实性知识检索 | 深度整合 Google Search 实时 Grounding | 依赖静态模型预训练记忆 | 无事实性核验机制 |
| 多语言文字渲染 | 原生支持清晰中文、英文多字体本地化排版 | 英文优秀,复杂中文排版偶有笔画错乱 | 文字渲染能力较弱 |
五、 开发者调用与工程接入实践
目前 Nano Banana 2.1 已在 Google AI Studio、Gemini API 以及 Vertex AI 同步上线,开发者可在 API 中直接挂载模型 ID:
// 使用 Google GenAI SDK 调用示例:
import { GoogleGenAI } from '@google/genai';

const ai = new GoogleGenAI({ apiKey: process.env.GEMINI_API_KEY });
const response = await ai.models.generateImage({
  model: 'gemini-nano-banana-2.1',
  prompt: '专业医疗器械产品展板,瑞士极简网格排版,清晰中文结构标注',
  config: {
    resolution: '4K',
    thinking: true, // 开启设计推理链
    referenceImages: [ 'ref_model_face.jpg', 'ref_device_sku.png' ]
  }
});
📝 站长洞察 (Editor’s Insight)
Nano Banana 2.1 的推出揭示了图像生成领域的一个根本性转变:从单纯拼扩散模型的画质分辨率,转向拼“原生多模态推理能力与可编辑性”。传统基于 Stable Diffusion 或单一扩散框架的图像模型缺乏深层的语义推理与事实世界常识,因此在需要精确逻辑结构的信息图、多语言文字渲染和特定局部修改时频频崩溃。而 Google DeepMind 依托 Gemini 的原生多模态统一架构,让图像生成的每一步都受到语言模型 Thinking 规划与实时搜索 Grounding 的强约束。这种将 LLM 决策大脑与视觉渲染手脚融为一体的思路,正成为专业级设计工具不可逆的演进方向。
Nano Banana 2.1 适合做什么?
它更适合海报、信息图、品牌视觉、多角色合成和局部精修等专业场景。文章强调其优势在于 Thinking 设计推理、14 图融合、一致性控制和事实性信息图生成,适合追求可控输出的设计与开发流程。
Nano Banana 2.1 的 Thinking 模式有什么用?
Thinking 模式会先做语义结构拆解、版式与留白规划,并结合检索增强进行事实核验,再开始生成图像。这样能减少文字遮挡、排版混乱和信息图事实错误,更适合复杂设计任务。
Nano Banana 2.1 和普通 AI 绘图工具差别大吗?
差别主要在可控性和一致性。文章提到它支持最多 14 张参考图融合、蒙版局部精准编辑,并在多角色一致性和信息图事实性上表现更强,目标是从“随机出图”转向生产级设计。
14图融合最难解决的是什么?
最难的是跨图角色、风格和物体关系的一致性。实操上要先统一参考图的主体特征,再通过分层约束和局部编辑锁定关键元素,最后用蒙版精修处理冲突区域,避免融合后“像拼贴”。
信息图事实性怎么避免画错内容?
要把生成流程拆成“先抽取事实、再生成版式、最后校验文本与图形”。对知识型信息图,最好接入结构化数据源和人工复核,避免模型把数字、标签和关系图示意错,影响专业可信度。
🌐 English Executive Summary — Google DeepMind Nano Banana 2.1: Thinking reasoning, 14-image fusion, mask refinement
Google DeepMind has released Nano Banana 2.1, built on Gemini 3.6 Flash’s native multimodal foundation, introducing a first-of-its-kind “Thinking” design-reasoning workflow. It supports up to 14 reference-image fusion and mask-based local refinement, achieving a reported multi-character consistency score of 1106 and reducing face-drift during edits. The system also enables more precise Chinese layout generation and knowledge-enhanced infographic creation, targeting production-grade AI design workflows.
- Thinking design reasoning moves layout planning, whitespace, and fact-checking ahead of generation.
- Up to 14-image fusion plus mask-based local refinement improves edit precision and reduces identity drift (1106 consistency reported).
- Native support for Chinese typography and knowledge-enhanced infographic generation enables more reliable, production-oriented outputs.


