

💡 站外导读:拿到旗舰大模型直接替换生产环境,输出就一定更好、更省钱吗?资深 SEO 专家 Marie Haynes 基于私域知识库智能体 Marie’s Brain 交出了反直觉实测:在 6 道真实 SEO 难题上双盲评测 Gemini 4 Neon、Hydrogen 与 3.8 Flash,既揭开 Hydrogen 无约束检索反比 Neon 更烧钱的陷阱,也用真实 API 账单证实 Neon 以 5:1 胜出的商业可行性。
一、 上线前的意外翻车:Gemini 4 Hydrogen 陷入“过度检索循环”反比旗舰更贵
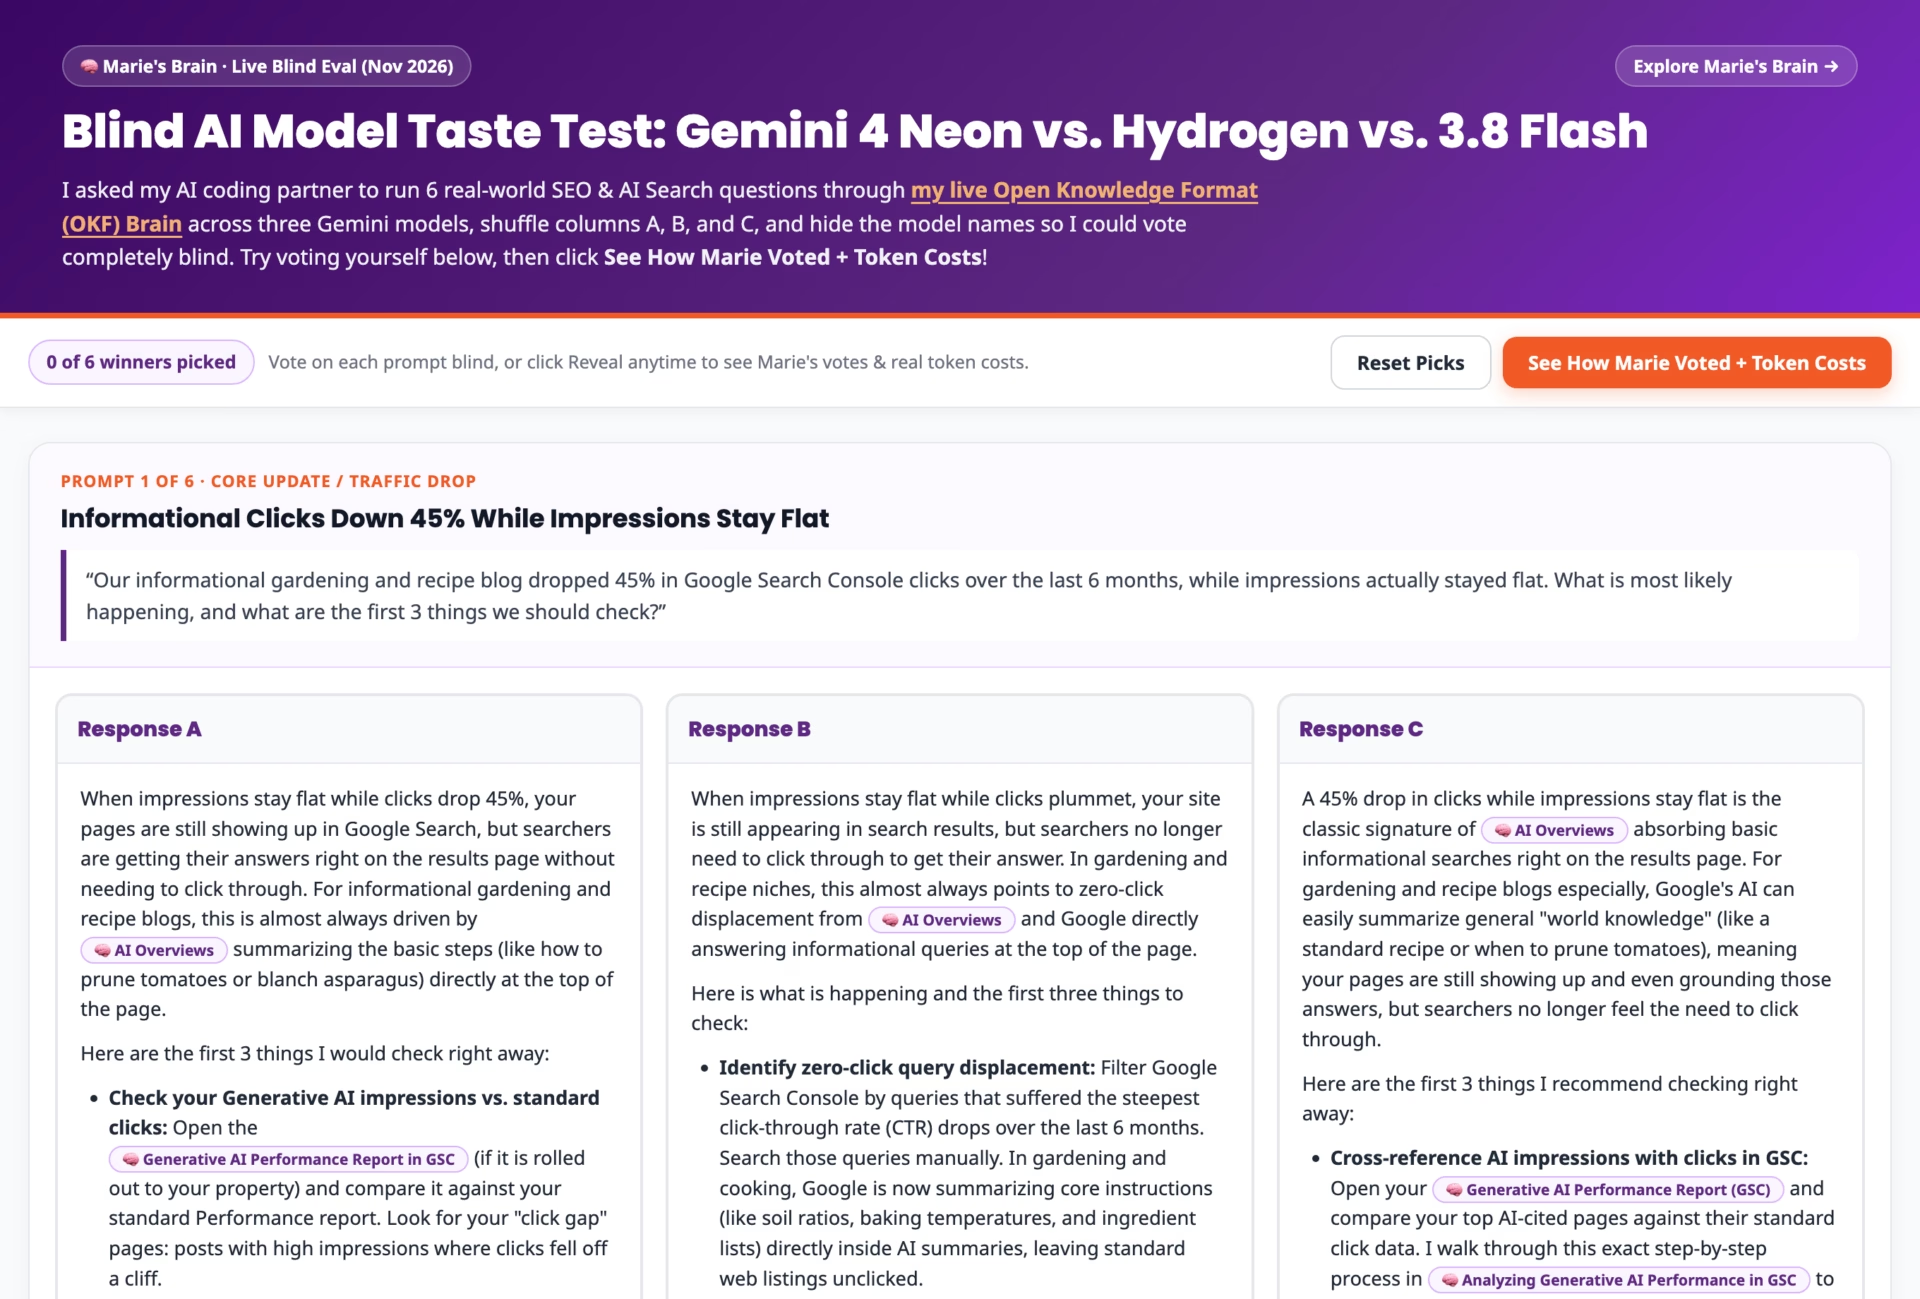
过去数月间,Marie Haynes 一直低调打磨一款名为 Marie’s Brain 的垂直 AI 副驾驶工具:它以人工精选整理的 Open Knowledge Format(OKF) 搜索与 AI 研究文档库为底座,叠加客户站点的实时数据上下文与价值 500 美元的诊断报告,为企业主提供可落地的 SEO 决策建议。最初她将后端切换至谷歌新推出的 Gemini 4 Hydrogen,但在日常使用中总隐约觉得输出质量未必强过此前的 Gemini 3.8 Flash,于是决定拉上旗舰级的 Gemini 4 Neon 同台进行公开可复现的三方盲测。
然而,第一轮测试尚未读完结果就率先暴露了一个惊人的工程 Bug。由于系统当时默认开启了不设字数上限的“Detailed(详尽)”模式,团队复查 Gemini API 日志后大跌眼镜:Gemini 4 Hydrogen 陷入了过度热心(over-eager)的自主检索死循环,平均每回答一个问题竟要连续读取 21 个 OKF 文件、耗时高达 68 秒、洋洋洒洒写出 1,600 词长文,算下来单轮提问成本冲上 0.44 美元——甚至比更强大的 Gemini 4 Neon 还要烧钱!与此同时,模型回答里还频繁夹杂 `MAGIT`、`FastSearch` 等谷歌内部工程与专利暗语,让急着查清“网站点击为何下滑”的普通业务负责人一头雾水。
为了在真实可控的生产配置下分出高下,Marie Haynes 在正式盲投前火速实施了三项立竿见影的上下文工程改造:第一,将默认输出切换为简洁模式(Concise Mode,约 180 至 280 词),让交互节奏接近一次高效的专家短通话;第二,在系统约束中硬性将每轮工具检索封顶为 1 至 2 个精准目标 OKF 文件,彻底堵死模型乱翻文档库的算力黑洞;第三,明确禁用谷歌内部专利代号,除非用户主动追问底层检索系统架构原理。
二、 6 道真实 SEO 难题双盲对决:Gemini 4 Neon 凭“人类顾问感” 5:1 横扫
改造完成后,三款模型在完全相同的工具集与简洁模式约束下,围绕 6 个一线站点高频遭遇的真实 SEO 与 AI 搜索考题展开盲测,涵盖:AI Overviews 导致自然流量下滑排查、存量信息型文章该删除还是重写、商业导购榜单页的核心正文(Main Content)构建、瘦弱地区落地页清理、面向智能体的 `/llms.txt` 就绪度评估,以及一份剔除 GEO 噱头的每周 5 小时务实增长计划。
盲测全程在每道题上随机打乱 A、B、C 三列模型顺序,一共生成 18 份回答由评测者逐题盲选。结果揭晓时几乎呈现一边倒的统治力:Gemini 4 Neon 狂揽 5 题胜利(5/6),Gemini 4 Hydrogen 仅在 1 题胜出(1/6),而前代主力 Gemini 3.8 Flash 则以 0/6 惨遭剃光头。更有意思的是胜出原因——三款模型调取的是完全一致的 OKF 知识库切片,Neon 并没有“多知道多少事实”,而是胜在沟通颗粒度与逻辑组织方式,读起来更像一位真正理解业务痛点的高阶顾问在拆解问题,而非千篇一律的 AI 套话。
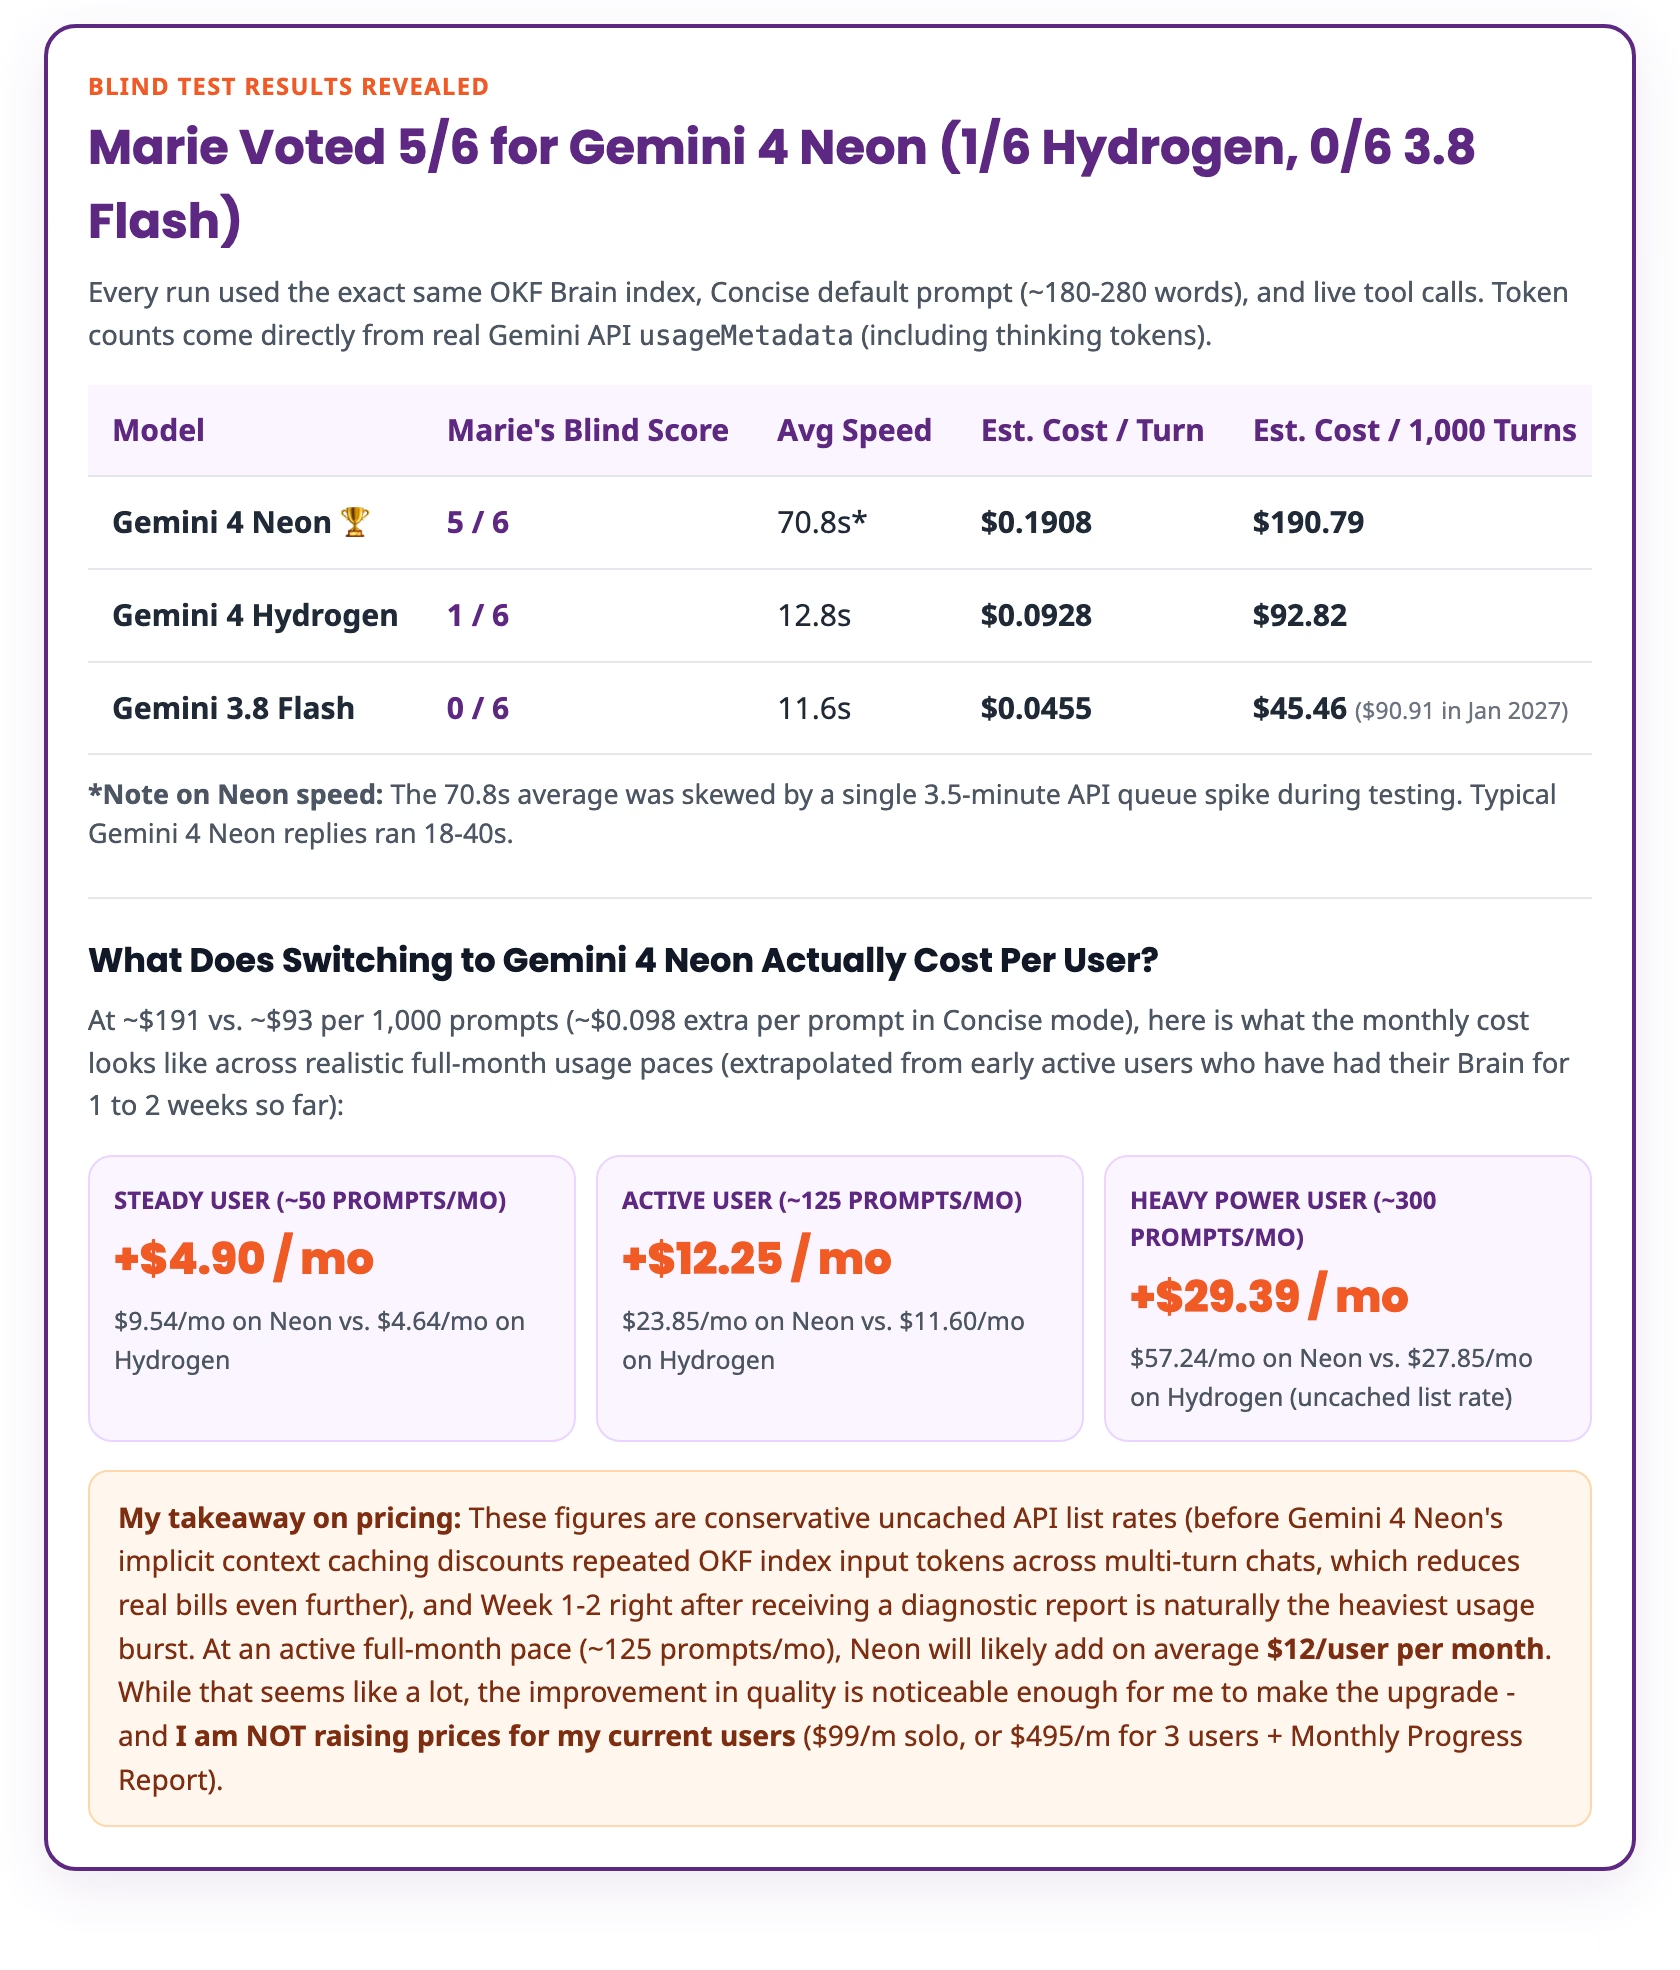
| 参测模型 (盲测胜率) | 平均响应速度 (含队列说明) | 平均输出篇幅 | 单轮及千轮未缓存 API 实测成本 |
|---|---|---|---|
| Gemini 3.8 Flash (盲测 0 / 6) |
11.6 秒 极速轻量响应基线 |
292 词 | 单轮 $0.0455 | 每千轮 $45.46 (注:2027 年 1 月起约升至 $91) |
| Gemini 4 Hydrogen (盲测 1 / 6) |
12.8 秒 比 3.8 Flash 仅慢约 1 秒 |
239 词 | 单轮 $0.0928 | 每千轮 $92.82 (高性价比快速折中方案) |
| Gemini 4 Neon (盲测 5 / 6 冠军) |
均值 70.8 秒 (受单次 3.5 分钟 API 队列尖峰拉高,常态流式 18–40 秒) |
275 词 | 单轮 $0.1908 | 每千轮 $190.79 (含思考 Token,按未缓存目录价测算) |
三、 从千轮单价到月度账单:隐式上下文缓存如何改写旗舰选型性价比
质量胜出之后,决定能否在 SaaS 产品中全量默认开启 Neon 的唯一标尺就是商业账单。表中的 API 费用均直接取自 Google Gemini 接口真实的 `usageMetadata`(已完整计入推理思考 Token),并严格按照保守的未缓存目录价(Uncached List Rates)核算。表面上看,Neon 每千轮 190.79 美元比 Hydrogen 的 92.82 美元贵了一倍(单次问答约多出 10 美分),但 Marie Haynes 将其映射至早期真实用户的月度使用频次后,账本立刻变得清晰可控:
- 稳定低频用户(约 50 次/月):选择 Neon 仅比 Hydrogen 多支出 +4.90 美元/月(9.54 美元对比 4.64 美元);
- 常规活跃用户(约 125 次/月):每月新增成本约为 +12.25 美元/月(23.85 美元对比 11.60 美元);
- 高频重度用户(约 300 次/月):在全未缓存口径下每月多出 +29.39 美元/月(57.24 美元对比 27.85 美元)。
更关键的成本安全垫在于隐式上下文缓存(Implicit Context Caching)。由于用户的每一次对话都会在系统前端复用同一份体积高达 约 55K Token 的 OKF Master Index 总索引,在多轮连续问答中,Gemini 4 Neon 会自动对重复命中的前缀输入 Token 施加隐式缓存折扣,使得线上实际账单显著低于上述保守测算值。综合画质跃迁与平均每月仅多出约 12 美元的活跃用户增量,Marie Haynes 已决定在不提价的前提下将 Marie’s Brain 默认模型全面升级为 Gemini 4 Neon,同时保留 Hydrogen 与 3.8 Flash 供追求极速秒回的用户按需切换。
四、 AI 搜索实战工程启示:Agent 工具调用次数封顶比盲目换模型更立竿见影
对于正在搭建垂直行业 Agent 或企业内部 RAG 问答助手的开发者而言,这份盲测暴露出的两条经验甚至比跑分胜负本身更具实战价值。首先,切忌在未限制工具调用上限的情况下直接用中大型推理模型跑自主搜索(Agentic Retrieval):Hydrogen 在无约束下狂读 21 个文件写出 1,600 词长文的教训证明,失控的 Tool Calling 循环会瞬间击穿更贵模型的预算防线,把一个原本定位中端性价比的模型跑成“最贵吞金兽”。
其次,高质量的专业副驾驶必须用提示词显式收敛话术风格与检索深度。通过把输出锚定在 180–280 词、强约束单轮最多调取 1–2 个精准知识片段、并屏蔽无助于业务决策的底层算法代号,团队不仅将单次交互延迟从 68 秒压回十余至数十秒的可接受区间,更把 55K Token 核心目录索引沉淀为了稳定吃满上下文缓存的常驻前缀——这才是让 Gemini 4 Neon 在真实商业场景中兼顾“像人类专家一样表达”与“SaaS 毛利可控”的核心工程密码。
📝 站长洞察 (Editor’s Insight)
Marie Haynes 这份附带真实 usageMetadata 计费明细的盲测报告提醒 AI 应用团队:模型能力只是半张考卷,工具调用循环边界与上下文缓存命中率才是账单生死线。放任模型在 Agentic 循环里无限翻阅二十余份文档,不仅拖慢响应至一分钟以上,还会让中端定位的 Hydrogen 跑出高于旗舰 Neon 的单轮成本。工程落地上,将默认输出收敛在两百余词、限制单轮工具检索 1~2 次,并把约 55K Token 核心索引固化为前缀以吃满隐式上下文缓存,往往能以月均十余美元的温和溢价换来质变级的专业交付体验。
Gemini 4 Neon 和 Hydrogen 哪个更适合 SEO 实战?
从这次双盲实测看,Gemini 4 Neon 更适合需要高质量策略判断的 SEO 场景,6 题中赢下 5 题;Hydrogen 适合追求速度与折中成本的日常任务,但在表达组织和顾问感上略弱。
为什么 Gemini 4 Hydrogen 反而比 Neon 更贵?
文章指出,Hydrogen 在默认详尽模式下出现过度检索循环,平均每题读取更多文件、耗时更长,导致单轮成本甚至高于 Neon。问题不在模型本身,而在检索约束和输出配置。
如何避免大模型在知识库检索中失控?
可通过三项设置控制:把输出改为简洁模式、限制每轮只检索 1 到 2 个精准文件、禁用不必要的内部术语或底层代号。这样能减少无效检索、缩短响应时间并降低成本。


