


💡 站外导读:传统 IT 运维几十年来只盯一个核心问题:“系统是否在线运行?”但 Forrester 研究团队最新警示,这套监控范式在 AI 原生云时代已经彻底失灵。AI 服务完全可以在接口响应正常、延迟达标、基础设施全线绿灯的情况下,一边持续输出错误答案并发生模型漂移,一边在运维毫无察觉时击穿策略红线与 Token 预算。随着 GPU 算力调度与渐进式衰退成为常态,云运维必须从“保在线”升级为“管结果”。
“系统绿灯”背后的静默崩塌:传统云运维为什么接不住 AI 负载?
当故障不再表现为进程宕机,而是渐进式衰退与隐形财务失血
在传统分布式 Web 架构中,“健康(Healthy)”的工程定义高度确定:进程存活、HTTP 探针返回 200、P99 延迟低于阈值且错误率可控,就意味着业务处于正常交付状态。然而在 Forrester 首席分析师 Carlos Casanova 与 Charlie Dai 联合发布的研究分析中指出,一旦大模型推理与智能体编排进入生产主链路,“系统在线”与“系统做对了事”之间就会裂开一道危险的缝隙。
结构上,AI 工作负载与常规微服务存在本质差异。首先,以 GPU 为核心的异构算力引入了截然不同的容量规划与动态调度约束,模型并发与长上下文请求带来的资源需求波动远比传统读写负载剧烈;其次,数据流转路径、提示词膨胀与模型推理行为不再只是数据工程或算法团队的问题,而是直接演变为财务运营(FinOps)议题——因为每一轮冗余检索、多步 Agent 死循环或推理档位误配,都会实时转化为成倍放大的算力与 Token 账单。
更令一线 SRE 团队防不胜防的是失效模式的改变。传统软件故障往往表现为明确的进程崩溃、连接超时或 5xx 告警风暴,监控大盘能在秒级捕捉异常;而 AI 系统的退化往往呈现为“渐进式衰退(gradual degradation)”。模型可能在连续数周内缓慢偏离预期输出分布、在边缘场景下悄悄越过合规护栏,或者使多智能体协同效率逐步恶化。由于没有触发任何基础设施告警,这类问题极易被运维团队忽略或降级为低优工单,直到引发客户信任危机或账单暴雷才被发现。
别再混淆两个概念:用 AI 做运维 vs 为 AI 建可观测性
打通“基础设施 → 应用 → 模型 → 智能体 → 业务结果”五层全链路视野
Forrester 指出,当前行业在推进 AIOps 转型时普遍存在一个认知混淆:把“AI 增强型可观测性(AI-enhanced observability)”当成了“面向 AI 的可观测性(observability for AI)”。前者是以 AI 为工具,通过异常检测、告警关联、故障日志摘要乃至自动自愈来提升传统云运维团队的排障效率;而后者则是把 AI 系统自身作为被观测的核心客体,解决“模型到底在干什么、花了多少钱、产出靠不靠谱”的黑盒难题。
真正的 AI 原生运维必须将可观测性从监控层的附属工具,重构为贯穿整个技术栈的“连接组织(connective tissue)”。在面向 AI 的观测体系中,运维指标必须涵盖模型漂移(model drift)、输出质量评估、提示词版本与上下文长度、智能体工具调用轨迹(agent behavior)、单位任务 Token 消耗与推理成本,以及最终对齐的业务转化结果。只有把监控边界沿着“基础设施 → 应用层 → 模型层 → 智能体层 → 业务结果”五级链条完整拉通,运维团队才能在问题刚露苗头时看清归因全貌。下表对比了传统云运维与 AI 原生云运维在核心工程维度上的代际差异:
| 对比维度 | 传统云运维 (System Health) | AI 原生云运维 (Outcome Health) | 核心工程改造抓手 |
|---|---|---|---|
| 健康的定义 | 进程存活、HTTP 200、延迟与 CPU 正常 | 输出准确可信、符合策略边界、单位成本可控 | 新增质量与合规 SLO 指标 |
| 典型失效模式 | 明确宕机、超时报错、5xx 告警风暴 | 渐进式模型漂移、幻觉、Token 成本静默飙升 | 建立持续评测集与成本异常阈值 |
| 可观测性链条 | 基础设施与应用层 (Metrics/Logs/Traces) | 基础设施 → 应用 → 模型 → 智能体 → 业务结果 | 追踪 Prompt、工具调用与语义漂移 |
| 韧性与恢复动作 | 容器重启、流量切备、扩缩容 | 模型重同步、语义缓存恢复、Prompt 受控回滚 | AI 依赖纳入 GitOps 与熔断演练 |
超越高可用 SLA:AI 时代的系统韧性必须能“恢复可信状态”
当业务部门追问“服务出了问题能不能拉起来”时,传统灾难恢复(DR)与韧性工程的答案是重启容器、切换多活机房或重建底层基础设施。但在 AI 生产环境里,Forrester 提出了一个尖锐的新问题:如果从基础设施到 API 网关没有任何组件发生技术宕机,服务却在稳定地输出胡说八道或不安全内容,重启 Pod 又能解决什么问题?
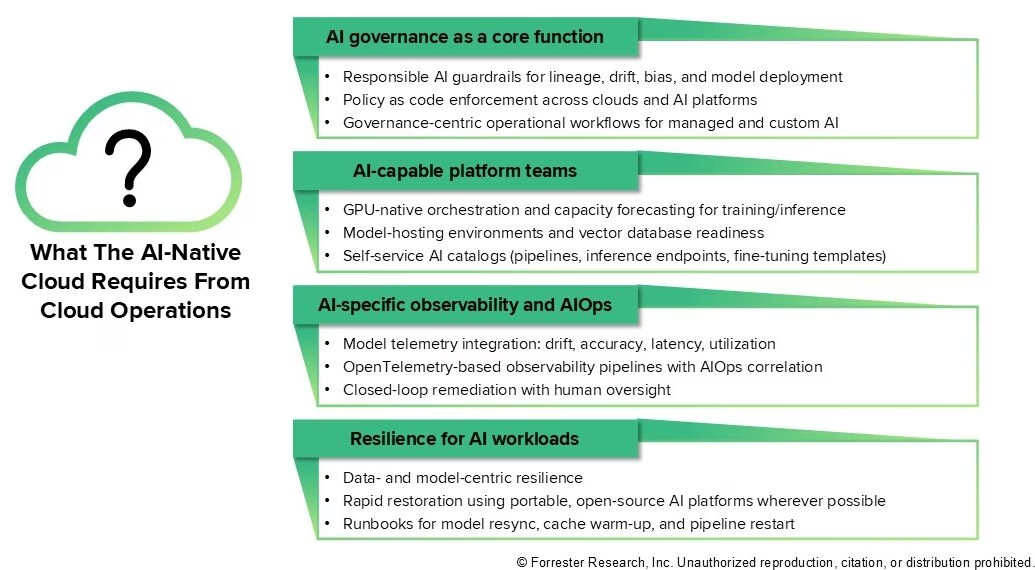
显然,单纯恢复“在线时间(uptime)”已不足以构成韧性。AI 时代的系统韧性(Resilience),核心指标是能否迅速将服务“恢复到可信状态(restore to a trustworthy state)”。在工程落地层面,这意味着故障恢复编排必须纳入全新的 AI 依赖项:包括模型权重与向量索引的重同步(model resynchronization)、RAG 与微调数据管道重启、语义缓存与 KV 缓存清理重建(cache restoration)、提示词模板与路由策略的受控灰度回滚(controlled rollback),以及面向异常 Agent 行为的熔断降级开关。
从 System Health 走向 Outcome Health:企业云运维的四步改造清单
综合 Forrester 给出的 AI 原生云运维重构指南(Retool Operations For The AI-Native Cloud),企业平台工程与 SRE 团队在落地 AI 应用规模化上线前,亟需补齐四项基础能力。第一,重定义 SLO 指标体系,在 P99 延迟与可用性之外,将输出合规率、幻觉拒答率与单次任务成本上限正式写入服务等级目标。
第二,建立预算与行为联动的实时熔断机制,当某类 Agent 任务出现异常重试或 Token 速率突增时自动降级至低成本小模型或人工审核队列,防止算力预算在无人值守夜间被刷穿。第三,将提示词模板、模型版本号、路由权重与外部工具 Schema 纳入与代码同等级别的 GitOps 版本控制与可回滚发布流。第四,打通云原生监控(Traces/Metrics)与业务结果看板,实现从“系统健康”到“结果健康(Outcome Health)”的彻底闭环。
📝 站长洞察 (Editor’s Insight)
Forrester 这份研究切中了当下企业落地大模型最隐蔽的痛点:过去十年我们用 Prometheus 和 K8s 把基础设施可用性做到了几个 9,但面对非确定性的 LLM 与多步智能体,SRE 团队手里的监控大盘几乎是“半盲”的。把“用 AI 修故障”和“监控 AI 本身”拆开定义非常精准,如果只把模型推理当成普通微服务去管,结果必然是接口 200 绿灯常亮、业务却在暗中亏损。真正成熟的平台工程团队,必须把 Prompt 变更、模型路由策略和 Token 预算水位线全部纳入 CI/CD 与可观测性一线告警,让韧性恢复不再只是重启容器,而是能秒级回滚到可信的推理状态。
AI云运维为什么不能只看系统在线?
因为AI服务可能在接口正常、延迟达标时,仍持续输出错误答案、发生模型漂移并静默消耗Token预算。只看进程和HTTP 200,无法发现质量、合规和成本问题,必须把结果健康纳入运维目标。
什么是面向AI的可观测性?
它不是用AI帮传统运维提效,而是把模型、提示词、智能体工具调用、输出质量、成本和业务结果纳入同一观测链路。目标是看清AI到底做了什么、花了多少、结果是否可信。
AI系统韧性和传统高可用有什么区别?
传统高可用关注服务是否恢复在线;AI系统韧性更强调能否恢复到可信状态。即使基础设施没宕机,也要能处理幻觉、漂移和不安全输出,并通过回滚、重评测和受控恢复恢复可信结果。
如何把结果健康纳入现有监控体系?
先把业务目标拆成可量化结果指标,如命中率、转化率、人工接管率,再把模型漂移、幻觉率、Token消耗映射到这些指标上,形成从系统到结果的分层告警与回溯链路。
怎样避免AI云运维静默烧钱?
建立按请求、按任务、按模型版本的成本归因,设置Token预算、异常峰值告警和自动降级策略;同时对高成本低收益链路做A/B对照,及时停掉“在线但无效”的调用。


