


💡 站外导读:如今的编程 Agent 已经能独立写出完整的 Web 应用、小游戏甚至借助 three.js 渲染宣传片,但它们始终存在一个感官盲区:既听不见自己配上去的音效是否刺耳、是否和画面剪辑对齐,也无法精准挑选和调试声音资产。刚刚登顶 GitHub 热门(5,493 Stars)的 MIT 开源项目 earshot 专门填补这一缺口,通过纯 CPU 离线 MCP 服务赋予 Agent“听觉验证与代码合成”双重闭环。
打破 Agent 感官盲区:不做黑盒生成,而是“参数化合成 + 本地听觉质检”
从 692 条公共域录音提取数值模型,彻底告别云端抽卡式音频 API
与 ElevenLabs Sound Effects 等依赖云端神经网络直接采样生成音频的商业方案不同,earshot 选择了一条高度工程化且可复现的路线:仓库本身不打包任何音频文件,而是将声音建模为可计算、可微调的物理合成代码与多频带数值特征。基础安装包仅依赖 numpy、scipy、soundfile、soxr 与 numba(安装体积约 350 MB),首次调用完成 Numba 循环编译并落盘缓存后,后续在本地 CPU 上即可毫秒级离线渲染。
在核心资产库层面,earshot 内置了涵盖 384 个家族、共计 922 套声音设计的庞大目录(Catalog),覆盖界面交互音、日常拟音、环境音床、游戏动作、8-bit 芯片音、鼓组与宣传片转场音效。其中 309 套写实声音并非直接回放录音,而是从 692 条 CC0 公共域录音中提取每 2 毫秒 56 个频带的能量分布、音调比例与立体声像参数,再配合新鲜噪声与物理参数重新渲染——这意味着 Agent 可以用“much bigger, darker whoosh”这类自然语言直接偏移明亮度、硬度、空间感等 8 个共享维度,生成永不重复且完全免版权费的商业可用音频。
听得见才能改得好:CLAP + AST 双耳模型与 20 个 MCP 工具全解析
从“listen”离线监听、“build”部件拼装到“sheet/critique”影片音画同步审查
当涉及“听懂现有声音”或“自主拼装库里没有的新音效”时,earshot 通过可选的 listen 扩展在纯 CPU 环境下加载两个固定版本号的 safetensors 开源模型(合计约 1.1 GB 下载、占磁盘 2.2 GB):负责文本-音频跨模态语义对齐的 CLAP 模型(laion/larger_clap_general),以及负责标签校验的 AudioSet 分类器(MIT/ast-finetuned-audioset-10-10-0.4593),支持通过 EARSHOT_OFFLINE=1 强制全离线运行。
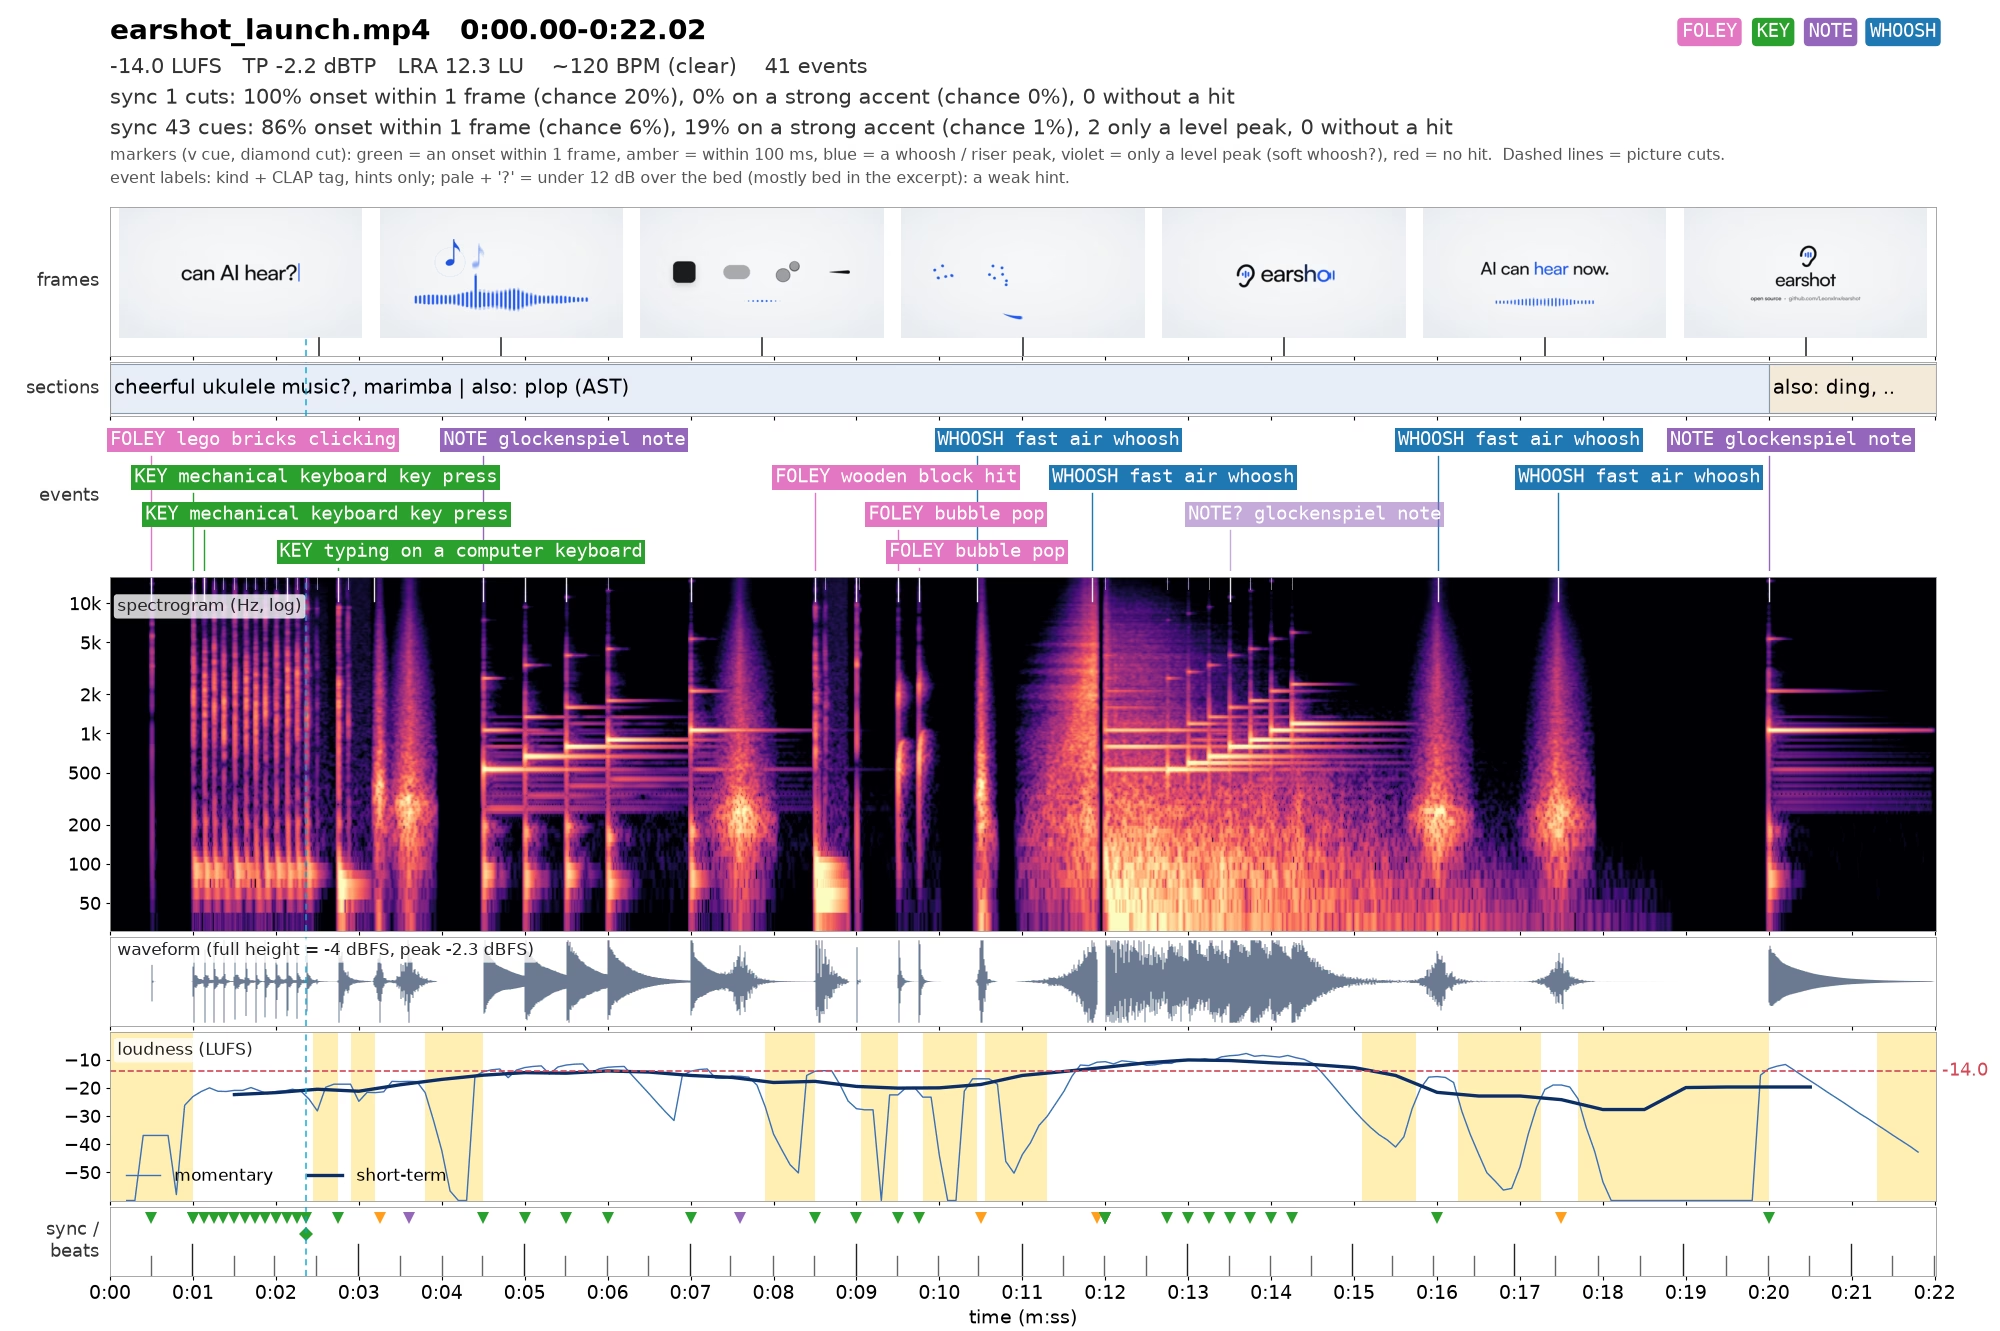
围绕这两个“耳朵”,earshot 向 Claude Code、Cursor 等智能体暴露了多达 20 个 MCP 工具以及两套 Agent Skills(skills/earshot 与 skills/real-sound)。Agent 不再需要每次启动 CLI 耗费 20~40 秒冷加载模型,而是以常驻进程随时调用 describe(语义描述与物理测量)、match/rank(多候选打分排序)、find(长录音精确定位)、realness(鉴真录音或代码合成)、timeline(逐秒音画事件转录)、sheet(输出带视频帧与频谱的审查大图),以及针对无库存声音的 build(配方拼装与 20 轮参数进化寻优)和 forge/fit(物理建模演进与录音转代码)。下表对比了 earshot 与传统云端 AI 音效方案的工程差异:
| 对比维度 | earshot (GitHub 5.5K Stars / MIT) | 云端 AI 音效生成服务 (如 ElevenLabs) | 核心工程影响 |
|---|---|---|---|
| 声音生成机制 | 物理建模 DSP 代码 + 692 条 CC0 录音参数化重建 | 云端黑盒扩散/音频自回归模型直接采样 | 结果 100% 确定可复现,支持精细参数变形 |
| 控制粒度与资产形态 | Python/JSON 配方,毫秒与音分级控制(–dur/–apex) | 仅靠自然语言提示词反复抽卡,产出静态音频文件 | 易于纳入 Git 版本管理与自动化批量微调 |
| 质量检测与听觉闭环 | 内置 CLAP+AST 双耳评审 + 削波/DC/LUFS 无模型审计 | 无内置听觉质检,需开发者人耳逐条试听筛选 | 让编程 Agent 可自主迭代修复音画同步缺陷 |
| 部署成本与数据隐私 | 纯 CPU 离线运行(基础 350MB / 听觉模型 2.2GB),零费用 | 按生成时长/字符数计费,音频需上传云端处理 | 适合涉密研发项目与高频自动化渲染管线 |
实测精度与工程边界:作者公布的硬核评测指标与 Goodhart 陷阱警示
earshot 最受开源社区赞誉的一点,在于维护者没有只放 Demo,而是在 VALIDATION 与 LIMITS 文档中公开了完整可复现的评测脚本与失误边界。在请求匹配理解测试中,五个开发集的首选准确率达 91.8%~96.8%(Top-3 达 95.9%~99.1%),在未见过目录的 220 条盲测请求中也能保持 69.1%~76.4% 的命中率;针对 125 条真实录音的 match 强匹配判定,大类准确率高达 98%,精确变体命中率为 61%。
在核心听觉判别任务上,realness 工具在跨声音家族留一法测试中取得了 0.92 的 ROC-AUC 成绩(真声误判合成率 6.7%、合成误判真声率 5.5%);针对 60 秒成片混音的 timeline 扫描,能检出 93% 的音效事件(包含背景音乐掩蔽下 89% 的轻音事件),且在普通笔记本 CPU 上仅需约 1.5 分钟。不过作者也坦承其现阶段局限:第一,make 无法生成人声说话、歌唱或复杂旋律;第二,在 5 组 forge 合成音与真实录音的盲测中,人类听众正确辨别出合成音的比例为 8/15(接近随机猜测),但作者明确警告演化搜索会针对 CLAP/AST 模型产生“古德哈特(Goodhart)过拟合”——即模型分数越高并不绝对代表人耳听感越好,必须辅以无模型物理指标(削波、咔哒声、LUFS 响度与频谱平衡)和人工最终试听把关。
落地实战指南:三步将 earshot 接入 Claude Code 本地音频工作流
对于正在用 AI 开发独立游戏、交互式 Web 动效或自动剪辑视频的开发者而言,接入 earshot 几乎零成本。第一步推荐直接安装 CPU 版 PyTorch 后拉取完整包:`pip install “earshot[listen,mcp] @ git+https://github.com/Leonxlnx/earshot”`(注意 PyPI 上的同名包并非本项目,必须从 GitHub 仓库直装),并运行 `earshot doctor –fetch` 预先拉取并校验模型缓存。
第二步,通过命令 `claude mcp add earshot –scope user -e EARSHOT_THREADS=3 — earshot mcp` 将常驻 MCP 服务挂载到 Claude Code,同时执行 `npx skills add Leonxlnx/earshot` 安装音频协作技能,让 Agent 清楚何时直接渲染 `make –set ui –format webm,mp3 –sprite sprite`(一键生成包含 17 个界面音效的 Web 音频雪碧图与 howler.js 映射),何时先调用 `sheet` 检查影片音画踩点偏差。配合内置 252 个零依赖代码音效库(`earshot kit init –preset launch`),团队无需采购昂贵商用版权库或云端配额,即可在本地跑通“写画面—配声音—听检修正”全自动化生产线。
📝 站长洞察 (Editor’s Insight)
earshot 是近期少见把“AI 感知闭环”打磨得极其克制又扎实的开源项目。它没有去卷一个参数更大、生成更玄学的端到端音频大模型,而是精准切中了当前 Coding Agent 最大的工程短板——盲人摸象式地给前端、游戏和代码视频配音。用 350MB 纯 CPU 代码合成解决“确定性与零成本渲染”,再用固定版本的 CLAP 与 AST 充当 Agent 的独立“监工双耳”,还极其诚实地把盲测表现和 Goodhart 过拟合风险写进文档。对于正在构建多模态代码流水线的工程师来说,这套把听觉校验封装成 MCP 工具与 Skill 的工程范式,比单纯调几个云端 API 更有长久借鉴意义。
earshot 适合编程 Agent 做什么?
它主要给编程 Agent 提供离线听觉能力:可做音效检索、匹配排序、长录音定位、音画同步审查,以及无库存声音的参数化合成与迭代优化,适合自动化音频工作流。
earshot 是云端音频生成吗?
不是。earshot 走的是纯 CPU 本地离线路线,核心是物理建模 DSP 代码和参数化重建,不依赖云端黑盒采样生成;同时支持本地听觉质检,便于隐私敏感场景使用。
earshot 的实测效果怎么样?
文中披露的请求匹配理解测试里,五个开发集首选准确率为 91.8%~96.8%,Top-3 达 95.9%~99.1%。作者同时在 VALIDATION 和 LIMITS 中公开了评测脚本与边界。
纯CPU离线部署怎么压住延迟?
优先把音频切片、特征提取和规则匹配做成流水线,减少大模型介入频次;常驻进程配合缓存与增量识别,通常比每次全量推理更稳,也更适合本地质检场景。
922套程序化音效该怎么接入工作流?
把音效库按事件、情绪、节奏三层标签化,再通过 MCP 暴露成可调用工具;让 Agent 先选场景再生成参数,能避免“听起来对但不贴任务”的问题。


