Prompt 语宙Prompt 语宙
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
阅读: 记住说了啥却忘了是谁说的!墨尔本大学重磅开源首个音频大模型记忆基准VoxMem:32K准确率不足40%、四维声学证据解耦与语音持久交互残酷真相全景深度拆解
Share
通知 阅读更多
Font Resizer字体
Font Resizer字体
Prompt 语宙Prompt 语宙
搜索 AIGC 资讯、Prompt 咒语与 AI 工具
  • 首页
  • 语宙 AI 导航
  • AIGC 资讯
    • AIGC 早报生成器Hot
    • 最新趋势
    • AI 工具
    • 热门资源
    • 强化 AI 学习
  • AI 绘图
    • Prompt 实战
    • AI 绘画教程
    • 模型精选
  • AI 图库
    • 人物
    • 展台场景
    • Banner
    • 游戏
    • 动物
    • 食物
    • 自然
    • 背景
    • 海报
    • 建筑
    • 室内设计
  • 出海数字营销宝典
  • AI 生图 Prompt
    • 写实人像
    • 产品与广告
    • 游戏资产与 3D
    • 界面与图标
    • 建筑与室内
    • 动漫与插画
    • 风景与自然
已有帐户? 登陆
  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.
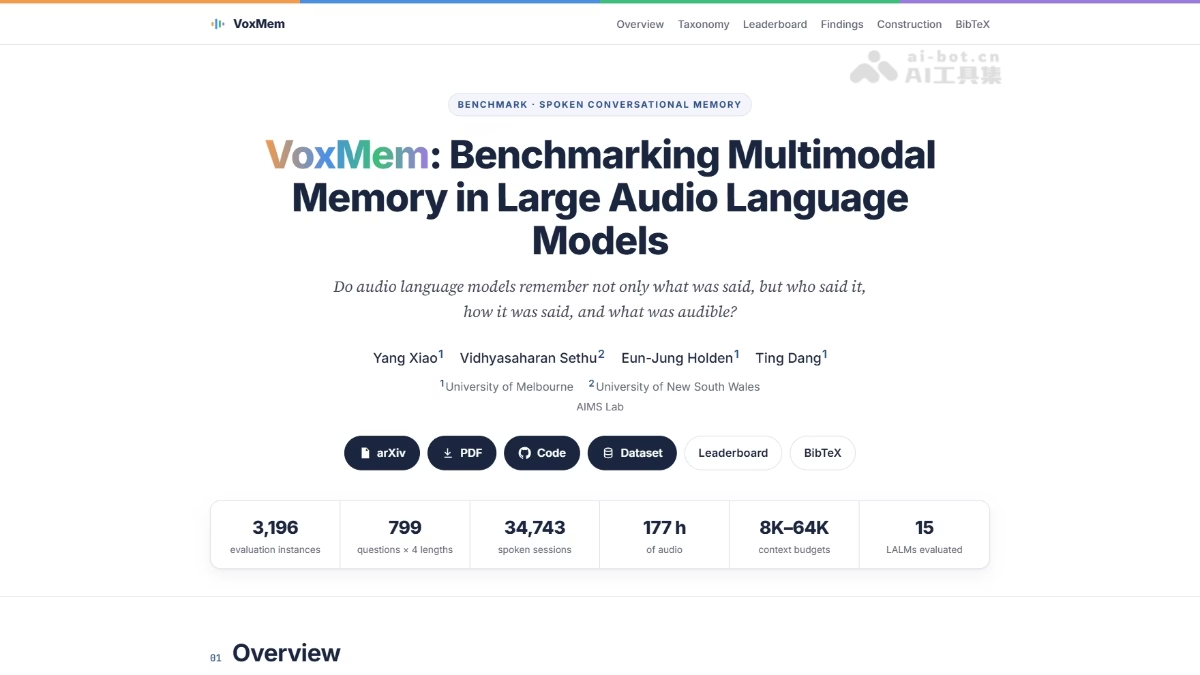
VoxMem 音频大模型长期记忆二维评测基准架构与声学证据多会话评测全景图
Prompt 语宙 > 最新趋势 > 记住说了啥却忘了是谁说的!墨尔本大学重磅开源首个音频大模型记忆基准VoxMem:32K准确率不足40%、四维声学证据解耦与语音持久交互残酷真相全景深度拆解
最新趋势

记住说了啥却忘了是谁说的!墨尔本大学重磅开源首个音频大模型记忆基准VoxMem:32K准确率不足40%、四维声学证据解耦与语音持久交互残酷真相全景深度拆解

Prompt 语宙研究院
最近更新: 2026年11月1日 下午4:06
VoxMem 副语言特征 声学证据 长程记忆基准 音频大模型
SHARE
⚡ Prompt 语宙 AI 导读 · 30 秒核心看点
  • VoxMem 首次把音频记忆拆成语义、说话人、副语言、环境声四类证据,避免只测文本转写。
  • 32K 跨会话测试中,15 个主流模型综合记忆准确率都没超过 40%,声学失忆问题被实测坐实。
  • 基准已 MIT 开源,支持主流 API 与私有模型接入,并提供拒答校验和双盲裁判流程。

💡 站外导读:当大语言模型的上下文窗口迈入百万 Token 时代,语音大模型也纷纷标榜具备超长音频输入能力。业界普遍盲目乐观地认为,只要给模型堆砌几十甚至上百 K 的音频 Token,实时语音陪伴智能体就能拥有永久记忆。然而,墨尔本大学与新南威尔士大学联合开源的音频原生记忆基准 VoxMem,用严密的数据戳破了这层技术泡沫:在 32K 跨会话历史测试下,包含 GPT-4o-Audio 在内的 15 个主流模型,综合记忆准确率无一突破 40%!大模型能勉强记住“说了什么文字”,却几乎彻底丢失了“是谁说的、用何种语气说的、背景环境发生了什么”等原生声学特征。
VoxMem 音频大模型长期记忆二维评测基准架构与声学证据多会话评测全景图

阅读目录
  • 一、长音频虚假繁荣背后的死穴:大模型正在遭遇“声学失忆”
  • 二、首创声学证据×记忆操作二维空间:15 个正交评测单元格深度解析
  • 三、工业级防作弊与变量解耦:三阶段数据流水线实测拆解
  • 四、开源架构与评测部署全流程指南
      • 📝 站长洞察 (Editor’s Insight)

一、长音频虚假繁荣背后的死穴:大模型正在遭遇“声学失忆”

在日常的人际交流与高拟真人机语音交互中,对话的完整含义绝不仅仅由字面词汇构成。一个疲惫叹气的肯定回答,其真实意图可能恰恰相反;而多人同时发言的会议中,把方案归属张冠李戴更会引发严重的协作灾难。然而,现有长上下文评测基准(如 LongMemEval)绝大多数局限于纯文本语境,忽视了转写无法恢复的音频原生特征。

研究团队发现,现有大型音频语言模型(LALM)在处理多轮长程对话时,表现出极强的“文本依赖型偏科”:

  • 字面语义记忆尚可:单纯依靠语音转文本后的语义信息检索,多数模型在浅层对话中尚能应付。
  • 说话人绑定极其脆弱:面对家庭多成员或客服多人插话场景,模型无法将历史声音指纹与特定发言内容长期绑定。
  • 副语言线索严重衰减:用户的语调起伏、犹豫、反讽以及情绪演变,在音频 Token 进入深层注意力层后被迅速稀释。
  • 环境声因果感知缺失:背景中的警报声、键盘敲击声或嘈杂环境音,往往被模型作为单纯噪声过滤,无法转化为时序因果记忆。

二、首创声学证据×记忆操作二维空间:15 个正交评测单元格深度解析

为了系统化、解耦化地度量音频大模型的真实记忆能力,VoxMem 提出了一套极其正交严谨的二维评测拓扑。该框架由 4 类声学证据 与 4 种核心记忆操作 交叉构成:

声学证据维度 (What to Remember) 对应物理特征与技术挑战 交叉记忆操作 (How to Use) 基准单元格覆盖
1. 语音语义 (Semantic) 说话的具体字面内容与核心事实 跨会话推理 (MSR)、时序追踪 (TET)、拒答 (AR) 3 个单元格 (排除纯文本IE)
2. 说话人身份 (Speaker) 音色指纹、说话人声学特征与跨会话身份绑定 单次抽取 (IE)、跨会话推理 (MSR)、时序追踪 (TET)、拒答 (AR) 4 个单元格
3. 副语言线索 (Paralinguistic) 语气、语调、情绪、疲劳度与犹豫停顿 单次抽取 (IE)、跨会话推理 (MSR)、时序追踪 (TET)、拒答 (AR) 4 个单元格
4. 环境声信息 (Acoustic Scene) 背景噪音、环境物理音效与声学场景上下文 单次抽取 (IE)、跨会话推理 (MSR)、时序追踪 (TET)、拒答 (AR) 4 个单元格

通过排除纯粹退化为单次文本检索的“语义 × 单次抽取(IE)”组合,VoxMem 精准锁定了 15 个有效评测单元格,彻底堵死了大模型依赖字面关键词投机取巧的作弊路径。

三、工业级防作弊与变量解耦:三阶段数据流水线实测拆解

为了确保测试结果的纯粹性,避免题目难度与上下文长度混杂,VoxMem 在数据工程上实施了严苛的 SRE 级控制:

  1. 防泄漏对话构造:对话双方在文本层面绝不出现任何提及说话人名字、语气形容词(如“我很生气”)或背景声的词汇。所有关键判别依据完全来自 TTS 合成的声学流。
  2. 声学特征精准注入:为每位模拟用户绑定固定声纹,通过风格控制器(Style Embedding)动态注入拟真语气,并在环境声轨道以恒定 10dB 信噪比 (SNR) 混合场景音效。
  3. 严格嵌套的历史长度控制:测试题目在 8K、16K、32K、64K 音频 Token 四档长度下,核心证据完全保持一致。长度的扩展纯粹通过追加不相干的填充会话与语义相近但取值不同的“强干扰会话”(Distractor Session)实现,使测试准确率的下降百分之百归因于“上下文长度对注意力的稀释”。

四、开源架构与评测部署全流程指南

VoxMem 代码库已遵循 MIT 协议完全开源,支持接入主流 API 模型(如 GPT-4o-Audio)以及私有权重部署的开源端侧音频大模型:

  • 环境部署与依赖安装:通过 GitHub 克隆仓库后,安装核心依赖库并载入 HuggingFace 音频解码驱动。
  • 冒烟测试与拒答机制校验:执行 run_voxmembench.py 跑通 8K 说话人基准子集,配合 score_voxmembench.py 核验模型在证据缺失时的拒答判断力(避免胡编乱造的幻觉生成)。
  • 双盲 LLM 裁判系统:引入不接触原始音频的第三方法官大模型,仅依据问题、标准答案事实与待测模型的输出文本进行开放式语义等价性判定,保证评分的客观与公正。

📝 站长洞察 (Editor’s Insight)

从 SRE 与多模态端到端系统架构的维度审视,VoxMem 的开源对当前大模型行业具有极其深刻的警示意义。目前绝大多数所谓“端到端语音大模型”,其内部表征实际上依然在早期浅层就把音频特征离散化并粗暴投射为类文本语义,导致音色、情绪与空间环境等高阶声学特征在深层 Transformer 中遭遇了毁灭性的信息熵增。如果无法在显存注意力机制中为声学特征建立具备长效持久力的专用 KV Cache 索引结构,仅凭盲目拉长音频输入上下文,永远无法孕育出真正具备拟人温度与持久记忆的生产级 Voice Agent。音频大模型研发必须从“转写语义狂热”彻底转向“原生声学保真”。

❓ 常见问题解答(FAQ)
VoxMem 主要测什么能力?

VoxMem 不是只测语音转文字,而是评估音频大模型对四类声学证据的长期记忆:语义、说话人、副语言线索和环境声,并考察单次抽取、跨会话推理、时序追踪与拒答能力。

为什么 32K 长音频准确率会这么低?

文章指出,模型在长上下文中会优先保留字面语义,却难以稳定绑定说话人身份、语气变化和环境声信息;随着历史长度增加,注意力被稀释,记忆准确率显著下降。

VoxMem 开源后怎么用来测模型?

代码库已按 MIT 协议开源,可接入 GPT-4o-Audio 等 API 模型或私有权重模型。流程包括环境部署、8K 子集冒烟测试、拒答机制校验,以及用双盲 LLM 裁判做语义等价评分。

🔬 语宙深潜追问 · 进阶实操拆解
32K历史下为何准确率仍低?

因为语音记忆不只是“存下来”,还要把说话人、时间、语义和声学线索解耦后再关联。长历史会放大检索噪声,模型若缺少结构化记忆层,越长越容易答非所问。

怎么搭建可复现的音频记忆评测?

先固定会话切分、说话人标注、问题类型和评分口径,再分别测检索、归因和跨会话一致性。最好把文本转写误差单独统计,否则很难判断问题出在ASR还是记忆模块。

🗳️ 读者观点微投票 · 您的实战立场是?
VoxMem暴露音频记忆短板,语音Agent该先补哪项?
🕸️ 语宙向量知识图谱 · 语义强关联深度内链
  • VoxCPM:面壁智能联合清华推出0.5B参数语音模型,实现业界顶尖零样本克隆与实时合成
  • Mistral AI重磅开源Voxtral语音模型:24B/3B版本全面超越GPT-4o,支持30分钟长音频转录与多语言实时理解
  • 攻克大模型失忆与幻觉!腾讯混元全面开源 Hy Memory 2.0:首创三层长程记忆架构,3B 专用模型反超 Opus 5 并打通 Cursor 等 10 大工具
  • VITA-Audio – 开源的端到端多模态语音大模型,低延迟、推理快
🌐 English Executive Summary — VoxMem: First Audio-LLM Memory Benchmark Exposes Sub-40% Long-Context Recall

The University of Melbourne (with UNSW) has open-sourced VoxMem, the first memory benchmark for audio foundation models, designed to test whether models truly remember “what was said” and “who said it” across sessions. In 32K cross-session history, 15 mainstream audio models—including GPT-4o-Audio—achieved under 40% combined memory accuracy, revealing a persistent long-audio “acoustic forgetting” bottleneck. VoxMem decomposes audio memory into four evidence types—semantics, speaker identity, paralinguistics, and environment sounds—and provides a reproducible evaluation workflow with refusal checks and double-blind judging, with MIT-licensed release supporting both public APIs and private models.

  • VoxMem measures audio memory beyond transcription by separating semantics, speaker, paralinguistics, and environment evidence.
  • Across 32K cross-session context, 15 mainstream audio models—including GPT-4o-Audio—stay below 40% accuracy.
  • MIT-open-sourced benchmark includes refusal validation and double-blind evaluation, supporting public and private model integration.
🏛️ Prompt 语宙研究院 · Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
📄 Markdown 纯净版
💡 这篇内容对您有启发吗?
📡 RSS 订阅✨ 提交 AI 工具 / 合作
🚀 Prompt 语宙 AI 创作者生态:探索 2,800+ 全球实用 AI 工具与高精度生图提示词咒语库
🧭 语宙 AI 导航 (ai.paooo.com)🎨 AI 生图 Prompt 库📚 核心专题导航⚡ AIGC 早报生成器
40天狂卷1000万下载、日活突破250万!Meta 个人代理 Muse 极速爆发:从泛对话到代行智能体,生态导流、留存模型与消费级 Agent 破局实测
欧盟急谈Anthropic引进”地表最强”网安大模型Mythos:AI安全攻防进入地缘政治博弈新阶段
单周狂吞 188 万亿 Token!全球大模型调用榜中国断层领跑 26 周:DeepSeek V4.1-Flash-1017 暴涨 800% 登顶全景深度拆解
回答完毕后暗中追加隐形指令!Anthropic披露Fable 5.5“自评估”机制:复用KV Cache算力开销低于2%、94%高危行为检出与暗中审判争议全景拆解
DeepSeek V4永久降价75%:碾压GPT-5.5与Claude Opus,登顶全球AI性价比之王
TAGGED:VoxMem副语言特征声学证据长程记忆基准音频大模型
分享
Email 复制链接 打印
Share
Prompt 语宙研究院 头像
ByPrompt 语宙研究院
Follow:
Prompt 语宙研究院(paooo.com Research)专注于前沿多模态大模型架构拆解、AI Agent 工作流评测、AIGC 提示词工程(Prompt Engineering)与全球高增长 AI 生产力工具实测追踪,致力于为中文开发者与创作者提供一手、可复现的深度技术洞察。
上一篇 StartLux Labs 开源决策模型家族 Startlux-Decision 官方架构与性能基准全景图 告别逐字生成算力浪费与黑盒幻觉!StartLux Labs重磅开源决策模型家族Startlux-Decision:单次前向毫秒级概率置信度、256K多模态长状态与Agent路由全景拆解
下一篇 Anthropic Claude Haiku 5.5 轻量级模型五档思考调节与电脑操作基准全景图 OSWorld狂飙至72.4%且综合成本狂降75%!Anthropic重磅发布新一代轻量旗舰Claude Haiku 5.5:五档自适应思考、百万长上下文与多子代理集群并行架构全景实测深度拆解
Ad image
Ad image

最近更新

Latent Space 对话 Black Forest Labs 核心创始人 Andreas Blattmann 与 Dustin Podell:从 FLUX 到视觉智能与世界动作模型
视觉智能为什么不能只靠静态图片?对话Black Forest Labs创始人:FLUX 3音画联合训练、扩散与自回归之争及世界动作模型全拆解
强化 AI 学习
Google 官方详解网站迁移至 CDN 如何避免爬虫流量激增打崩源站与误封 Googlebot 导致搜索掉收录
刚切上CDN源站反被爬虫打崩?Google官方拆解迁移翻车悖论:冷缓存雪崩、验证码误杀与预热止血指南
AI 工具
GitHub 正式上线 Repository insights 页面,集中展示 Copilot 代码审查采纳率与评论分类统计结果
AI代码审查到底有没有被采纳?GitHub上线Repository insights与repos-1-day API:四维信号、力度趋势及统计陷阱全拆解
AI 工具
Forrester AI 颠覆评估模型 17 大技术与服务品类分布图:呈现受颠覆、中立、争夺与加速四类市场象限及细分赛道数量
80%技术市场面临AI重塑冲击!Forrester拆解200+细分赛道颠覆矩阵:四大象限与Top 20合同采购谈判实战
最新趋势

相关推荐

2026 AIGC峰会前瞻:京东科技JoyInside如何定义“AI World”,让智能硬件成为家庭新成员?
AIGC 资讯最新趋势

2026 AIGC峰会前瞻:京东科技JoyInside如何定义“AI World”,让智能硬件成为家庭新成员?

Prompt 语宙研究院
AI World AIGC JoyInside 京东科技 智能硬件
Google 核心技术特色图
最新趋势

5000万行Lean 4形式化验证且微内核吞吐暴增90倍!Google重磅开放Antigravity /teamwork多智能体协作:解密Gemini 4 Argon长程推理、FarArray分布式内存与DuoDiscover算子优化全景深度拆解

Prompt 语宙研究院
Antigravity Gemini 4 Google Lean 4 Teamwork 多智能体 系统工程
微软与UC伯克利开源TokenEconomizer经验驱动AI编程智能体低成本推理控制架构
最新趋势

告别百万Token黑洞与死循环烧钱!微软联手UC伯克利开源TokenEconomizer:三大黑盒经验控制机制、调用成本直降30.9%且Pass@1反增全景深度拆解

Prompt 语宙研究院
Agent架构 AI编程智能体 SWE-Bench TokenEconomizer Token优化 UC伯克利 微软研究院
谷歌为苹果定制1.2万亿参数巨模型!Siri本地运行速度成最大悬念,下半年AI大战一触即发
AIGC 资讯最新趋势

谷歌为苹果定制1.2万亿参数巨模型!Siri本地运行速度成最大悬念,下半年AI大战一触即发

Prompt 语宙研究院
AI竞赛 Anthropic Claude Gemini OpenAI 本地部署 苹果Siri 谷歌定制模型
/ Prompt 语宙 /

探索生成式 AI 的无限创作潜能,一站式获取前沿 AIGC 资讯、高阶 Prompt 咒语与全球实用 AI 工具。

核心专栏

  • 语宙 AI 工具导航
  • EVA 视觉抠图工坊Hot
  • 出海数字营销宝典
  • AI 生图咒语灵感库
  • 24H 硅谷 AI 情报流

生态与服务

  • 语宙 AI 导航
  • 全部资讯
  • AI 生图咒语库
  • AIGC 早报生成器
  • 核心专题
  • 提交工具 / 合作

标签

开源大模型 AI智能体 AI办公效率 AI绘画提示词 OpenAI 大模型微调 Midjourney AI编程 stable diffusion AI视频生成 ChatGPT 3D与空间智能 HuggingFace AI音频与语音 RAG检索增强 Claude Flux AIGC Gemini 通义千问 Anthropic Llama Cursor DeepSeek Prompt AI Agent Kimi 智谱AI 具身智能 YouTube
Prompt 语宙Prompt 语宙
Follow US
© 2023–2026 Prompt 语宙 (paooo.com). HalfPX. All Rights Reserved.